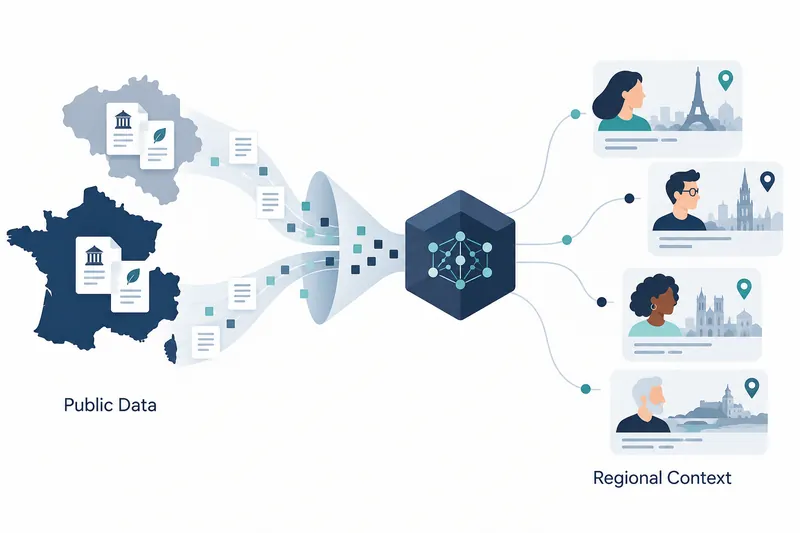
NVIDIAがフランスとベルギーの人口統計や地域的な背景を反映した仮想住民データと、それをモデルに追加学習させる手順を公開した。現地のサービス開発者は住民の設定と公式手続きの文書を併用し、地域ごとのルールや話し方を含む対話で公開モデルを調整できる。
1. 住民ペルソナという仮想の住民役の設定が、地域ごとの質問と回答を具体化する
NVIDIAはフランスのAIスタートアップPleiasとNemotron-Personas-Franceを作り、ベルギーのデータセットはPleiasおよびKU Leuvenと共同開発した。同社は両資料を、12か国を対象とする地域ベースのペルソナデータプログラムの一部として紹介した。
ペルソナは実在する人物ではなく仮想の住民である。フランスのデータの人物には、人口統計に合わせた年齢、自治体、職業、世帯情報があり、仕事や暮らしを描写するプロフィールも提供される。この設定によって利用者の質問表現が変わり、地域に適した回答も変わり得る。
ブログでは、パスポートの印紙代がフランス領ギアナでは43ユーロ、フランス本土では86ユーロという例を挙げた。地域の人口情報を対話の背景に結び付け、言語だけでなく実際の手続きの違いも学習データに含める方式だ。
ベルギーのペルソナはオランダ語、フランス語、ドイツ語、英語を網羅する。適用範囲を別の地域に変える際は、住民データと行動基準、レビュー担当者を入れ替え、同じ手順を活用するよう案内している。
2. データ生成からモデル比較まで続く手順
ワークフローという作業を順につなぐ手順は、目標とする行動と評価基準の設定から始まる。例えば回答対象、タスク、言語と口調、使用する公式情報、安全ルール、回答構造を契約のように定め、生成とレビューに共通して適用する。チュートリアルでは、任意の固定評価セットとして、よくある質問や例外・危険な状況を含む100~300件の人が作成した質問、または個人を特定できないよう処理した匿名化済みの運用パターンを提案する。
次に、地域や職業をまたいでペルソナ2,000件を選び、顧客の質問と回答を生成する。住民の設定は質問表現を多様にするために使い、回答の事実は一緒に提供した公式手続きの文書から取得する。生成した回答は別の採点モデルで検査し、まず8件を確認してから全体の生成を進める。
データ監査という誤りや情報漏えいを調べる段階では、形式の誤り、残った推論文、ペルソナの名前が露出する可能性を取り除く。残りは同じペルソナが学習用と検証用の両方に混在しないよう90対10に分割し、評価用データが学習に混ざるのを防ぐ。
例示モデルはNemotron 3.5 Lightningである。少数の調整変数だけを学習するLoRAで、別の小さな調整用重みであるアダプターを学習し、元のモデルに統合して回答を提供する。最後に固定の質問を元のモデルと調整モデルに同じように送り、回答を並べて読む。NVIDIAはエージェントよりも、人が直接評価する方法を勧めている。
git clone https://github.com/NVIDIA-NeMo/Nemotron.git
cd Nemotron
git checkout v0.2.0
uv sync --extra data-sdg --extra evaluator
uv run nemotron steps --help
注意:確認したリポジトリにブログが案内したサンプルフォルダは見つからなかった
ブログはチュートリアルを追うために `use-case-examples/french-public-service-assistant/` フォルダを使うよう案内し、その下に設定ファイルやスクリプト、sources、eval ファイルが置かれると示す。一方、資料収集時点の公開リポジトリ(main、sha 1c3e781)にはそのフォルダがなく、タグ `v0.2.0` にも存在しなかった。
サンプルの README を取得したところ `404: Not Found` が返った。したがって上記はブログに記載された手順であり、実行して検証したサンプルではない。同じ手順を試す前にフォルダの有無を確認する必要がある。
3. 事例評価で確認する変化
同社の発表によると、フランスのパスポートに関する質問への回答例で、元のモデルは公式文書にない郵送申請を案内した。調整モデルの回答例は、健康上の理由で移動が難しい場合、担当者の自宅訪問を依頼し、発行から3か月未満の診断書を提出するよう案内した。地域適応の評価で重視するのは流暢な文章より正しい申請経路であることを示す事例だ。
評価計画では、タスクの正確性、フランス語の品質、地域適合性、安全性、頑健性、一般的な指示に従う能力の維持という6領域を設ける。地域の表現が適切か、ペルソナの情報が回答に漏れていないかも調べる。
Pleiasは提携企業の脊椎ケアアシスタントLaminaに、フランスとベルギーを含むペルソナ資料を活用している。少数の実際の患者事例から、多様なプロフィールの学習対話を作り、患者のタイプ別に試験する用途だ。
4. 必要なリソースとデータ管理のトレードオフ
例示環境はPython 3.11~3.13、GPUコンテナの実行環境、Nemotronリポジトリへのアクセスを前提とする。ハードウェアはDGX Station GB300を1台、またはDGX Sparkを1台とする構成を示すが、他のNVIDIA GPUシステムにも調整可能としている。DGX SparkやホスティングAPIを使う場合、生成量は500~1,000件から始めるという推奨も含まれる。
地域ごとの回答の一貫性を高め、まれな事例をモデルが人工的に作る合成対話で補う一方、生成・採点APIの費用、GPUリソース、人によるレビューの時間が必要となる。公式手続きと行動基準の管理や再評価もワークフローに含まれる。NVIDIAは、ペルソナに基づくデータが公平性や適切な代表性を保証するわけではないと明らかにした。
地域に合わせた事後学習、つまり事前学習済みモデルを追加調整する過程の核心は、ペルソナで質問の幅を広げつつ、回答の根拠を公式手続きと人のレビューで確かなものにすることにある。