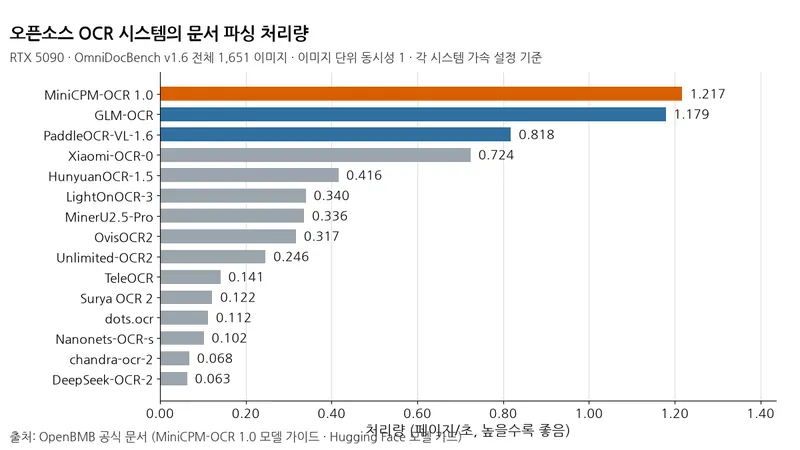
MiniCPM-OCR 1.0의 SDK는 PDF·이미지에서 본문·표·수식을 읽어 Markdown으로 바꾼다. 대량 문서의 처리 시간을 줄이려면 도구 선택뿐 아니라 한 번에 처리하는 이미지 수도 살펴볼 만하다. 오픈BMB가 공개한 공식 비교에서는 최상위 경쟁 시스템과의 처리량 차이보다 같은 모델의 동시성을 높였을 때 이득이 더 컸다.
측정 방법
비교는 NVIDIA GeForce RTX 5090 한 대에서 OmniDocBench v1.6 전체 1,651 이미지로 이뤄졌다. 각 시스템은 공식 SDK에 가속을 켠 기본 설정을 쓰고, 이미지 단위 동시성은 1이다. 한 페이지 안의 구역별 내용 인식은 병렬로 돌아가므로 동시성 1에서도 페이지 내부 작업은 서로 겹쳐 진행된다. 지표는 초당 처리한 페이지 수다.
표: MiniCPM-OCR 1.0의 이미지 단위 동시성별 처리량
조건: NVIDIA GeForce RTX 5090, OmniDocBench v1.6 전체 1,651 이미지
단위: 페이지/초
| 이미지 단위 동시성 | 처리량 |
|---|---|
| 1 | 1.217 |
| 2 | 1.613 |
| 4 | 1.888 |
| 6 | 2.031 |
| 8 | 2.133 |
결과
표: 오픈소스 OCR 시스템의 문서 파싱 처리량 비교
조건: NVIDIA GeForce RTX 5090, OmniDocBench v1.6 전체 1,651 이미지, 이미지 단위 동시성 1, 각 시스템 가속 설정, 오픈BMB 자체 측정
단위: 페이지/초; P95·P99 원문 단위 표기 없음
| 시스템 | 페이지/초 ↑ | P95 처리 시간 ↓ | P99 처리 시간 ↓ |
|---|---|---|---|
| MiniCPM-OCR 1.0 | 1.217 | 2.1 | 3.8 |
| GLM-OCR | 1.179 | 2.0 | 4.7 |
| PaddleOCR-VL-1.6 | 0.818 | 2.8 | 6.0 |
| MinerU2.5-Pro | 0.336 | 10.0 | 15.4 |
P95·P99는 샘플당 처리 시간의 95·99백분위수다. 오픈BMB가 측정한 표에서 앞선 두 시스템의 처리량 차이는 좁지만, P99 지연은 MiniCPM-OCR 1.0이 3.8로 GLM-OCR의 4.7보다 낮다. 처리량은 PaddleOCR-VL-1.6보다 약 1.49배, MinerU2.5-Pro보다 약 3.62배 높다. 표에는 대표 비교 대상만 남겼으며, 15종 전체 결과는 공식 원문에서 볼 수 있다.
이 테스트에서 동시성을 올리면 같은 시스템의 처리량은 다시 늘어난다. 이미지 단위 동시성 8에서는 2.133 페이지/초로, 동시성 1 대비 1.75배다. 다만 4에서 8로 두 배 늘려도 처리량은 1.888에서 2.133 페이지/초로 약 13%만 증가한다. 동시성을 계속 높인다고 처리량이 비례해서 늘지는 않으므로, 설정을 올릴수록 추가 이득을 확인해야 한다.
입력 압축과 가속 설계
MiniCPM-OCR 1.0은 MiniCPM-V 4.6 기반의 1.3B 파라미터 OCR 전용 모델로, SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합한다.
입력에는 잘라낸 이미지 조각을 최대 9개까지 사용하고 시각 토큰은 4배 압축한다. 오픈BMB는 비전 인코더 내부에서 토큰을 일찍 압축해 후속 인코딩 층의 계산량을 줄인다고 설명한다.
이미지 전처리에는 고해상도 이미지를 448×448로 썰고 저해상도 개요를 함께 쓰는 LLaVA-UHD v4 방식, 방향을 알아서 보정하는 자동 Upright, 해상도를 올리는 적응형 Upsize를 적용한다. 공식 설계 소개는 이 작동 방식을 설명하지만, 각 요소가 경쟁 시스템과의 처리량 차이를 얼마나 설명하는지 분리 측정한 결과는 제시하지 않는다.
가속 쪽에서는 DSpark가 작동한다. 작은 드래프트 모델이 토큰을 먼저 제안하고 메인 모델이 한 번에 검증하는 방식이다. 오픈BMB는 DSpark를 켜면 끈 경우보다 종단 간 처리 효율이 55% 개선된다고 밝혔다.
드래프트 모델 카드에 따르면 BF16 정밀도의 드래프트 헤드는 296,837,889 파라미터이며, 드래프트 레이어 5개에서 패스당 15개 토큰을 제안한다.
재현 가이드는 같은 메인 모델 가중치·데이터셋·하드웨어·SDK 설정에서 DSpark on/off만 바꿔 비교해야 한다고 명시했고, 그 비교 명령과 로그는 아직 추가되지 않았다.
고를 때 기준
서버 한 대로 밀어붙일 거라면, 해당 테스트에서 이미지 단위 동시성 8이 가장 높은 처리량을 냈으니 남는 메모리와 백엔드 수용량을 확인한 뒤 동시성을 단계적으로 올려 볼 만하다. 백엔드를 새로 고를 거라면 MiniCPM-OCR 공식 배포 예시는 vLLM·SGLang·llama.cpp·Ollama를 DSpark 기본 활성화로 구성하며 FlagOS는 DSpark 미지원이다. vLLM 기반 DSpark 배포 예시는 인스턴스당 동시성 상한을 --max-num-seqs 32로 잡는다. 드래프트 헤드와 메인 체크포인트는 같은 릴리스끼리 짝지어야 한다. 품질을 함께 볼 거라면 공식 수치는 Real5-OmniDocBench 93.68, OmniDocBench v1.6 96.51, olmOCR-Bench 82.7, OCRBench v2 54.7이다. 채점 방식에 따르면 Real5는 스캔·휘어짐 등 다섯 촬영 조건의 종합 점수를 균등 평균하고, OmniDocBench v1.6은 페이지 전체의 텍스트·수식·표 정확도를 종합한다. olmOCR-Bench는 텍스트 존재 여부·읽기 순서·표 관계 등의 규칙 검사 통과율을 범주별로 평균하며, OCRBench v2는 중국어·영어 과제별 지표를 집계한다. Wild-OmniDocBench 92.39 점수는 SDK 회전 보정 후 결과고, 각 벤치마크는 원래 척도를 유지한다. 실제 처리량은 페이지 내용·백엔드·동시성·하드웨어에 따라 달라진다. SDK 릴리스 안내에 따르면 SDK는 2026년 10월 28일 PyPI에 처음 올라왔고 빠른 시작 설정은 32개 인식 요청 동시도를 쓴다.
SDK 설치와 인식 서비스 실행을 마쳤다면, 저장소 루트에서 공식 문서 변환 예제로 PDF를 Markdown으로 바꿀 수 있다.
source .minicpm-ocr/bin/activate
minicpmvocr parse \
  --device cuda:0 \
  --server-url http://127.0.0.1:18499 \
  --model minicpm-ocr \
  --input doc.pdf \
  --output doc.md
이 표에서 최상위 경쟁 시스템과의 처리량 격차는 작고, 같은 모델의 동시성을 1에서 8로 높인 이득은 1.75배로 더 컸다.