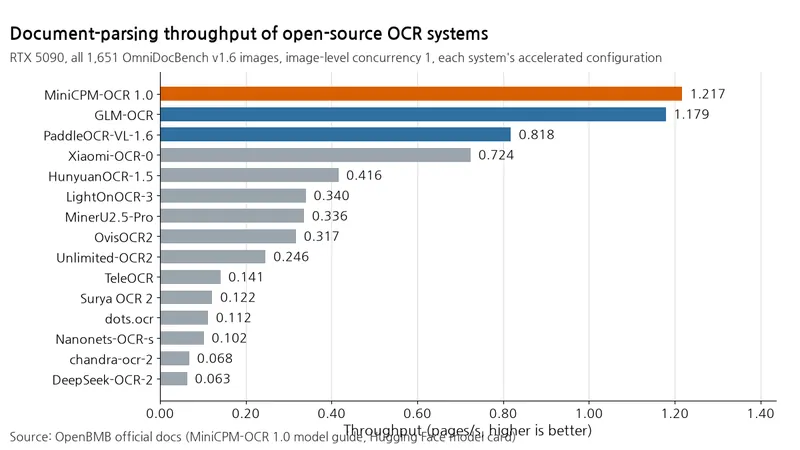
MiniCPM-OCR 1.0 的 SDK 可读取 PDF 和图像中的正文、表格及公式,并转换为 Markdown。要缩短批量文档的处理时间,除了选择工具,也值得关注同时处理的图像数量。在 OpenBMB 公布的官方对比中,提高同一模型并发数带来的收益,大于其与排名靠前的竞争系统之间的吞吐量差距。
测量方法
对比在单张 NVIDIA GeForce RTX 5090 上进行,使用 OmniDocBench v1.6 的全部 1,651 张图像。各系统均采用官方 SDK 开启加速的默认配置,图像级并发数为 1。单页内各区域的内容识别并行运行,因此即使并发数为 1,页内任务也会重叠执行。指标为每秒处理的页数。
表:MiniCPM-OCR 1.0 在不同图像级并发数下的吞吐量
条件:NVIDIA GeForce RTX 5090,OmniDocBench v1.6 全部 1,651 张图像
单位:页/秒
| 图像级并发数 | 吞吐量 |
|---|---|
| 1 | 1.217 |
| 2 | 1.613 |
| 4 | 1.888 |
| 6 | 2.031 |
| 8 | 2.133 |
结果
表:开源 OCR 系统的文档解析吞吐量对比
条件:NVIDIA GeForce RTX 5090,OmniDocBench v1.6 全部 1,651 张图像,图像级并发数为 1,各系统启用加速,OpenBMB 自行测量
单位:页/秒;原文未标注 P95、P99 的单位
| 系统 | 页/秒 ↑ | P95 处理时间 ↓ | P99 处理时间 ↓ |
|---|---|---|---|
| MiniCPM-OCR 1.0 | 1.217 | 2.1 | 3.8 |
| GLM-OCR | 1.179 | 2.0 | 4.7 |
| PaddleOCR-VL-1.6 | 0.818 | 2.8 | 6.0 |
| MinerU2.5-Pro | 0.336 | 10.0 | 15.4 |
P95、P99 是单个样本处理时间的第 95、99 百分位数。OpenBMB 的测量表中,前两个系统的吞吐量差距较小,但 MiniCPM-OCR 1.0 的 P99 延迟为 3.8,低于 GLM-OCR 的 4.7。其吞吐量约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5-Pro 的 3.62 倍。表中仅保留了代表性对比对象,全部 15 种系统的结果见官方原文。
在这项测试中,提高并发数可进一步增加同一系统的吞吐量。图像级并发数为 8 时,吞吐量达到 2.133 页/秒,是并发数为 1 时的 1.75 倍。但并发数从 4 翻倍至 8 时,吞吐量仅从 1.888 增至 2.133 页/秒,增加约 13%。持续提高并发数并不意味着吞吐量会成比例增长,因此每次调高配置都应确认额外收益。
输入压缩与加速设计
MiniCPM-OCR 1.0 是基于 MiniCPM-V 4.6 的 1.3B 参数 OCR 专用模型,结合了 SigLIP 视觉编码器与 Qwen3.5 语言模型。
输入最多使用 9 个裁剪图像块,并将视觉 token 压缩 4 倍。OpenBMB 表示,模型在视觉编码器内部提前压缩 token,以减少后续编码层的计算量。
图像预处理采用 LLaVA-UHD v4 方式,将高分辨率图像切成 448×448 的图块,并配合低分辨率概览图使用,同时应用自动校正方向的 Upright 和提高分辨率的自适应 Upsize。官方设计介绍解释了这些机制,但未提供分离测量结果,说明各因素对其与竞争系统之间吞吐量差距的贡献。
加速方面由 DSpark 发挥作用。小型草稿模型先提出 token,再由主模型一次性验证。OpenBMB 表示,开启 DSpark 后,端到端处理效率比关闭时提升 55%。
根据草稿模型卡,BF16 精度的草稿头包含 296,837,889 个参数,通过 5 个草稿层每轮提出 15 个 token。
复现指南明确要求,在主模型权重、数据集、硬件和 SDK 配置相同的情况下,仅切换 DSpark on/off 进行对比,但相关对比命令和日志尚未补充。
选择依据
若要在单台服务器上提高处理量,该测试中图像级并发数为 8 时吞吐量最高,因此可先确认剩余显存与后端承载能力,再逐步提高并发数。若要选择新后端,MiniCPM-OCR 官方部署示例中的 vLLM、SGLang、llama.cpp 和 Ollama 均默认启用 DSpark,而 FlagOS 不支持 DSpark。基于 vLLM 的 DSpark 部署示例使用 --max-num-seqs 32 设置单实例并发上限。草稿头与主检查点必须匹配同一发布版本。若同时关注质量,官方分数为 Real5-OmniDocBench 93.68、OmniDocBench v1.6 96.51、olmOCR-Bench 82.7、OCRBench v2 54.7。根据评分方式,Real5 对扫描、弯曲等五种拍摄条件的综合分数进行等权平均,OmniDocBench v1.6 则综合整页文本、公式和表格的准确率。olmOCR-Bench 按类别平均文本是否存在、阅读顺序及表格关系等规则检查的通过率,OCRBench v2 则汇总中文和英文各项任务的指标。Wild-OmniDocBench 的 92.39 分是 SDK 旋转校正后的结果,各基准均保留原有量表。实际吞吐量随页面内容、后端、并发数和硬件而变化。根据 SDK 发布说明,SDK 于 2026 年 10 月 28 日首次上传至 PyPI,快速入门配置采用 32 个识别请求的并发数。
安装 SDK 并启动识别服务后,可在仓库根目录按照官方文档转换示例,将 PDF 转换为 Markdown。
source .minicpm-ocr/bin/activate
minicpmvocr parse \
  --device cuda:0 \
  --server-url http://127.0.0.1:18499 \
  --model minicpm-ocr \
  --input doc.pdf \
  --output doc.md
该表中与排名靠前的竞争系统之间的吞吐量差距较小,而将同一模型的并发数从 1 提高到 8 后,吞吐量增至 1.75 倍,收益更大。