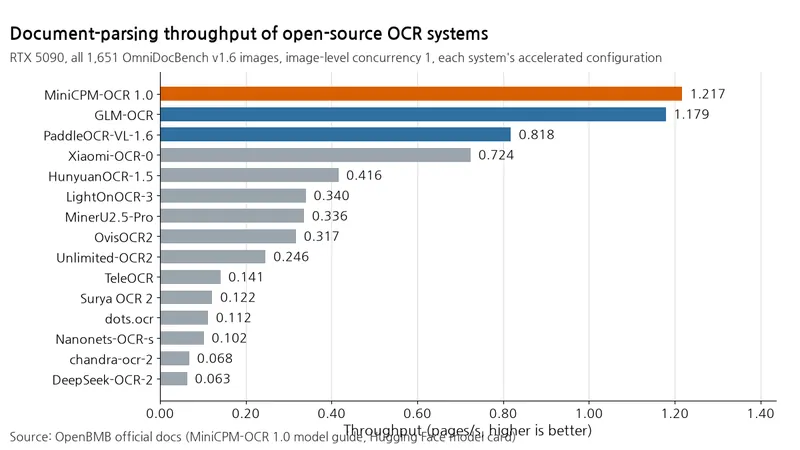
MiniCPM-OCR 1.0のSDKはPDF・画像から本文・表・数式を読み取り、Markdownに変換する。大量の文書の処理時間を短縮するには、ツールの選択だけでなく、一度に処理する画像数も検討に値する。OpenBMBが公開した公式比較では、最上位の競合システムとのスループット差より、同じモデルの同時実行数を増やしたときの効果のほうが大きかった。
測定方法
比較はNVIDIA GeForce RTX 5090 1台で、OmniDocBench v1.6の全1,651画像を使って行われた。各システムは公式SDKの高速化を有効にしたデフォルト設定を使い、画像単位の同時実行数は1とした。1ページ内の領域ごとの内容認識は並列に動くため、同時実行数1でもページ内部の処理は重なって進む。指標は1秒当たりの処理ページ数である。
表:MiniCPM-OCR 1.0の画像単位の同時実行数別スループット
条件:NVIDIA GeForce RTX 5090、OmniDocBench v1.6の全1,651画像
単位:ページ/秒
| 画像単位の同時実行数 | スループット |
|---|---|
| 1 | 1.217 |
| 2 | 1.613 |
| 4 | 1.888 |
| 6 | 2.031 |
| 8 | 2.133 |
結果
表:オープンソースOCRシステムの文書解析スループット比較
条件:NVIDIA GeForce RTX 5090、OmniDocBench v1.6の全1,651画像、画像単位の同時実行数1、各システムで高速化を設定、OpenBMBによる自社測定
単位:ページ/秒、P95・P99は原文に単位の記載なし
| システム | ページ/秒 ↑ | P95処理時間 ↓ | P99処理時間 ↓ |
|---|---|---|---|
| MiniCPM-OCR 1.0 | 1.217 | 2.1 | 3.8 |
| GLM-OCR | 1.179 | 2.0 | 4.7 |
| PaddleOCR-VL-1.6 | 0.818 | 2.8 | 6.0 |
| MinerU2.5-Pro | 0.336 | 10.0 | 15.4 |
P95・P99はサンプル当たりの処理時間の95・99パーセンタイルである。OpenBMBの測定表では上位2システムのスループット差は小さいが、P99遅延はMiniCPM-OCR 1.0が3.8で、GLM-OCRの4.7より低い。スループットはPaddleOCR-VL-1.6の約1.49倍、MinerU2.5-Proの約3.62倍である。表は代表的な比較対象に絞った。全15種の結果は公式原文で確認できる。
このテストでは同時実行数を上げると、同じシステムのスループットはさらに増える。画像単位の同時実行数8では2.133ページ/秒で、同時実行数1の1.75倍である。ただし4から8へ2倍にしても、スループットは1.888から2.133ページ/秒へ約13%しか増えない。同時実行数を上げ続けてもスループットが比例して増えるわけではないため、設定を上げるたびに追加の効果を確認する必要がある。
入力圧縮と高速化の設計
MiniCPM-OCR 1.0はMiniCPM-V 4.6ベースの1.3BパラメータのOCR専用モデルで、SigLIPビジョンエンコーダーとQwen3.5言語モデルを組み合わせる。
入力には切り出した画像片を最大9個使い、視覚トークンを4倍圧縮する。OpenBMBは、ビジョンエンコーダー内部で早期にトークンを圧縮し、後続のエンコーディング層の計算量を減らすと説明している。
画像の前処理には、高解像度画像を448×448に分割し低解像度の全体像も使うLLaVA-UHD v4方式、向きを自動補正する自動Upright、解像度を上げる適応型Upsizeを適用する。公式の設計紹介はこの仕組みを説明しているが、各要素が競合システムとのスループット差にどの程度寄与するかを分離測定した結果は示していない。
高速化ではDSparkが働く。小さなドラフトモデルが先にトークンを提案し、メインモデルがまとめて検証する方式である。OpenBMBは、DSparkを有効にすると無効時よりエンドツーエンドの処理効率が55%改善するとしている。
ドラフトモデルカードによると、BF16精度のドラフトヘッドは296,837,889パラメータで、5個のドラフト層で1パス当たり15個のトークンを提案する。
再現ガイドは、メインモデルの重み・データセット・ハードウェア・SDK設定を同じにし、DSpark on/offのみを変えて比較するよう明記している。その比較コマンドとログはまだ追加されていない。
選択の基準
サーバー1台で処理するなら、このテストでは画像単位の同時実行数8が最高のスループットだったため、空きメモリとバックエンドの処理容量を確認し、同時実行数を段階的に上げてみる価値がある。バックエンドを新たに選ぶなら、MiniCPM-OCRの公式デプロイ例はvLLM・SGLang・llama.cpp・OllamaでDSparkをデフォルトで有効にし、FlagOSはDSpark非対応としている。vLLMベースのDSparkデプロイ例は、インスタンス当たりの同時実行数上限を--max-num-seqs 32に設定する。ドラフトヘッドとメインチェックポイントは同じリリース同士で組み合わせる必要がある。品質も見るなら、公式スコアはReal5-OmniDocBench 93.68、OmniDocBench v1.6 96.51、olmOCR-Bench 82.7、OCRBench v2 54.7である。採点方法によると、Real5はスキャン・湾曲など5つの撮影条件の総合スコアを均等に平均し、OmniDocBench v1.6はページ全体のテキスト・数式・表の精度を総合する。olmOCR-Benchはテキストの有無・読み順・表の関係などのルール検査の通過率をカテゴリ別に平均し、OCRBench v2は中国語・英語のタスク別指標を集計する。Wild-OmniDocBenchの92.39はSDKの回転補正後の結果で、各ベンチマークは元の尺度を維持する。実際のスループットはページ内容・バックエンド・同時実行数・ハードウェアによって変わる。SDKリリース案内によると、SDKは2026年10月28日に初めてPyPIに公開され、クイックスタート設定は32件の認識リクエストを同時実行する。
SDKのインストールと認識サービスの起動が済んだら、リポジトリのルートで公式の文書変換例を使い、PDFをMarkdownに変換できる。
source .minicpm-ocr/bin/activate
minicpmvocr parse \
  --device cuda:0 \
  --server-url http://127.0.0.1:18499 \
  --model minicpm-ocr \
  --input doc.pdf \
  --output doc.md
この表では最上位の競合システムとのスループット差は小さく、同じモデルの同時実行数を1から8に上げた効果は1.75倍と、それを上回った。