LightOn이 10월 8일 OCR 모델 제품군 LightOnOCR-3를 공개했다. 0.8B·1B·4B 세 크기이며 Apache 2.0 라이선스다.
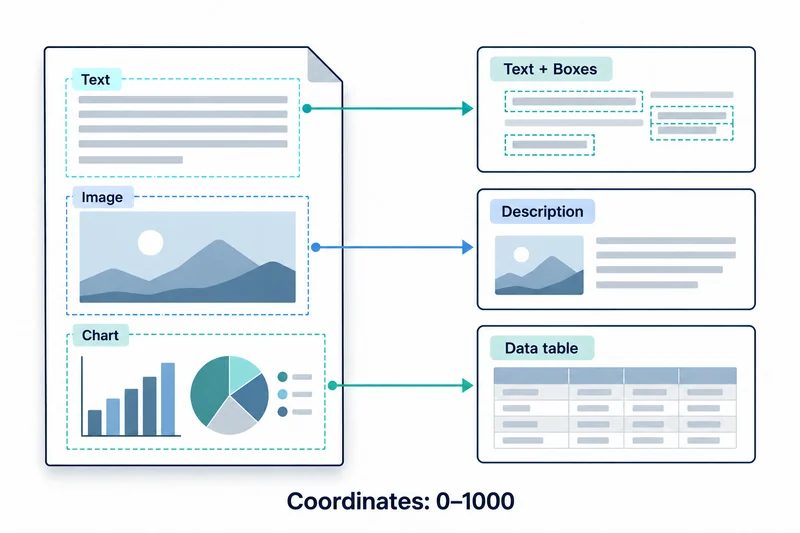
빈 텍스트 프롬프트를 주면 이전 세대처럼 페이지를 전사한다. grounding 프롬프트를 주면 각 블록 앞에 종류 라벨과 경계 상자가 붙고, 이미지 설명과 HTML 표로 옮긴 차트 데이터가 추가된다.
경계 상자(bounding box)는 영역을 감싸는 사각형 좌표다. LightOnOCR-3는 이 좌표를 페이지 기준 0–1000으로 정규화해 낸다.
텍스트 필드에서 영역 레코드로 바뀌는 출력
전사만 받던 시스템은 이제 영역 종류, 위치, 콘텐츠 유형을 함께 다룬다. 이미지 설명과 페이지에서 읽은 글자가 한 필드로 섞이면 둘을 다시 구분할 수 없다.
정규화 좌표를 픽셀 위치로 읽으면 강조 표시가 엉뚱한 곳에 놓인다. 페이지 크기와 렌더링 변환을 결과와 함께 저장하면 검색된 문장에서 원문 위치로 정확히 이동할 수 있다.
주의할 점: 학습 분포 밖의 지시와 늘어나는 출력
모델 카드는 빈 프롬프트와 grounding 외의 지시를 학습 분포 밖으로 규정한다. 4B는 thinking을 끈 상태로 학습·평가됐다.
4B의 페이지당 평균 출력은 grounding 1,433토큰, 일반 전사 1,158토큰으로 약 25% 많다. 자유 형식 지시를 덧붙이는 것은 문서화된 사용법이 아니다.
렌더링 해상도가 바꾸는 점수와 처리량
LightOn의 속도 비교는 같은 512페이지, 모델당 H100 한 대, 동일 플래그의 vLLM 0.30.0 조건이다. 0.8B와 4B는 400 DPI·5MP 상한에서 최고 olmOCR-Bench 점수를 냈고, 이는 페이지당 이미지 토큰 약 4,800개다.
긴 변을 1540px로 렌더링하면 이미지 토큰이 거의 3분의 2 줄고, 최대 처리량은 0.8B가 44%, 4B가 66% 오른다. 모델 카드 예제는 400 DPI로 렌더링한 뒤 긴 변을 2,048px로 줄인다.
세 설정은 서로 바꿔 쓸 수 있는 벤치마크 조건이 아니다. LightOn은 점수 산정 전에 출력 정규화를 적용했다고 밝혔다.
좌표가 필요한지부터 정하는 도입 순서
검색용 텍스트만 저장한다면 일반 전사가 기준선으로 남는다. 페이지 강조, 그림 설명, 차트 추출이 필요할 때 각 출력을 파서 규약에 따로 정의한다.
표가 파싱됐다는 사실은 추출한 값이 맞다는 증거가 아니다. 차트 값은 원본과 따로 대조한다.
평가 세트에는 작은 글자, 빽빽한 표, 여러 단, 시각 자료에 정보가 담긴 페이지가 들어간다. 고해상도 점수와 저해상도 처리량을 섞지 않고, 선택한 해상도에서 늘어난 출력까지 포함한 전체 요청을 비교한다.
이 기사에서는 문서 추론을 직접 실행하지 않았다.
LightOnOCR-3의 grounding은 텍스트를 더 주는 기능이 아니라, 좌표와 콘텐츠 유형을 지켜야 하는 새 출력 계약이다.