LightOnは10月8日、OCRモデル群LightOnOCR-3を公開した。0.8B・1B・4Bの3サイズで、ライセンスはApache 2.0だ。
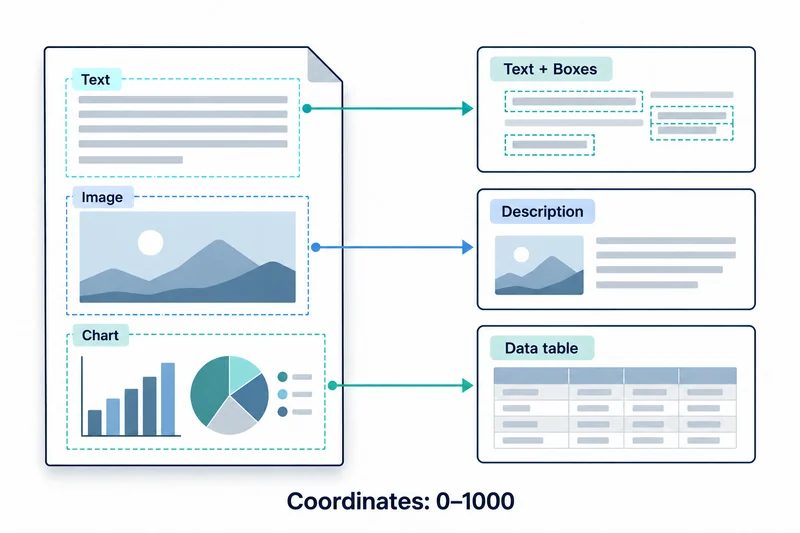
空のテキストプロンプトを渡すと、前世代と同じようにページを書き起こす。groundingプロンプトを渡すと、各ブロックの前に種類ラベルとバウンディングボックスが付き、画像説明とHTML表にしたチャートデータが加わる。
バウンディングボックス(bounding box)は領域を囲む矩形の座標だ。LightOnOCR-3はこの座標をページ基準で0–1000に正規化して出力する。
テキストフィールドから領域レコードに変わる出力
書き起こしだけを受け取っていたシステムは、領域の種類、位置、コンテンツの種類を一緒に扱うことになる。画像説明とページから読んだ文字が1つのフィールドに混ざると、両者をもう区別できない。
正規化座標をピクセル位置として読むと、ハイライトが違う場所に置かれる。ページサイズとレンダリング変換を結果と一緒に保存すれば、検索された文から原文の位置へ正確に移動できる。
注意点:学習分布外の指示と長くなる出力
モデルカードは、空のプロンプトとgrounding以外の指示を学習分布外と定めている。4Bはthinkingを無効にした状態で学習・評価された。
4Bのページあたり平均出力はgroundingで1,433トークン、通常の書き起こしで1,158トークンで、約25%多い。自由形式の指示を付け加えるのは文書化された使い方ではない。
レンダリング解像度が変えるスコアと処理量
LightOnの速度比較は、同じ512ページ、モデルごとにH100を1台、同じフラグのvLLM 0.30.0という条件だ。0.8Bと4Bは400 DPI・5MP上限で最高のolmOCR-Benchスコアを出し、これはページあたり約4,800画像トークンにあたる。
長辺1540pxでレンダリングすると画像トークンはほぼ3分の2減り、最大処理量は0.8Bで44%、4Bで66%上がる。モデルカードの例は400 DPIでレンダリングしてから長辺を2,048pxに縮める。
3つの設定は互いに置き換えられるベンチマーク条件ではない。LightOnはスコア算出の前に出力の正規化を適用したと説明している。
座標が必要かどうかから決める導入手順
検索用のテキストだけを保存するなら、通常の書き起こしが基準線として残る。ページのハイライト、図の説明、チャート抽出が必要なときに、各出力をパーサーの規約で個別に定義する。
表がパースできたことは、抽出した値が正しい証拠ではない。チャートの値は原本と別に照合する。
評価セットには、小さな文字、密な表、複数段組み、視覚資料に情報があるページが入る。高解像度のスコアと低解像度の処理量を混ぜず、選んだ解像度で増えた出力まで含めたリクエスト全体を比べる。
この記事では文書の推論を実際には実行していない。
LightOnOCR-3のgroundingはテキストを増やす機能ではなく、座標とコンテンツの種類を守る必要がある新しい出力契約だ。