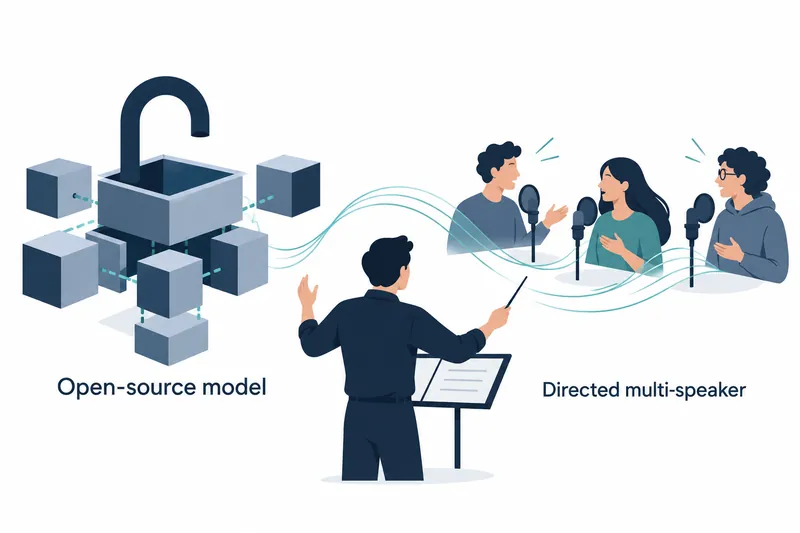
피시 오디오가 여러 사람이 등장하는 대본을 읽고, 말투 지시에 따라 다시 녹음하듯 고칠 수 있는 음성 합성 모델을 공개했다. 대화형 콘텐츠를 만드는 개발자는 목소리 생성과 연기 수정, 기존 음성의 부분 교체를 한 모델로 처리할 수 있다.
1. 전체 크기와 실제 연산량이 다른 모델
2026년 10월 13일 공개된 Fish Audio Drama 3는 정식판에 앞선 사전 공개 버전이다.
텍스트 처리부는 총 350억 매개변수 가운데 토큰마다 약 30억을 활성화하는 MoE 구조다. 작업마다 일부 전문가만 골라 계산하는 방식이다. 전체 모델을 담을 메모리와 매번 계산하는 규모는 구분해야 한다.
소리 생성부에는 이전 세대의 디코더를 대체하는 13층 디코더가 들어갔다.
2. 연출 수정과 구간 교체는 다르다
연출은 대본에 지시를 넣는 방식이다. [laughs]는 웃음이 들어갈 지점을 지정하고, <whisper>...</whisper>는 속삭일 구간을 감싼다. 자연어로 스타일이나 연출 메모를 적는 방식도 지원한다.
다음 대화 차례에서 수정 지시를 주면 원래 참조 음성과 직전 생성 결과를 문맥에 유지한 채 다시 생성한다. 릴리스 노트에 따르면 Step-Audio-Edit 평가에서 세 차례 수정 후 감정 정확도는 55.5%에서 58.2%, 스타일 정확도는 76.5%에서 81.8%로 올랐다. 이 결과는 해당 평가의 반복 수정 효과를 보여 준다.
기존 녹음의 단어나 문장을 삽입·삭제·교체하는 기능도 있다. 이때는 지정한 구간만 다시 생성하고 앞뒤 음성은 남긴다. 연기 전체를 다시 시도하는 기능과 달리 수정 범위를 한정하는 편집이다.
3. 실행 경로와 필요한 장비
깃허브 릴리스 태그는 v3.0.0-beta다. 모델 카드는 SGLang-Omni와 vLLM-Omni를 실행 경로로 제시한다. 아래는 전자를 설치한 뒤 서버를 띄우는 원문의 명령이다.
sgl-omni serve --model-path fishaudio/drama-3 --port 8000릴리스 노트가 제시한 최소 조건은 가중치의 수 표현 정밀도를 낮추는 FP8 형식에서 메모리 48GB 이상인 NVIDIA GPU다.
기존 S2-Pro도 같은 명령줄과 서버, 웹 화면에서 계속 지원한다. 저장된 모델 가중치와 설정인 체크포인트에서 설정을 읽어 모델 종류를 구분한다.
4. 처리량과 응답 지연은 함께 봐야 한다
모델 카드의 성능 표는 H200 한 장에서 Seed-TTS 영어 대본을 스트리밍 요청한 결과다. 요청마다 미리 인코딩한 참조 음성 하나와 전사문을 사용했고, 각 값은 네 번 실행한 평균이다. 샘플링 설정은 temperature 1.0, top_p 0.9, top_k 30, max_new_tokens 500이다.
음향 프레임은 소리를 나누어 생성하는 단위이며, 초당 생성량은 동시 요청 전체를 합산한 처리량이다. 동시 요청 1개에서는 초당 음향 프레임 166.7개를 생성했고 첫 음성이 나올 때까지 걸린 시간의 중앙값은 88.9밀리초였다. 동시 요청 16개에서는 초당 927.6프레임으로 처리량이 늘지만, 첫 음성 지연 중앙값도 210.1밀리초로 길어진다. 같은 조건의 비교에서도 처리량 증가가 응답 지연 감소를 뜻하지는 않는다.
별도의 H200 배치 비교에서는 동시 요청 256개에서 음성 파형 변환부를 모델과 같은 GPU에서 두 번째 GPU로 옮기자 처리량이 초당 2,422에서 4,160프레임으로, 첫 음성 지연 중앙값이 3,403에서 2,146밀리초로 바뀌었다. 높은 동시성에서 변환부가 포화돼 첫 음성이 대기열에서 기다리는 병목을 줄인 결과다.
이 비교는 변환부의 기본 GPU 할당으로 동시성별 1,088개 요청을 보내 서버 시작 6회의 평균을 냈다. 종료 프레임도 처리량에 포함해 앞 측정과 장비 배치·집계 조건이 다르므로 수치를 섞어 비교해서는 안 된다.
5. 제작 편의의 대가는 운영과 이용 조건 확인이다
한 텍스트에는 최대 16명의 화자를 넣을 수 있지만, 긴 글은 UTF-8로 인코딩했을 때 약 300바이트씩 나누며 한 조각에는 화자가 최대 3명만 들어간다. 생성 전에 조각 전체를 검증한다. 전체 대본의 화자 한도와 한 번에 처리할 조각의 한도는 다르다.
저장소에서 학습 스크립트와 미세조정 도구가 제거돼, 제공된 추론 기능과 직접 재학습하는 작업을 같은 지원 범위로 봐서는 안 된다.
공개 모델이라고 이용 조건 확인을 생략할 수는 없다. 릴리스와 모델 카드 본문은 피시 오디오 커뮤니티 라이선스를 가리키지만, 카드 메타데이터에는 피시 오디오 연구 라이선스에 해당하는 이름이 남아 있다. 두 표기가 달라 실제 적용 조건은 라이선스 파일에서 확인해야 한다.
이 모델의 핵심은 여러 화자의 연기와 수정 범위를 제어하는 데 있으며, 도입 판단에는 처리량뿐 아니라 장비와 학습 도구, 라이선스 조건을 함께 넣어야 한다.