LightOn 于 10 月 8 日发布 OCR 模型系列 LightOnOCR-3。共有 0.8B、1B、4B 三种规模,采用 Apache 2.0 许可证。
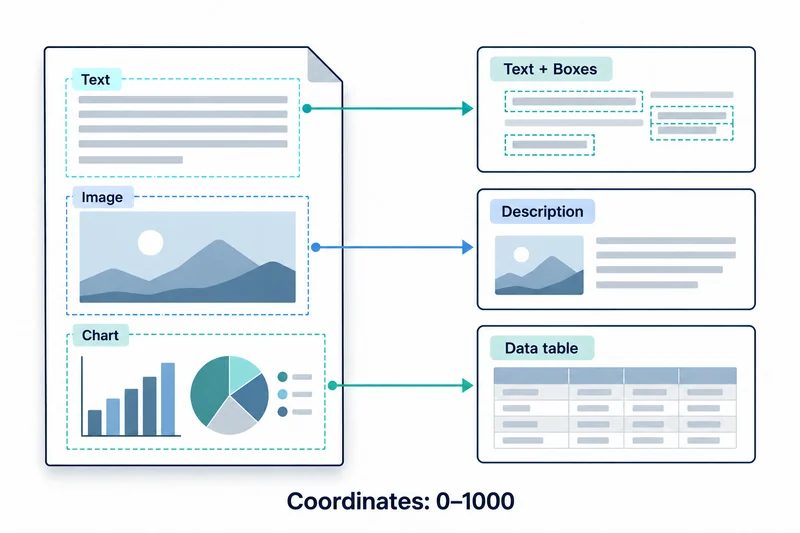
给出空文本提示时,模型像前几代一样转写页面。给出 grounding 提示时,每个块前会加上类型标签和边界框,并附加图像描述以及转成 HTML 表格的图表数据。
边界框(bounding box)是包围某个区域的矩形坐标。LightOnOCR-3 以页面为基准把坐标归一化到 0–1000 输出。
从文本字段变为区域记录的输出
原本只接收转写的系统,现在要同时处理区域类型、位置和内容类型。如果图像描述和从页面读出的文字被合并进同一字段,就无法再区分。
把归一化坐标当作像素位置读取,高亮会落在错误位置。把页面尺寸和渲染变换与结果一起保存,就能从检索到的句子准确跳转到原文位置。
注意事项:分布外指令与变长的输出
模型卡将空提示和 grounding 以外的指令界定为训练分布之外。4B 是在关闭 thinking 的状态下训练和评估的。
4B 每页平均输出为 grounding 1,433 token、普通转写 1,158 token,多出约 25%。附加自由格式指令不是文档记载的用法。
渲染分辨率如何改变分数与吞吐量
LightOn 的速度比较使用相同的 512 页、每个模型一张 H100,以及相同参数的 vLLM 0.30.0。0.8B 和 4B 在 400 DPI、5MP 上限下取得最佳 olmOCR-Bench 分数,约为每页 4,800 个图像 token。
以长边 1540px 渲染时,图像 token 减少近三分之二,峰值吞吐量 0.8B 提高 44%、4B 提高 66%。模型卡示例先以 400 DPI 渲染,再把长边缩到 2,048px。
这三种设置不是可以互换的基准条件。LightOn 表示在计分前对输出做了归一化。
先确定是否需要坐标的引入顺序
如果只存储可检索文本,普通转写仍是基线。需要页面高亮、图片描述或图表提取时,再在解析规约中分别定义每种输出。
表格能被解析,并不能证明提取的数值正确。图表数值需要另外与原件核对。
评估集包含小字号、密集表格、多栏以及信息位于图像中的页面。不把高分辨率分数和低分辨率吞吐量混在一起,而是比较所选分辨率下包含新增输出在内的完整请求。
本文没有实际运行文档推理。
LightOnOCR-3 的 grounding 不只是给出更多文本,而是一份必须保留坐标和内容类型的新输出契约。