Google이 10월 6일 공개한 EmbeddingGemma 2는 텍스트·코드·이미지·영상·음성을 같은 검색 공간으로 옮긴다. Google의 기본 768차원 MTEB Code v1 평가에서 점수는 전작 68.76에서 78.68로 9.92점 올랐다. 다국어 MTEB v2는 61.15에서 61.36으로 차이가 작았다.
코드 검색의 개선폭을 다른 자료에도 그대로 적용하기는 어렵다. 로컬 검색에서는 모델을 띄우는 메모리와 벡터를 쌓는 저장 공간도 서로 다른 부담이다.
모델 메모리와 벡터 저장량의 두 설정
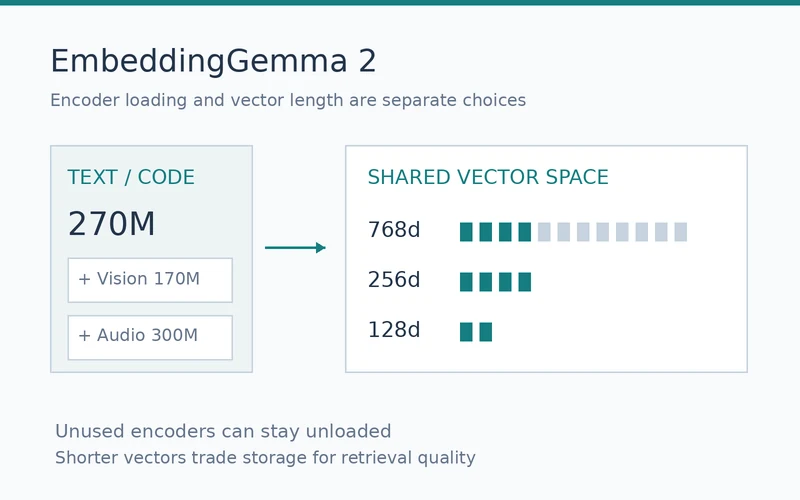
텍스트·코드만 처리할 때는 270M 파라미터를 사용하고, 시각·음성 인코더를 모두 더하면 740M이 된다. 추가 인코더도 같은 체크포인트의 검색 공간을 사용한다.
출력 벡터는 기본 768차원이며 512·256·128차원으로 줄일 수 있다. 같은 자료형과 벡터 수에서 256차원의 벡터 본문은 768차원의 3분의 1만 저장한다. 인덱스나 부가정보까지 같은 비율로 줄어드는 것은 아니다.
모델 카드는 256차원까지 품질 저하가 작지만, 128차원에서는 이미지·영상·음성 검색 품질이 크게 떨어진다고 설명한다. 개별 자료에서도 같은 결과가 나온다는 뜻은 아니다.
질의와 문서에 같은 벡터 차원을 적용하고, 잘라낸 벡터를 다시 정규화해야 한다. 모델 카드는 float16에서 잘못된 값이 나올 수 있어 bfloat16이나 float32를 안내한다.
EmbeddingGemma 2의 인코더 선택은 실행 메모리를, 차원 선택은 검색 저장량과 품질을 조절한다.