Googleが10月6日に公開したEmbeddingGemma 2は、テキスト・コード・画像・動画・音声を同じ検索空間に写す。Googleの既定768次元によるMTEB Code v1評価は前作68.76から78.68へ9.92ポイント上昇した。多言語MTEB v2は61.15から61.36と差が小さい。
コード検索の改善幅をすべての資料に当てはめることはできない。ローカル検索ではモデルを読み込むメモリとベクトルを蓄積する保存容量も異なる負担だ。
モデルメモリとベクトル保存量の二つの設定
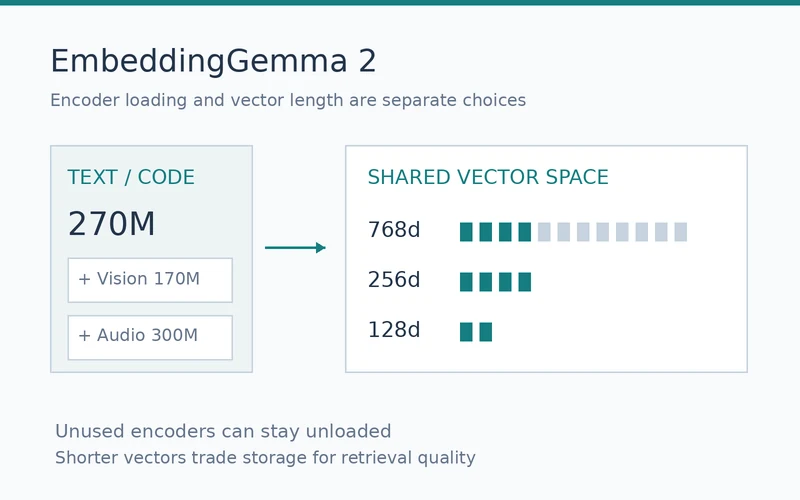
テキストとコードのみなら270Mパラメーターを使い、視覚と音声の両エンコーダーを加えると740Mになる。追加後も同じチェックポイントの検索空間を使う。
出力は既定768次元で、512・256・128次元に短縮できる。同じデータ型と本数なら256次元のベクトル本体は768次元の3分の1の容量だ。索引構造や付加情報まで同じ割合で減るわけではない。
モデルカードは256次元までの品質低下は小さい一方、128次元では画像・動画・音声検索が大きく劣化すると説明する。提供元の評価が個別のデータでも再現する保証はない。
クエリと文書のベクトル次元数をそろえ、短縮したベクトルを再正規化する必要がある。カードはfloat16で不正な値が生じ得るためbfloat16かfloat32を案内する。
EmbeddingGemma 2のエンコーダー選択は実行メモリを、次元数は検索保存量と品質を調整する。