Google于10月6日发布EmbeddingGemma 2,将文本、代码、图像、视频和音频映射到同一检索空间。Google报告的默认768维MTEB Code v1得分从前代68.76升至78.68,增加9.92分。多语言MTEB v2只从61.15升至61.36。
代码检索的改善不能直接推广到所有数据。对本地检索而言,加载模型的内存与长期保存向量的空间是两项不同成本。
模型内存与向量存储的两项设置
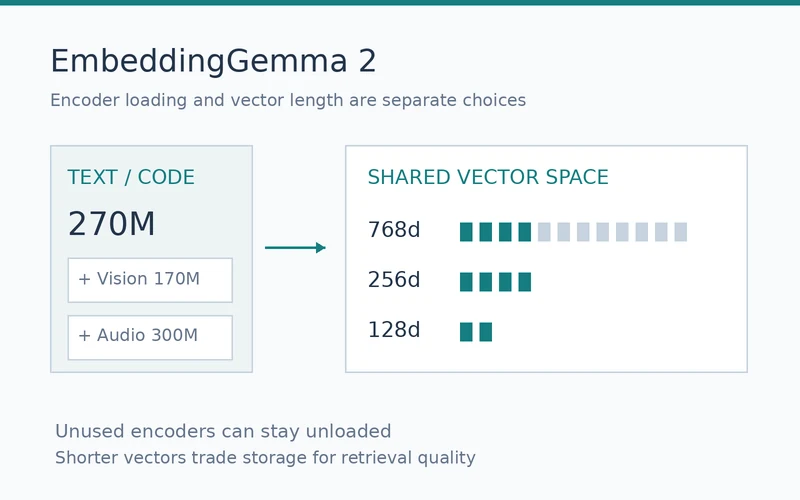
仅处理文本和代码时使用270M参数,加入视觉与音频编码器后为740M。可选编码器仍使用同一检查点的检索空间。
输出默认768维,还可缩至512、256或128维。数据类型和数量不变时,256维向量主体只占768维存储量的三分之一。索引结构和元数据不一定按相同比例缩小。
模型卡称缩至256维质量下降较小,但128维会明显降低图像、视频和音频检索质量。供应商的评估不保证每个数据集上都有同样结果。
查询与文档需要使用相同向量维数,截短后还需重新归一化。模型卡指出float16可能产生无效向量,因此建议使用bfloat16或float32。
EmbeddingGemma 2的编码器选择调节运行内存,维数选择调节检索存储与质量。