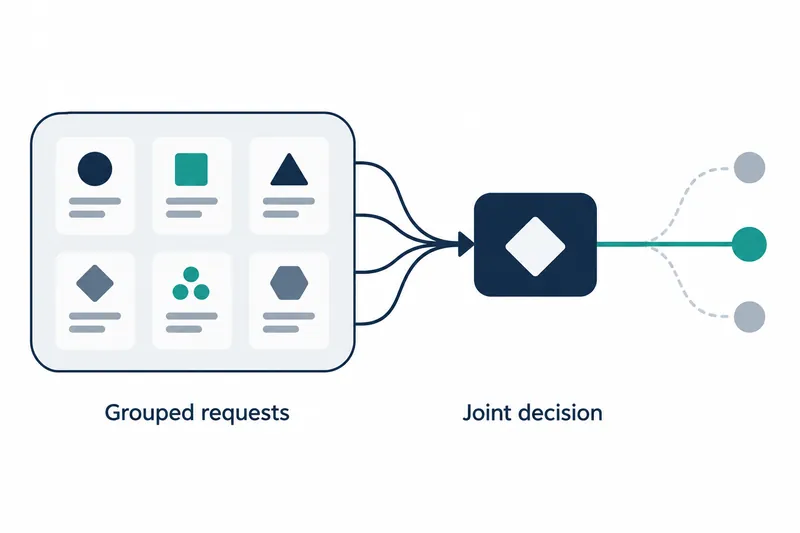
Perplexity가 같은 상황에 관한 여러 질문을 한 번에 판단하는 모델을 공개했다. 고객 문의 분류처럼 여러 속성을 판단하는 서비스를 만드는 개발자는 호출을 줄일 수 있지만, 질문을 어떻게 묶느냐가 답에도 영향을 준다.
1. 질문마다 따로 실행하지 않는다
이 판단 모델은 문장을 생성하는 대신 주어진 선택지에 대한 판단을 반환한다.
앞 버전은 질문마다 모델을 실행했다. 새 버전은 상황 설명 뒤에 질문들을 붙이고 질문별 표식 위치에서 답을 읽는다. 질문들이 같은 상황 설명을 펼쳐 놓고 서로의 내용도 참고하는 방식이다.
학습 데이터에는 테스트 세트와 중복을 제거한 일부 벤치마크의 공식 학습 분할과 다른 결정 데이터를 추가했다.
2. 점수 상승과 학습 범위를 함께 봐야 한다
공개 Decision Index 0.3의 자체 평가 종합 점수는 이전 모델 62.30에서 질문을 묶은 새 모델 68.09로 올랐다. 새 모델에서 질문을 따로 보내면 67.75다. 종합 점수는 범주별 단순 평균이 아닌 평가 모음의 가중치를 쓴다.
최대 1.6 MP 이미지를 쓰는 공개 Vision Decision Index 0.3은 이전 모델 73.22에서 새 모델 77.43으로 올랐다.
일부 평가 과제는 이제 학습 범위 안에 들어간다. 학습에서 제외한 결정 과제에서도 개선됐다는 설명은 있지만 세부 점수는 제시되지 않았다.
질문을 묶은 형식에서 별도 데이터로 맞춘 확률 보정 계수는 1.382다. 개발 세트 1,497개 질문에서 정확도는 91.3%이며, 예측 확률과 실제 정답률의 어긋남을 나타내는 ECE는 보정 전 0.033에서 0.014가 됐다. 학습에서 제외한 결정 데이터에서는 다소 과신하는 경향이 남아 ECE가 약 0.05였다.
3. 관련 속성은 묶고 독립 후보는 나눈다
같은 항목의 여러 속성을 판단할 때는 묶기가 유리하다. 같은 평가의 과제 점수에서 개별 요청 대비 묶음 요청은 복수 정답 선택 과제인 SATA-Bench에서 +11.3점, 후보 도구별로 질문하는 ToolRet에서 −4.8점이었다. 독립 후보끼리는 서로의 판단을 방해할 수 있다.
문서 순위 재조정 평가 모음인 BEIR에서는 상위 10개 결과의 순위 품질 지표인 nDCG@10을 썼다.
요청당 후보 문서 8개를 넣는 방식은 1개씩 넣는 방식보다, 여러 근거를 연결해야 하는 HotpotQA에서 +2.1점이었지만 전체 13개 데이터셋 평균은 −0.5점이었다. 후보 비교 자체가 도움이 되는지 먼저 구분해야 한다.
4. 빠른 실행도 기준 결과와 완전히 같지는 않다
한 요청 안의 질문 묶기와 별도 요청의 일괄 처리는 다르다. 고속 경로는 별도 요청들을 함께 처리할 때도 요청 사이의 독립성을 유지한다.
GB200 한 대에서 16비트 수치 형식인 BF16으로 측정했다. 평균 1,050토큰(모델이 입력을 세는 작은 단위)인 판단 평가 요청의 처리량은 길이순으로 묶고 빈칸을 채우는 기준 방식의 초당 9.1건에서 기본 고속 경로의 19.8건으로 늘었다. 개별 요청 지연 중앙값은 131밀리초에서 96밀리초로 줄었다. 기준 방식도 이미 길이순으로 요청을 묶으므로 단순 묶기만으로는 이득이 거의 없고, 속도 향상은 연산 컴파일과 CUDA 그래프를 통한 실행 재사용에서 나온다.
이익은 처리량과 지연 개선이지만 수치적 차이는 남는다. 같은 평가 모음의 요청 300개, 질문 2,324개에서 고속 경로와 기준 경로의 최상위 선택 일치율은 99.8%, 확률 차이의 절댓값 평균은 0.002였다. 기준 경로 자체도 일괄 처리와 개별 처리 사이에 선택 일치율 99.8%, 확률 차이의 절댓값 평균 0.0017을 보였다. 고속 경로의 차이는 기준 경로 자체의 처리 방식에 따른 변동과 비슷한 규모다.
5. 실행 환경과 입력 한도를 확인한다
pplx-decider-v1.2는 앞 버전과 같은 Qwen3.8-27B 기반이며, 텍스트와 최대 1.6 MP 이미지를 받는다.
직접 실행하려면 Python 3.12 이상과 CUDA GPU가 필요하다.
메모리는 BF16 가중치 약 52 GiB에 작업 공간이 추가로 든다.
README는 저장소가 비공개라며 접근 권한이 있는 Hugging Face 토큰 인증을 안내하지만, 모델 페이지 메타데이터는 private:false, gated:false로 표시한다. 원문 간 안내가 충돌하므로 실제 접근 제한 여부는 확정할 수 없다. 내려받은 뒤 기본 의존성을 설치하고, 고속 경로를 쓸 때는 전용 의존성도 추가한다.
다음은 원문의 기본 고속 경로 예시다. 모델 경로와 요청 목록을 준비한 뒤 실행한다.
from pplx_decider import Decider

decider = Decider.from_pretrained(checkpoint, fast=True)
decider.warmup()
responses = decider.decide(requests)
기본 길이 한도는 262,144토큰이지만 학습은 약 32k 토큰까지다. 이를 넘는 길이는 자체 과제로 검증해야 한다. 설정 한도를 넘으면 입력을 자르지 않고 질문을 나누며, 각 조각에 상황과 이미지를 다시 넣는다. 질문 하나도 들어가지 않으면 실행 전에 오류를 낸다.
서비스 실행 환경에는 질문 간 양방향 참조와 질문별 답 읽기를 지원하는 구현이 필요하다.
Ollama의 v0.40.7-rc0 사전 릴리스에는 이 모델의 지원 추가가 실렸다.
[변경 요청 작성자의 기록](https://github.com/ollama/ollama/pull/19072)에 따르면 그 기록 시점에는 실행 라이브러리인 MLX용 모델은 올라갔지만 배포 정보를 묶은 목록은 아직 만들지 않은 상태였다. 지원 코드와 배포 준비 상태를 구분해야 한다.
이 모델의 도입 판단은 최대한 많이 묶는 것보다, 서로 참고할 질문과 독립적으로 평가할 후보를 가르는 데서 시작해야 한다.