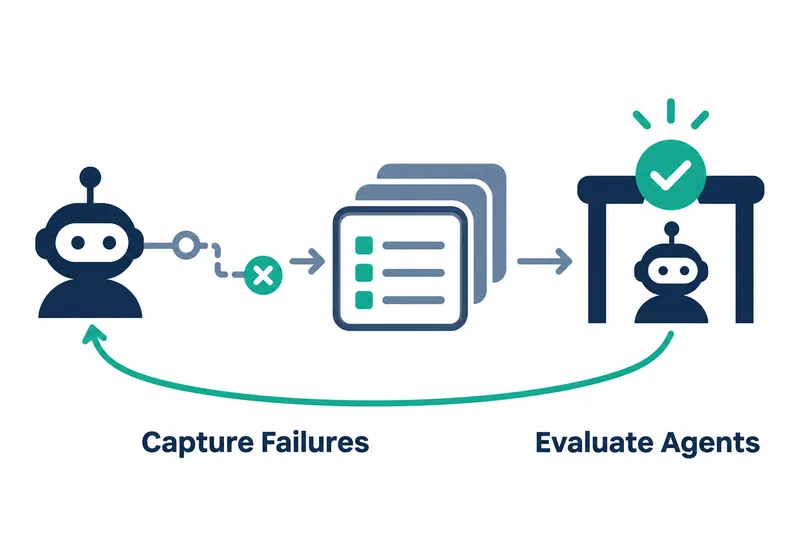
NVIDIAは実際のエージェントの実行記録から問題を見つけ、同じ失敗を再現する評価を作成した後、指示やツールの実行方法を修正する手順を公開した。エージェントの開発チームは、この流れで変更前後のタスク成功率とツール使用を確認しながら改善を繰り返せる。
1. 実行記録から修正すべき問題を見つける
汎用ベンチマークという性能の比較基準だけでは、特定の業務でエージェントが失敗した理由は分かりにくい。指示文やツール、メモリ、実行順序などをまとめた実行の枠組みであるハーネスにも原因があり得る。NVIDIAのチュートリアルは実行記録を調べて問題を定め、評価とハーネスの修正を一つのサイクルにまとめる。
例に使うのは架空の会社のHermes企業向けアシスタントだ。プロジェクトの状況を伝えるメッセージの下書きを求められたエージェントは、文章を作成した後、ユーザーの確認なしに送信ツールまで呼び出した。記録はエージェントが実際に取った行動を振り返る根拠となり、評価によって修正が同じ問題を防ぐかを確認する。
最適化の設計図では、NeMo Compass、NeMo Eval Author、NVIDIA NeMo Relayの三つのライブラリを使う。NeMo Compassは保存された実行記録と評価の根拠を分析し、繰り返される問題や評価の抜け、優先的に改善すべき領域を見つける。例ではリポジトリ内の記録42件と、エージェントに期待される行動を記したETHOS.mdを分析対象とした。
compass --config configs/trace-analyst.yaml \
--trace.filesystem.path traces/world-v3/production/insights.jsonl
Compassは異例の行動、ツールの使用方法、期待される行動との差を調べ、各発見を関連する実行記録の識別子と結び付ける。NVIDIAは、内部ベンチマークで数千件の実行記録に全シグナルを適用した結果、同様の分析を担ったコーディングエージェントが見逃した異常を発見したと述べた。
2. 発見した失敗を再現評価にする
NeMo Eval Authorは、コーディングエージェントが従う評価作成手順を、反復作業用の指針をまとめたスキルとワークフローとして提供する。対応形式はHarbor評価とNVIDIA NeMo Gym評価だ。Compassの分析結果、元の記録、期待される行動の文書、エージェントのリポジトリを併せて提供し、作成された評価が要件に合った動作を測定するかを検討する。
例ではコーディングエージェントが、返信の下書き作成に似た四つのHarbor評価を作成した。検証ロジックはユーザーの確認なしに送信ツールを呼び出したかを調べ、そのような実行を失敗と判定する。
実際の記録がまだなくても、要件やツール定義、既存のワークフローに基づいて評価を始められる。運用記録と既知の失敗が増えれば、評価セットも補強できる。
3. ハーネスを修正し結果を確認する
評価が整ったら、指示文やツール実行コードなど、エージェントのハーネスの問題箇所を修正する。例ではHermesのSOUL.mdを修正し、メッセージ作成や下書き準備の依頼は準備までに限定し、確認用の下書きを示した後、送信前に停止させた。準備ツールが実行に必要なトークンを返しても、ユーザーの同意を得たことにはならないという基準も明記した。
開発用タスク二つと、修正案を作るコーディングエージェントに非公開のホールドアウトタスク二つを、それぞれ三回実行した。会社の発表によると、指示文の変更後は両評価セットとも合格回数が増え、ツール呼び出しが減った。
表:Hermesの指示文変更前後の評価結果
条件:Hermes企業向けアシスタント、評価セットごとにタスク2件 × 3回実行、ホールドアウトタスクは修正提案エージェントに非公開
| 評価セット | 変更前の合格/実行 | 変更後の合格/実行 | 変更前のツール呼び出し(回) | 変更後のツール呼び出し(回) |
|---|---|---|---|---|
| 開発用 | 3/6 | 6/6 | 10 | 6 |
| ホールドアウト | 4/6 | 6/6 | 28 | 15 |
非公開のタスクでも結果を確認すれば、修正が開発用事例だけに合わせられていないかを検討できる。NVIDIAは、両評価セットが改善したときに変更を採用し、結果が不明確だったり他の動作が悪化したりした場合は、新たな実行記録で分析を繰り返すよう提案している。
修正後の実行記録を再分析すると、Compassは確認なしの送信問題を報告しなくなった。代わりに、答えを見つけても検索した根拠で応答を裏付けられない問題を発見し、次の評価と修正の対象とした。
4. エンジニアリングエージェントでも品質と効率を測る
NVIDIAは、ダッソー・システムズのエンジニアリング支援エージェントLEOが、自動車のドア設計の変更を提案し、シミュレーションで試す事例も紹介した。Compassは、ツールに渡す入力値であるQueryModelの引数を所定のオプション領域外に配置したため、空のエラーメッセージが出てエージェントが復旧できないという反復的な問題を発見した。
コーディングエージェントが、誤って配置された引数などを検出する検証段階を追加すると、会社の発表によると、不正なツール呼び出しは142回から0回に減った。精度は変わらず、他のシナリオでも性能低下は観測されなかった。
このチュートリアルは報告された結果を引用している。紹介された初期の実行は人の介入なしに約12時間続き、六つの試験シナリオでドア設計タスクの総合評価スコアが相対値で28%改善し、実行当たりのツール呼び出しは35%減少した。
この流れは、モデルを変更しなくても指示とツールの検証を見直すことで、タスク品質と実行効率を共に改善できる余地を示している。一方で、実行記録の収集や評価事例の拡充、ホールドアウト事例と他の動作の性能低下の有無を管理する、エンジニアリング上の負担も生じる。
実行記録を再現可能な評価に変えれば、エージェントの失敗を修正可能なハーネスの問題に結び付けられる。