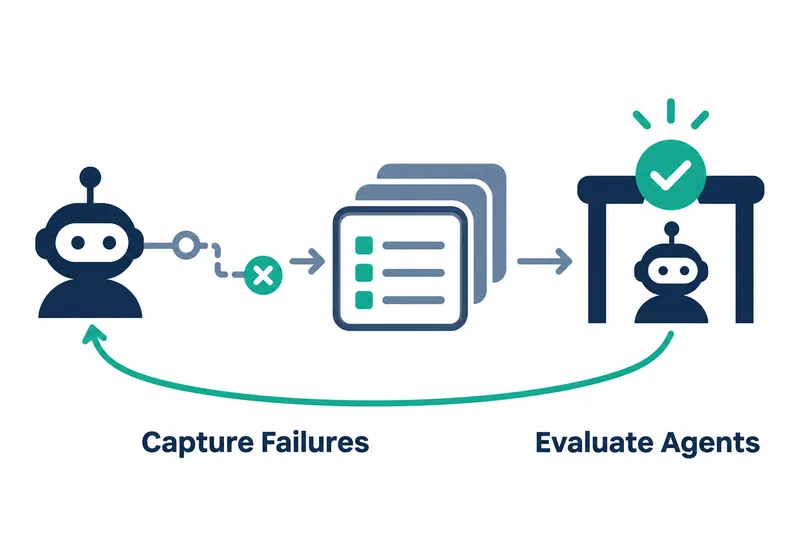
NVIDIA公布了一套流程:从真实智能体运行记录中发现问题,构建能复现相同失败的评估,再修改指令或工具执行方式。智能体开发团队可借此对比修改前后的任务成功率和工具使用情况,持续迭代改进。
1. 从运行记录中寻找待修复的问题
仅靠通用基准这类性能比较标准,很难判断智能体为何在特定业务中失败。原因也可能在于运行框架,即整合指令、工具、记忆和执行顺序等要素的执行环境。NVIDIA的教程通过检查运行记录确定问题,并将评估与运行框架修改整合为一个循环。
示例采用一家虚构公司使用的Hermes企业助手。用户要求起草项目进展消息,智能体写完后却未经用户确认便调用了发送工具。记录为回溯智能体的实际行为提供依据,评估则用于检查修改能否防止同样的问题。
优化蓝图使用NeMo Compass、NeMo Eval Author和NVIDIA NeMo Relay三个库。NeMo Compass分析已保存的运行记录和评估依据,寻找反复出现的问题、评估空白及优先改进领域。示例分析了仓库中的42条记录,以及描述智能体预期行为的ETHOS.md。
compass --config configs/trace-analyst.yaml \
--trace.filesystem.path traces/world-v3/production/insights.jsonl
Compass检查异常行为、工具使用方式及其与预期行为的差异,并将每项发现关联到相关运行记录的标识符。NVIDIA表示,在内部基准中对数千条运行记录应用全部信号后,发现了负责类似分析的编码智能体遗漏的异常。
2. 将发现的失败转化为复现评估
NeMo Eval Author通过技能和工作流提供编码智能体可遵循的评估编写流程,其中技能是执行重复任务的指引集合。支持的格式为Harbor评估和NVIDIA NeMo Gym评估。将Compass分析结果、原始记录、预期行为文档与智能体仓库一并提供,再检查生成的评估是否衡量了符合要求的行为。
示例中,编码智能体创建了四个与起草回复类似的Harbor评估。验证逻辑检查是否未经用户确认便调用发送工具,并将此类运行判为失败。
即使尚无实际运行记录,也可以根据需求、工具定义和现有工作流开始评估。随着生产运行记录和已知失败增多,评估集也可不断补充。
3. 修改运行框架并检查结果
评估就绪后,便修改指令或工具执行代码等智能体运行框架中的问题点。示例修改了Hermes的SOUL.md,规定要求撰写消息或准备草稿时只能完成准备工作,并须展示供审阅的草稿,在发送前停止。还明确指出,即使准备工具返回了执行所需的令牌,也不代表已获用户同意。
对两个开发任务和两个向负责修改的编码智能体隐藏的留出任务,各运行三次。据该公司公布的数据,指令修改后,两个评估集的通过次数均增加,工具调用均减少。
表:Hermes指令修改前后的评估结果
条件:Hermes企业助手,每个评估集2个任务 × 运行3次,留出任务不向提出修改方案的智能体公开
| 评估集 | 修改前通过/运行 | 修改后通过/运行 | 修改前工具调用(次) | 修改后工具调用(次) |
|---|---|---|---|---|
| 开发 | 3/6 | 6/6 | 10 | 6 |
| 留出 | 4/6 | 6/6 | 28 | 15 |
检查隐藏任务的结果,有助于判断修改是否仅针对开发案例。NVIDIA建议,只有两个评估集均有改善时才采纳修改;若结果不明确或其他行为变差,则利用新的运行记录重复分析。
再次分析修改后的运行记录时,Compass不再报告未经确认便发送的问题。但它发现,智能体即便找到了答案,也未能用检索到的依据支持回复,于是将其列为下一轮评估和修改的对象。
4. 同样衡量工程智能体的质量与效率
NVIDIA还介绍了达索系统工程辅助智能体LEO提出汽车车门设计变更并通过仿真测试的案例。Compass发现一个反复出现的问题:QueryModel的参数,即传给工具的输入值,被放在指定选项区域之外,导致出现空错误消息,智能体也无法恢复。
编码智能体增加了检测参数位置错误等问题的验证步骤后,据该公司公布的数据,错误工具调用从142次降至0次。准确率保持不变,其余场景也未观察到性能下降。
该教程引用了报告的结果:所介绍的初始运行在无人干预的情况下持续了约12小时;在六个受测场景中,车门设计任务的整体评估分数相对提升28%,每次运行的工具调用减少35%。
这一流程表明,即使不更换模型,也有望通过修改指令和工具验证,同时改善任务质量与执行效率。但这也带来了工程负担,包括收集运行记录、扩充评估案例,以及监控留出案例和其他行为是否出现性能下降。
将运行记录转化为可复现的评估,就能把智能体失败关联到可修复的运行框架问题。