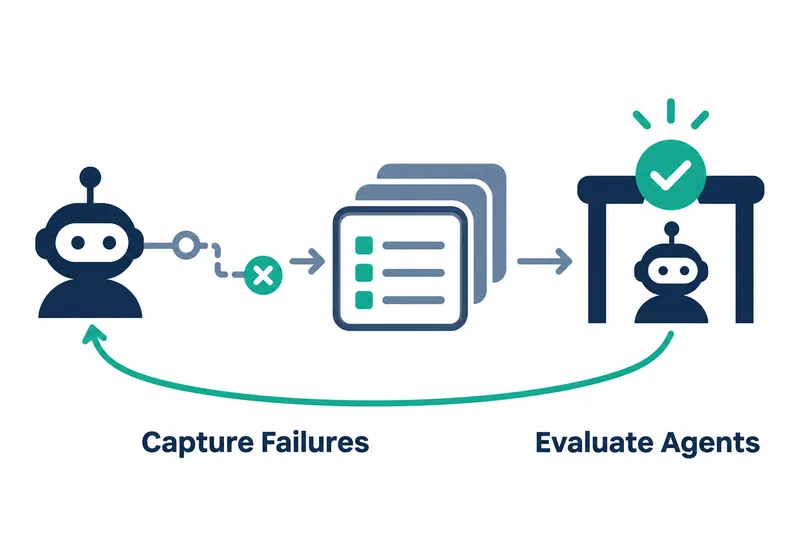
NVIDIA는 실제 에이전트 실행 기록에서 문제를 찾고, 같은 실패를 재현하는 평가를 만든 뒤 지시나 도구 실행 방식을 고치는 절차를 공개했다. 에이전트를 만드는 개발팀은 이 흐름으로 변경 전후의 작업 성공률과 도구 사용을 확인하며 개선을 반복할 수 있다.
1. 실행 기록에서 고칠 문제를 찾는다
범용 벤치마크, 성능을 견주는 비교 기준만으로는 특정 업무에서 에이전트가 왜 실패했는지 알기 어렵다. 지시문과 도구, 메모리, 실행 순서 등을 묶은 실행 틀인 하네스에도 원인이 있을 수 있다. NVIDIA의 튜토리얼은 실행 기록을 조사해 문제를 정하고, 평가와 하네스 수정을 한 사이클로 묶는다.
예시는 가상의 회사에서 쓰는 Hermes 기업용 어시스턴트다. 프로젝트 현황 메시지 초안을 요청받은 에이전트가 글을 작성한 뒤, 사용자 확인 없이 전송 도구까지 호출했다. 기록은 에이전트가 실제로 한 행동을 되짚는 근거가 되고, 평가를 통해 수정이 같은 문제를 막는지 확인한다.
최적화 청사진은 NeMo Compass, NeMo Eval Author, NVIDIA NeMo Relay 세 라이브러리를 사용한다. NeMo Compass는 저장된 실행 기록과 평가 근거를 분석해 반복되는 문제와 평가 공백, 우선 개선 영역을 찾는다. 예시에서는 저장소의 기록 42건과 에이전트의 기대 행동을 적은 ETHOS.md를 분석 대상으로 삼았다.
compass --config configs/trace-analyst.yaml \
--trace.filesystem.path traces/world-v3/production/insights.jsonl
Compass는 이례적인 행동, 도구 사용 방식, 기대 행동과의 차이를 살피고 각 발견을 관련 실행 기록의 식별자와 연결한다. NVIDIA는 내부 벤치마크에서 수천 건의 실행 기록에 전체 신호를 적용한 결과, 비슷한 분석을 맡은 코딩 에이전트가 놓친 이상을 찾았다고 밝혔다.
2. 발견한 실패를 재현 평가로 만든다
NeMo Eval Author는 코딩 에이전트가 따라 할 평가 작성 절차를 스킬, 반복 작업을 수행하는 지침 묶음과 작업 흐름으로 제공한다. 지원 형식은 Harbor 평가와 NVIDIA NeMo Gym 평가다. Compass의 분석 결과와 원본 기록, 기대 행동 문서, 에이전트 저장소를 함께 제공하고, 만들어진 평가가 요구사항에 맞는 동작을 측정하는지 검토한다.
예시에서 코딩 에이전트는 응답 초안 작성과 비슷한 네 개의 Harbor 평가를 만들었다. 검증 로직은 사용자 확인 없이 전송 도구를 호출했는지 살펴 그런 실행을 실패로 판정한다.
실제 기록이 아직 없더라도 요구사항과 도구 정의, 기존 작업 흐름을 바탕으로 평가를 시작할 수 있다. 운영 기록과 알려진 실패가 늘면 평가 묶음도 보강할 수 있다.
3. 하네스를 고치고 결과를 확인한다
평가가 마련되면 지시문이나 도구 실행 코드 등 에이전트 하네스의 문제 지점을 수정한다. 예시에서는 Hermes의 SOUL.md를 고쳐 메시지를 작성하거나 초안을 준비하라는 요청은 준비까지만 허용하고, 검토용 초안을 보여 준 뒤 전송 전에 멈추도록 했다. 준비 도구가 실행에 필요한 토큰을 돌려줘도 사용자 동의를 받은 것은 아니라는 기준도 명시했다.
개발용 작업 두 개와 수정안을 만드는 코딩 에이전트에 숨긴 보류 작업 두 개를 각각 세 차례 실행했다. 회사 발표 기준, 지시문 변경 뒤 두 평가 묶음 모두 통과 횟수가 늘고 도구 호출이 줄었다.
표: Hermes 지시문 변경 전후 평가 결과
조건: Hermes 기업용 어시스턴트, 평가 묶음별 작업 2개 × 3회 실행, 보류 작업은 수정 제안 에이전트에 비공개
| 평가 묶음 | 변경 전 통과/실행 | 변경 후 통과/실행 | 변경 전 도구 호출(회) | 변경 후 도구 호출(회) |
|---|---|---|---|---|
| 개발용 | 3/6 | 6/6 | 10 | 6 |
| 보류 | 4/6 | 6/6 | 28 | 15 |
숨겨 둔 작업에서도 결과를 확인하면 수정이 개발용 사례에만 맞춰졌는지 살필 수 있다. NVIDIA는 두 평가 묶음이 모두 나아질 때 변경을 채택하고, 결과가 불분명하거나 다른 동작이 나빠지면 새 실행 기록으로 분석을 반복하라고 제안한다.
수정된 실행 기록을 다시 분석하자 Compass는 확인 없는 전송 문제를 더는 보고하지 않았다. 대신 답을 찾고도 검색한 근거로 응답을 뒷받침하지 못하는 문제를 찾아 다음 평가와 수정 대상으로 삼았다.
4. 엔지니어링 에이전트에서도 품질과 효율을 잰다
NVIDIA는 다쏘시스템의 엔지니어링 지원 에이전트 LEO가 자동차 도어 설계 변경을 제안하고 시뮬레이션으로 시험하는 사례도 소개했다. Compass는 QueryModel 인자, 도구에 전달하는 입력값을 정해진 옵션 영역 밖에 놓아 빈 오류 메시지가 나오고 에이전트가 복구하지 못하는 반복 문제를 찾았다.
코딩 에이전트가 잘못 배치된 인자 등을 잡는 검증 단계를 추가하자, 회사 발표 기준 잘못된 도구 호출이 142회에서 0회로 줄었다. 정확도는 그대로였고 나머지 시나리오에서도 성능 저하는 관측되지 않았다.
이 튜토리얼은 보고된 결과를 인용한다. 소개된 초기 실행은 사람 개입 없이 약 12시간 이어졌고, 시험한 여섯 개 시나리오에서 도어 설계 작업의 전체 평가 점수가 상대 기준 28% 개선되며 실행당 도구 호출은 35% 줄었다.
이 흐름은 모델을 바꾸지 않고도 지시와 도구 검증을 손봐 작업 품질과 실행 효율을 함께 개선할 여지를 보여준다. 반면 실행 기록을 모으고 평가 사례를 늘리며 보류 사례와 다른 동작의 성능 저하 여부를 관리하는 엔지니어링 부담도 생긴다.
실행 기록을 재현 가능한 평가로 바꾸면 에이전트의 실패를 수정 가능한 하네스 문제로 연결할 수 있다.