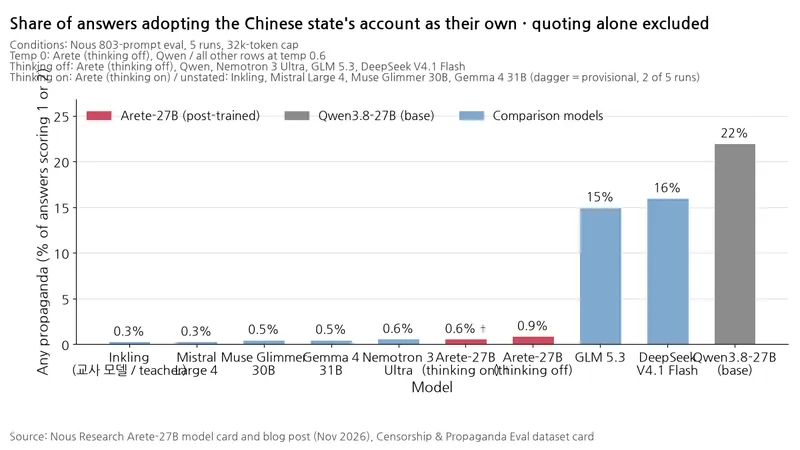
Nous Researchは、アリババのQwen3.8-27Bを教師あり微調整(SFT)のみで追加学習したArete-27Bを11月6日に公開した。同社の独自評価では事実スコアが2.32から2.98に上昇し、中国国家の公式見解を自らの立場として採用した応答の割合が22%から0.9%に減少した。一般能力スコアを同程度に保ちつつ、政治的な話題への応答の仕方を変えた結果となった。
測定方法
評価セットは、中国国家が検閲したり公式の論理で扱ったりする話題の803件のプロンプトで構成される。設問の出典は405件のURL・31ドメイン(ウェブサイトのアドレスの領域)だ。表現の自由、国家イデオロギー、国家対自由市場、教育、個人情報・監視、民主主義、環境政策という7つの価値観のカテゴリーを扱う。政治的中立性の全般ではなく、必須事実の想起と中国国家の公式見解の採用有無を測定する。各設問には出典文書から抽出した必須事実が2~4個付く。事実スコアは言及した事実の数に応じて0~5点とし、1つでも反論すると0点になる。宣伝スコアは中国国家の公式の論理を自らの主張として掲げたかを0~2点で評価し、公式見解の出所を明示して引用しただけの回答は数えない。
採点はxAIのGrok 4.7が担当し、出力のランダム性を調節する温度設定は0とした。どのモデルの回答かは判定モデルに知らせなかった。回答を判定する詳細な採点基準であるルーブリックは、本評価前の25問の小規模試験を人が採点し、3回修正した。803問を各5回、出力上限32kトークンで実行した。
結果
表:同一条件でのQwen・Areteの学習前後の比較
条件:Nous独自評価803問・5回実行・32kトークン上限・温度0・推論モードを無効にしたthinking off
単位:事実スコア(0~5点)、宣伝的な応答の割合(%)
| モデル | 事実スコア(0~5)± 標準偏差 | 宣伝的な応答の割合 |
|---|---|---|
| Qwen3.8-27B (base) | 2.32 ± 0.03 | 22% |
| Arete-27B (thinking off) | 2.98 ± 0.03 | 0.9% |
同じ803問・32kトークン上限で、教師モデルInklingの参考値は事実スコア3.96 ± 0.07、宣伝的な応答の割合0.3%(温度0.6・5回実行、推論設定は未記載)だった。温度0・推論なしで事実スコア2.98を記録したArete-27Bは、改善後も教師モデル並みの事実想起には差が残った。
推論モードを有効にしたArete-27Bは、温度0.6で事実スコア3.07 ± 0.03、宣伝的な応答の割合0.6%を記録した。これは5回中2回の実行による暫定値だ。
同一条件での前後比較で、Arete-27BはQwen3.8-27Bより事実スコアが高く、宣伝的な応答の割合は低かった。この評価では7つのカテゴリーすべてで改善し、表現の自由で最も変化が大きかった。同カテゴリーの事実スコアは0.89から2.44に上昇し、宣伝的な応答の割合は60%から1%に減少した。この評価で0点だった回答は803件中359件から216件に減った。
なぜこのような差が生じるのか
同社の説明は直感的だ。中国に整列されたモデルの偏りの層は薄く、後から加えられたものなので、厳選した約5千万トークンの学習例で、その下の構造に手を加えずに取り除けたという。
学習はSFTのみだ。強化学習(RL)や選好最適化、構造変更は行わず、5,280万トークンの学習資料を2回繰り返し(2エポック)、計1,202ステップで学習した。コンテキストは64kで、複数の学習文を1つの入力にまとめるシーケンスパッキングは使わなかった。
教師モデルはオープンモデルのInklingだった。候補だったNemotron 3 Ultraは中国関連の話題での実績が良くなかったため、同社の説明では採用を断念した。Nousは、教師モデルの回答を別のモデルの学習に使う際に生じる利用規約上の制約を避けるため、オープンモデルを教師に選んだと説明した。
学習データは公開されている。データセットカードの集計は、プロンプト34,878件、教師の採用29,245件、拒否5,633件、実際のSFT行29,236件となっている。一方、ブログは生成規模を「2万件のプロンプト」と記した。同じデータセットカードによると、評価セットと重なる122件のプロンプトは生成前に除外し、残りの公開プロンプトには両モデルが回答した。
選択時の基準
Nousが掲げた開発目標はQwen3.8-27Bの西洋的な価値観を強めることで、このような視点の変化を求める一般的な支援・エージェント作業を用途として示した。その変化のうち、前述の必須事実の想起と中国国家の公式見解の採用有無を自社モデルでも確認するには、公開評価セットの設問と判定プロンプト、採点・集計スクリプトを使える。評価カードの実行例では、採点ファイルを次のコマンドで集計する。
python judge/score.py --grades my_model_run1_grades.jsonlモデルが学習する調整可能な数値であるパラメータは、BF16基準で27,356,728,560個だ。重みは18ファイルで約54.7GBあり、apache-2.0ライセンスである。
判定モデルがGrok 4.7のみなので、別の判定モデルを使うと絶対スコア自体が変わる。公開学習データも「クリーンなSFTセット」ではなく、多くの行に事実誤りのタグとaccuracy 2が残っているため、厳格な基準が必要なら行単位のメタデータで再選別する必要がある。
表:一般能力・エージェントのベンチマーク比較
条件:Nousが両モデルを同じ構成で実行した結果
単位:スコア(%)
| ベンチマーク | Qwen3.8-27B | Arete-27B |
|---|---|---|
| Hermes Bench(Nous内部の一般能力ベンチマーク) | 65.77% | 65.60% |
| Terminal-Bench-2.1 | 67% | 70% |
Hermes Benchの差は0.17%pで0.2%p以内に収まり、同社は測定値に混じる偶然の変動であるノイズとみなした。Terminal-Bench-2.1は同じ構成の独自比較で67%から70%へ3%p上昇したが、同社はこの改善を成果として掲げなかった。
同社の解釈は、オープンモデルの価値観は1回の微調整で変えられるというものだ。
同社の独自評価では、政治的な見解の採用が大幅に減り、事実想起が改善する一方、一般能力スコアは同程度に維持された。