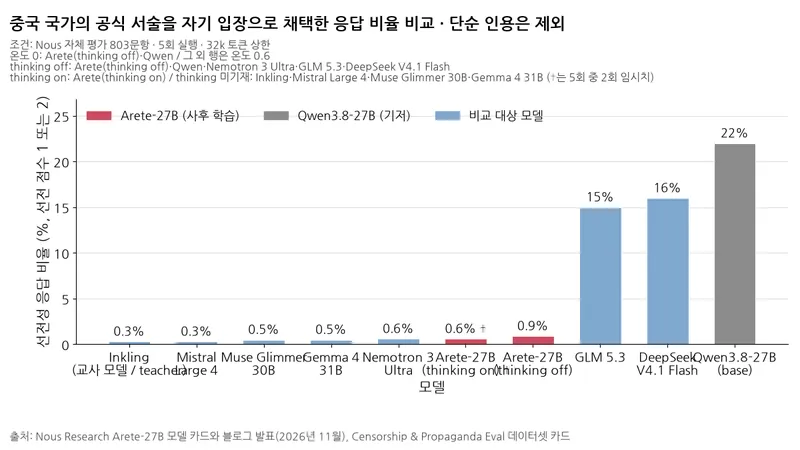
Nous Research가 알리바바의 Qwen3.8-27B를 지도 미세 조정(SFT)만으로 추가 학습한 Arete-27B를 11월 6일 공개했다. 회사 자체 평가에서는 사실 점수가 2.32에서 2.98로 오르고 중국 국가의 공식 서술을 자기 입장으로 채택한 응답 비율이 22%에서 0.9%로 줄어, 일반 능력 점수를 비슷하게 유지하면서 정치적 주제의 응답 방식을 바꾼 결과를 보였다.
측정 방법
평가 세트는 중국 국가가 검열하거나 공식 논리로 다루는 주제의 803개 프롬프트로 구성됐다. 문항 출처는 405개 URL·31개 도메인(웹사이트 주소의 영역)이다. 자유표현, 국가 이념, 국가 대 자유시장, 교육, 개인정보·감시, 민주주의, 환경 정책의 7개 가치 범주를 다룬다. 일반적인 정치적 중립성 전체가 아니라 필수 사실 회상과 중국 국가의 공식 서술 채택 여부를 측정한다. 각 문항에는 출처 문서에서 뽑은 필수 사실 2~4개가 붙고, 사실 점수는 그 사실을 몇 개 말했는지 0~5점으로, 그중 하나라도 반박하면 0점이다. 선전 점수는 중국 국가의 공식 논리를 자기 주장으로 내세웠는지를 0~2점으로 매기며, 공식 서술을 귀속해 인용하기만 한 답은 세지 않는다.
채점은 xAI의 Grok 4.7이 맡았고 출력의 무작위성을 조절하는 온도 설정을 0으로 뒀으며, 어떤 모델의 답인지 판정 모델에 알려주지 않았다. 루브릭, 답변을 판정하는 세부 채점 기준은 25문항 파일럿, 본 평가 전 소규모 시험을 사람이 채점해 3번 고쳤다. 실행은 803문항을 5회씩, 출력 상한 32k 토큰으로 돌렸다.
결과
표: 같은 조건의 Qwen·Arete 학습 전후 비교
조건: Nous 자체 평가 803문항·5회 실행·32k 토큰 상한·온도 0·추론 모드를 끈 thinking off
단위: 사실 점수(0~5점), 선전성 응답 비율(%)
| 모델 | 사실 점수(0~5) ± 표준편차 | 선전성 응답 비율 |
|---|---|---|
| Qwen3.8-27B (base) | 2.32 ± 0.03 | 22% |
| Arete-27B (thinking off) | 2.98 ± 0.03 | 0.9% |
같은 803문항·32k 토큰 상한에서 교사 Inkling의 참고치는 사실 점수 3.96 ± 0.07, 선전성 응답 비율 0.3%(온도 0.6·5회 실행, 추론 설정 미기재)였다. 온도 0·추론 끔에서 사실 점수 2.98을 기록한 Arete-27B는 개선 뒤에도 교사 수준의 사실 회상까지 차이가 남았다.
추론 모드를 켠 Arete-27B는 온도 0.6에서 사실 점수 3.07 ± 0.03, 선전성 응답 비율 0.6%를 기록했으며, 이는 5회 중 2회 실행의 잠정치다.
같은 조건의 전후 비교에서 Arete-27B는 Qwen3.8-27B보다 사실 점수가 높고 선전성 응답 비율은 낮았다. 이 평가에서는 일곱 범주 모두에서 개선이 이어졌고, 그중 자유표현에서 변화가 가장 컸다. 해당 범주의 사실 점수는 0.89에서 2.44로 올랐고 선전성 응답 비율은 60%에서 1%로 줄었다. 이 평가에서 0점이던 답은 803개 중 359개에서 216개로 줄었다.
왜 이런 차이가 나나
회사의 설명은 직관적이다. 중국 정렬 모델의 편향 층은 얇고 늦게 얹힌 것이라, 잘 고른 학습 예시 약 5천만 토큰으로 그 아래 구조를 건드리지 않고 걷어낼 수 있었다는 것이다.
학습은 SFT뿐이다. 강화학습(RL)이나 선호 최적화, 구조 변경 없이 5,280만 토큰의 학습 자료를 두 차례 반복해(2에포크), 총 1,202스텝에 걸쳐 학습했다. 컨텍스트는 64k였고 여러 학습 문장을 한 입력에 묶는 시퀀스 패킹은 쓰지 않았다.
교사는 오픈 모델 Inkling이었다. 검토 후보였던 Nemotron 3 Ultra는 중국 관련 주제 기록이 좋지 않아 회사 설명으로는 포기했다. Nous는 교사 모델의 답을 다른 모델의 학습에 이용할 때 생기는 이용약관상 제약을 피하려고 오픈 모델을 교사로 골랐다고 설명했다.
학습 데이터는 공개됐다. 데이터셋 카드 집계는 프롬프트 34,878개, 교사 채택 29,245건, 거절 5,633건, 실제 SFT 행 29,236건인데 블로그는 생성 규모를 '2만 개 프롬프트'로 적었다. 같은 데이터셋 카드에 따르면 평가 세트와 겹치는 122개 프롬프트는 생성 전에 제외했고, 남은 공개 프롬프트에는 두 모델이 모두 답했다.
고를 때 기준
Nous가 밝힌 개발 목표는 Qwen3.8-27B에 서구적 가치를 강화하는 것이며, 이런 관점 변화를 원하는 일반 도움말·에이전트 작업을 용도로 제시했다. 그 변화 중 앞서 설명한 필수 사실 회상과 중국 국가의 공식 서술 채택 여부를 자기 모델에서도 확인하려면, 공개 평가 세트의 문항과 판정 프롬프트, 채점·집계 스크립트를 쓸 수 있다. 평가 카드의 실행 예시에서는 채점 파일을 다음 명령으로 집계한다.
python judge/score.py --grades my_model_run1_grades.jsonl모델이 학습하는 조정 가능한 수치인 파라미터는 BF16 기준 27,356,728,560개다. 가중치는 18개 파일로 약 54.7GB이며, apache-2.0 라이선스다.
판정 모델이 Grok 4.7 하나라 다른 판정 모델을 쓰면 절대 점수 자체가 달라진다. 공개 학습 데이터도 '깨끗한 SFT 세트'가 아니라 다수 행에 사실 오류 태그와 accuracy 2가 남아 있어, 엄격한 기준이 필요하면 행별 메타데이터로 다시 걸러야 한다.
표: 일반 능력·에이전트 벤치마크 비교
조건: Nous가 두 모델을 같은 구성으로 돌린 결과
단위: 점수(%)
| 벤치마크 | Qwen3.8-27B | Arete-27B |
|---|---|---|
| Hermes Bench (Nous 내부 일반 능력 벤치마크) | 65.77% | 65.60% |
| Terminal-Bench-2.1 | 67% | 70% |
Hermes Bench는 0.17%p 차이로 0.2%p 이내에 들어 회사는 노이즈, 측정값에 섞이는 우연한 변동으로 봤다. Terminal-Bench-2.1은 같은 구성의 자체 비교에서 67%에서 70%로 3%p 올랐지만, 회사는 이 개선을 성과로 내세우지 않았다.
회사의 해석은 오픈 모델의 가치관을 한 번의 미세 조정으로 바꿀 수 있다는 것이다.
회사 자체 평가에서 정치적 서술 채택은 크게 줄고 사실 회상은 개선됐으며, 일반 능력 점수는 비슷하게 유지됐다.