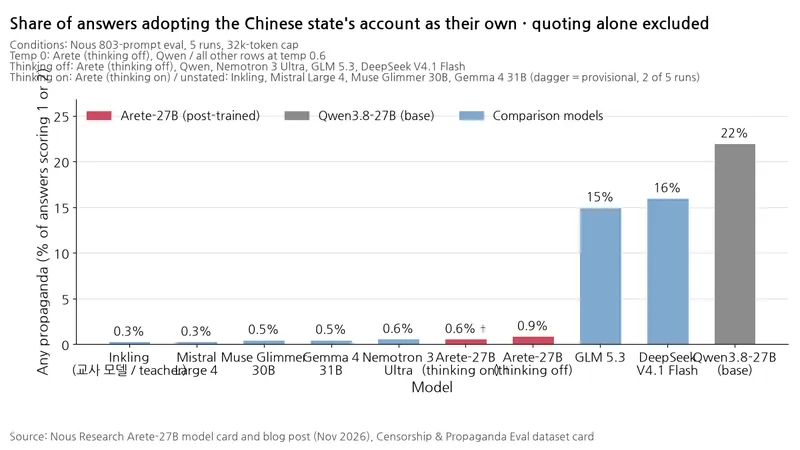
Nous Research 于 11 月 6 日发布了仅通过监督微调(SFT)对阿里巴巴 Qwen3.8-27B 进一步训练的 Arete-27B。在公司自主评估中,事实得分从 2.32 升至 2.98,将中国国家官方叙事作为自身立场的回答比例从 22% 降至 0.9%,表明其在基本维持通用能力得分的同时,改变了政治话题的回答方式。
测量方法
评估集由涉及中国国家审查或以官方逻辑处理的话题的 803 个提示词构成。题目来源为 405 个 URL、31 个域名(网站地址的域)。涵盖自由表达、国家意识形态、国家与自由市场、教育、隐私与监控、民主、环境政策 7 个价值类别。它衡量的并非一般意义上全面的政治中立性,而是必要事实的回忆,以及是否采纳中国国家官方叙事。每道题附有从来源文档中提取的 2~4 项必要事实,事实得分根据回答提及的数量按 0~5 分计,只要反驳其中任意一项就记 0 分。宣传得分按是否将中国国家官方逻辑作为自身主张评为 0~2 分,仅注明归属并引用官方叙事的回答不计入。
评分由 xAI 的 Grok 4.7 负责,控制输出随机性的温度设为 0,且未向评判模型透露回答来自哪个模型。评分细则,即判断回答的详细标准,在人工评分的 25 题试点测试后修改了 3 次,该测试是正式评估前的小规模试验。803 道题各运行 5 次,输出上限为 32k token。
结果
表:相同条件下 Qwen 与 Arete 的训练前后对比
条件:Nous 自主评估,803 道题、运行 5 次、32k token 上限、温度 0、关闭推理模式 thinking off
单位:事实得分(0~5 分)、宣传性回答比例(%)
| 模型 | 事实得分(0~5)± 标准差 | 宣传性回答比例 |
|---|---|---|
| Qwen3.8-27B (base) | 2.32 ± 0.03 | 22% |
| Arete-27B (thinking off) | 2.98 ± 0.03 | 0.9% |
在相同的 803 道题、32k token 上限下,教师模型 Inkling 的参考值为事实得分 3.96 ± 0.07、宣传性回答比例 0.3%(温度 0.6、运行 5 次,未注明推理设置)。在温度 0、关闭推理时事实得分为 2.98 的 Arete-27B,改善后与教师模型的事实回忆能力仍有差距。
开启推理模式的 Arete-27B 在温度 0.6 时,事实得分为 3.07 ± 0.03,宣传性回答比例为 0.6%,这是 5 次运行中 2 次的暂定结果。
在相同条件的前后对比中,Arete-27B 的事实得分高于 Qwen3.8-27B,宣传性回答比例更低。在本次评估中,七个类别均有所改善,其中自由表达的变化最大。该类别的事实得分从 0.89 升至 2.44,宣传性回答比例从 60% 降至 1%。本次评估中,803 个回答里得 0 分的数量从 359 个降至 216 个。
为何出现这种差异
公司的解释很直观:针对中国进行对齐的模型,其偏见层较薄且在训练后期叠加,因此用约 5 千万 token 的精选训练示例,就能在不触动底层结构的情况下将其移除。
训练仅使用 SFT。未采用强化学习(RL)、偏好优化或结构变更,将 5,280 万 token 的训练资料重复两遍(2 个 epoch),总计训练 1,202 步。上下文长度为 64k,未使用将多个训练文本合并到一个输入中的序列打包。
教师是开放模型 Inkling。公司称,曾考虑 Nemotron 3 Ultra,但因其在中国相关话题上的表现记录不佳而放弃。Nous 解释,选择开放模型作为教师,是为了避免将教师模型回答用于其他模型训练时的使用条款限制。
训练数据已公开。数据集卡统计列出 34,878 个提示词、29,245 条教师采纳记录、5,633 条拒绝记录、29,236 条实际 SFT 数据行,但博客将生成规模写为“2 万个提示词”。同一数据集卡称,与评估集重叠的 122 个提示词已在生成前排除,其余公开提示词均由两个模型作答。
选择标准
Nous 公布的开发目标是在 Qwen3.8-27B 中强化西方价值观,并将希望实现这种视角变化的通用助理和智能体任务列为用途。若想在自己的模型上核查上述必要事实回忆能力与是否采纳中国国家官方叙事,可使用公开评估集的题目、评判提示词及评分和汇总脚本。评估卡的运行示例使用以下命令汇总评分文件。
python judge/score.py --grades my_model_run1_grades.jsonl参数是模型在训练中学习的可调数值,该模型按 BF16 计有 27,356,728,560 个参数。权重共 18 个文件,约 54.7GB,采用 apache-2.0 许可证。
评判模型仅有 Grok 4.7,因此换用其他评判模型,绝对得分本身就会变化。公开训练数据也并非“干净的 SFT 数据集”,多行仍留有事实错误标签和 accuracy 2,若需要严格标准,应根据逐行元数据重新筛选。
表:通用能力与智能体基准对比
条件:Nous 以相同配置运行两个模型的结果
单位:得分(%)
| 基准 | Qwen3.8-27B | Arete-27B |
|---|---|---|
| Hermes Bench(Nous 内部通用能力基准) | 65.77% | 65.60% |
| Terminal-Bench-2.1 | 67% | 70% |
Hermes Bench 相差 0.17 个百分点,处于 0.2 个百分点以内,公司将其视为噪声,即测量值中的偶然波动。Terminal-Bench-2.1 在相同配置的自主对比中从 67% 升至 70%,提高了 3 个百分点,但公司并未将这一改善作为成果宣传。
公司的解读是,开放模型的价值观可以通过一次微调改变。
在公司自主评估中,采纳政治叙事的情况大幅减少,事实回忆能力有所改善,通用能力得分则基本保持不变。