llama.cppは大規模言語モデルをローカルで実行するツールだ。今回の最適化では、NVIDIA GPU上でNVFP4(重み4ビット量子化)モデルの入力コンテキスト処理演算を融合し、回答生成前のプロンプト処理を高速化した。
測定方法
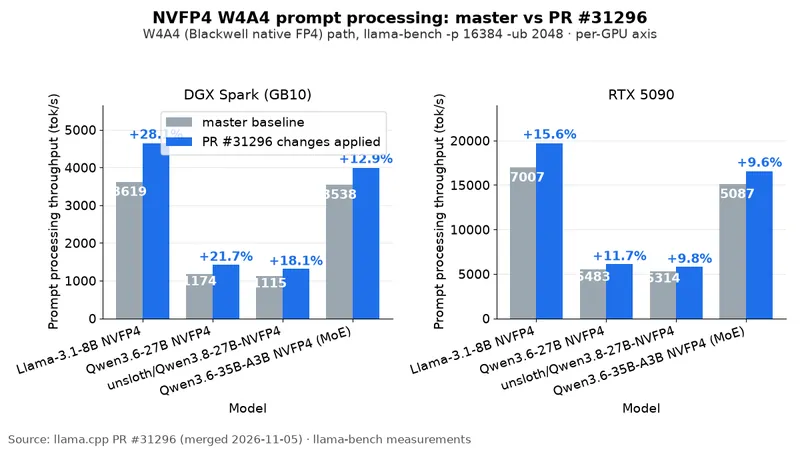
DGX Sparkのプロンプト処理速度が28.1%向上した。2026年11月5日公開のb12122の最適化だ。
活性化(モデルの計算途中で生じる値)が4ビットのW4A4はBlackwell専用で、Turing~Hopperでは8ビットのW4A8を使う。表のmaster・PRは#31296適用前・後を示す。コマンドは末尾の例と同じで、-ubは物理的な最大バッチサイズだ。
GPU別の代表測定値
条件:16k、Llama-3.1-8B NVFP4、計算経路は各行に表示。
単位:tok/s
表:GPU別のプロンプト処理速度
| GPU | 経路 | master | PR | 増加率 |
|---|---|---|---|---|
| DGX Spark (GB10) | W4A4 | 3618.6 | 4635.9 | +28.1% |
| RTX 5090 | W4A4 | 17007.1 | 19668.2 | +15.6% |
| RTX 4090 | W4A8 | 8045.0 | 8956.5 | +11.3% |
| RTX 3090 Ti | W4A8 | 3979.2 | 4264.8 | +7.2% |
増加率はW4A4の8組で+9.6~28.1%、W4A8の6組で+2~11.3%だった。全リストは出典のPR本文にある。
vLLMとのプロンプト処理比較
共通条件はDGX Spark(GB10)、nvidia/Qwen3.8-27B-NVFP4(revision 482ca0f3)、1シーケンスだ。
条件:vllm bench latency、出力1トークン、FP16活性化・KVキャッシュ(先行トークンのキー・値の保存)、プリフィルチャンク2048トークン、プレフィックスキャッシュ無効、FlashInferアテンション、ウォームアップ2回・測定5回。
単位:tok/s
表:vLLMのプロンプト処理速度
| ビルド | 8k | 16k |
|---|---|---|
| vLLM 0.33.0 | 3254.5 | 3012.4 |
条件:下記コマンド、出力0トークン、測定3回、F16 KVキャッシュ、NVFP4 W4A4。アテンションは各行に表示。
単位:tok/s
表:llama.cppのプロンプト処理速度
| ビルド | 8k | 16k |
|---|---|---|
| master (Q8_0) | 1156.9 | 1118.2 |
| 本PR (Q8_0) | 1414.5 | 1352.7 |
| #28413 + 本PR (FP8) | 1604.7 | 1537.5 |
この条件で本PR単独はvLLMのスループットの約43.5%(8k)・44.9%(16k)だ。FP8 cuBLAS PR #28413と組み合わせると、masterの約3分の1から約半分に向上する。#28413は未マージで、この組み合わせはb12122には含まれない。
なぜこの差が生じるのか
ゲート・アップは入力を2系統で計算し、ゲートの結果でアップの結果を調整する。MMQ(量子化行列積専用のCUDAカーネル経路)で、2つの行列積とGLU(両結果を結合する演算)を一度に実行する。行を8個ずつ交互に配置し、各スレッドが同じ出力要素のアップ・ゲート値をともに保持する。メモリへの書き込み時にレジスタでGLUとNVFP4重みスケールを適用する。
先行作業は通常の順伝播ニューラルネットワークの#29948(2026-10-25マージ)、専門家分担型MoEの#31188(2026-10-28マージ)だ。別のDGX Spark測定ではLlama-3.1-8B Q4_K_Mが2749.3 → 3000.6 tok/s(+9.1%)、Qwen3-30B-A3B Q4_K_Mが+17.2%だった。これをNVFP4に拡張した。
vLLMとの残る差はnsys(性能プロファイラ)のトレースで分析した。DGX Spark・Qwen3.8-27B-NVFP4で本PRとFP8 PR #28413の組み合わせを追跡した結果、8Kプロンプト1回のGPU時間はllama.cppが5.02秒、vLLMが2.47秒だった。GPU使用率は両方とも98~99%で、差はすべてカーネル時間だった。
差が大きい順にFP4行列積(1.59秒対0.87秒)、小規模な補助演算(0.96秒対0.26秒)、行列積前の活性化量子化(0.82秒対0.27秒)だった。特に量子化では、llama.cppがF32という32ビット浮動小数点形式を2回読み、8Kプロンプト当たり456msを費やす構造が原因だ。vLLMは活性化と正規化を行うニューラルネットワーク演算SwiGLU/RMSNormにFP4量子化を融合し、amax(ブロック最大絶対値の計算)パスをなくした。
選択時の基準
Blackwell GPU(DGX Spark、RTX 5090)のW4A4経路が表で最大の改善を示した。DGX Spark・Llama-3.1-8B NVFP4で4096トークンのプロンプトを使い、ubatchを16まで下げても悪化せず3.0%向上した。b12122は継続的に発行されるb番号のビルドだ。直前の正式版v0.9.0(2026-11-04)はOCP FP8 E4M3量子化とflash_attn_ext_rows演算をサポートする。数値は各PR作成者の独自測定で、比較ベンチマーク・トレースにはClaudeの支援を受けたと明かしている。
CUDA MMQ対応カードでは同じモデル・設定で以前のビルドとb12122を比較しよう。再現例の<gguf>はモデルファイルに置き換える。
llama-bench -m <gguf> -ngl 99 -fa on -p 8192,16384 -n 0 -b 2048 -ub 2048 -r 3演算融合で入力処理は速まったが、行列積と活性化量子化のカーネル時間が依然として差を生んでいる。