llama.cpp 是在本地运行大语言模型的工具。此次优化在 NVIDIA GPU 上融合 NVFP4(权重 4 位量化)模型的输入上下文处理运算,提高生成回答前的提示词处理速度。
测量方法
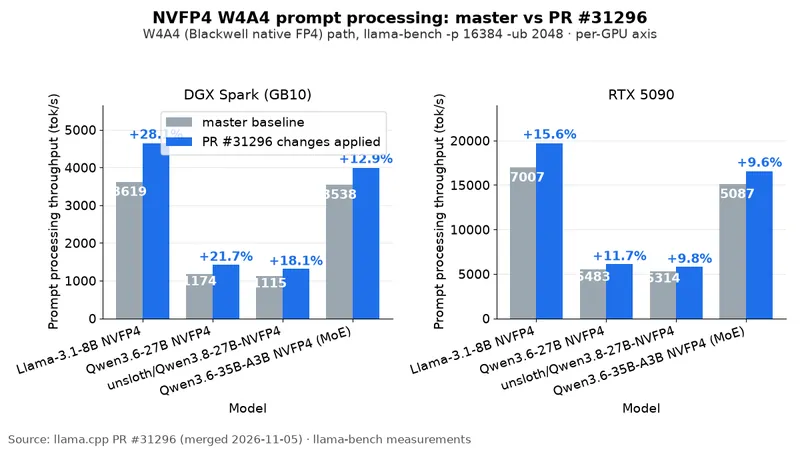
DGX Spark 的提示词处理速度提高了 28.1%。这是 2026 年 11 月 5 日发布的 b12122 中的优化。
激活值(模型计算中产生的中间值)为 4 位的 W4A4 仅限 Blackwell,Turing~Hopper 使用 8 位激活值的 W4A8。表中的 master 和 PR 分别表示应用 #31296 前后。命令见文末示例,-ub 是物理最大批大小。
各 GPU 的代表性测量值
条件:16k,Llama-3.1-8B NVFP4,计算路径按行标示。
单位:tok/s
表:各 GPU 的提示词处理速度
| GPU | 路径 | master | PR | 提升幅度 |
|---|---|---|---|---|
| DGX Spark (GB10) | W4A4 | 3618.6 | 4635.9 | +28.1% |
| RTX 5090 | W4A4 | 17007.1 | 19668.2 | +15.6% |
| RTX 4090 | W4A8 | 8045.0 | 8956.5 | +11.3% |
| RTX 3090 Ti | W4A8 | 3979.2 | 4264.8 | +7.2% |
8 个 W4A4 组合的提升幅度为 +9.6~28.1%,6 个 W4A8 组合为 +2~11.3%。完整列表见来源中的 PR 原文。
与 vLLM 的提示词处理对比
共同条件为 DGX Spark(GB10)、nvidia/Qwen3.8-27B-NVFP4(revision 482ca0f3)、1 个序列。
条件:vllm bench latency,输出 1 个 token,FP16 激活值与 KV 缓存(存储先前 token 的键和值),预填充分块为 2048 个 token,关闭前缀缓存,FlashInfer 注意力,预热 2 次、测量 5 次。
单位:tok/s
表:vLLM 的提示词处理速度
| 构建版本 | 8k | 16k |
|---|---|---|
| vLLM 0.33.0 | 3254.5 | 3012.4 |
条件:下方命令,输出 0 个 token,测量 3 次,F16 KV 缓存,NVFP4 W4A4。注意力实现按行标示。
单位:tok/s
表:llama.cpp 的提示词处理速度
| 构建版本 | 8k | 16k |
|---|---|---|
| master (Q8_0) | 1156.9 | 1118.2 |
| 本 PR (Q8_0) | 1414.5 | 1352.7 |
| #28413 + 本 PR (FP8) | 1604.7 | 1537.5 |
在这些条件下,本 PR 单独达到 vLLM 吞吐量的约 43.5%(8k) 和 44.9%(16k)。与 FP8 cuBLAS PR #28413 结合后,可从 master 的约三分之一提升至约一半。#28413 尚未合并,该组合未包含在 b12122 中。
为何存在这些差异
门控与上投影将输入分为两路计算,用门控结果调节上投影结果。在 MMQ(量化矩阵乘法专用 CUDA 内核路径)中,两次矩阵乘法与 GLU(合并两路结果的运算)一次完成。以每组 8 行交替排列,使各线程同时持有同一输出元素的上投影值和门控值。写入内存时,通过寄存器应用 GLU 和 NVFP4 权重缩放。
前期工作包括普通前馈神经网络的 #29948(2026-10-25 合并),以及混合专家 MoE 的 #31188(2026-10-28 合并)。另一次 DGX Spark 测量中,Llama-3.1-8B Q4_K_M 从 2749.3 → 3000.6 tok/s(+9.1%),Qwen3-30B-A3B Q4_K_M 提升 +17.2%。此次将其扩展至 NVFP4。
通过 nsys(性能分析器)跟踪分析了与 vLLM 的剩余差距。在 DGX Spark、Qwen3.8-27B-NVFP4 上跟踪同时应用本 PR 和 FP8 PR #28413 的组合时,单次 8K 提示词的 GPU 时间为 llama.cpp 5.02 秒、vLLM 2.47 秒。双方 GPU 利用率均为 98~99%,因此差异全部来自内核时间。
差异从大到小依次为 FP4 矩阵乘法(1.59 秒对 0.87 秒)、小型辅助运算(0.96 秒对 0.26 秒)、矩阵乘法前的激活值量化(0.82 秒对 0.27 秒)。量化方面尤其是因为 llama.cpp 两次读取 F32,即 32 位浮点格式,每个 8K 提示词耗时 456ms。vLLM 则将 FP4 量化融合进执行激活与归一化的 SwiGLU/RMSNorm 神经网络运算,消除了 amax(计算块内最大绝对值)遍历。
选择时的依据
Blackwell GPU(DGX Spark、RTX 5090)的 W4A4 路径在表中获益最大。在 DGX Spark、Llama-3.1-8B NVFP4 上使用 4096 个 token 的提示词,即使将 ubatch 降至 16,也没有性能损失,反而提升 3.0%。b12122 是持续发布的 b 编号构建版本。上一正式版 v0.9.0(2026-11-04)支持 OCP FP8 E4M3 量化和 flash_attn_ext_rows 运算。数据均为各 PR 作者自行测量,作者表示对比基准测试与跟踪分析得到了 Claude 的协助。
支持 CUDA MMQ 的显卡可使用相同模型和设置,对比之前的构建版本与 b12122。复现示例中的 <gguf> 需替换为模型文件。
llama-bench -m <gguf> -ngl 99 -fa on -p 8192,16384 -n 0 -b 2048 -ub 2048 -r 3运算融合加快了输入处理,但矩阵乘法和激活值量化的内核时间仍在造成差距。