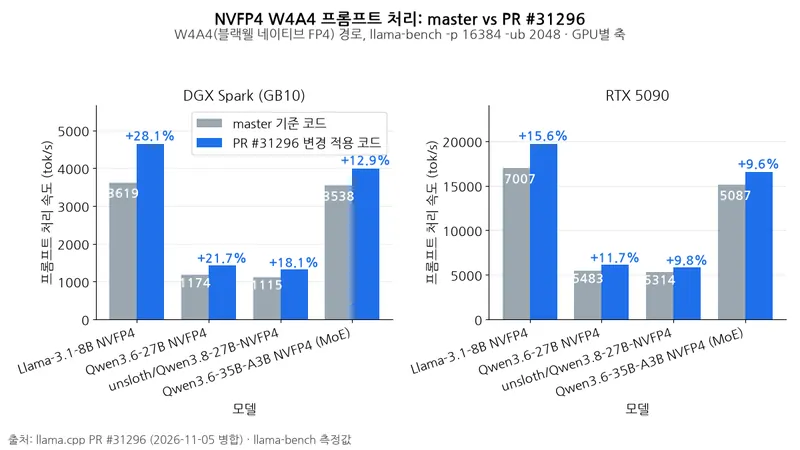
llama.cpp는 대형 언어 모델을 로컬에서 실행하는 도구다. 이번 최적화는 NVIDIA GPU에서 NVFP4(가중치 4비트 양자화) 모델의 입력 문맥 처리 연산을 합쳐, 답변 생성 전 프롬프트 처리 속도를 높였다.
측정 방법
DGX Spark의 프롬프트 처리 속도가 28.1% 올랐다. 2026년 11월 5일 공개된 b12122의 최적화다.
활성화(모델 계산 중간에 생기는 값)가 4비트인 W4A4는 블랙웰 전용, Turing~Hopper는 8비트인 W4A8을 쓴다. 표의 master·PR은 #31296 적용 전·후다. 명령은 끝의 예시와 같으며 -ub는 물리적 최대 배치 크기다.
GPU별 대표 측정값
조건: 16k, Llama-3.1-8B NVFP4, 계산 경로는 행별 표시.
단위: tok/s
표: GPU별 프롬프트 처리 속도
| GPU | 경로 | master | PR | 증가율 |
|---|---|---|---|---|
| DGX Spark (GB10) | W4A4 | 3618.6 | 4635.9 | +28.1% |
| RTX 5090 | W4A4 | 17007.1 | 19668.2 | +15.6% |
| RTX 4090 | W4A8 | 8045.0 | 8956.5 | +11.3% |
| RTX 3090 Ti | W4A8 | 3979.2 | 4264.8 | +7.2% |
증가율은 W4A4 8개 조합에서 +9.6~28.1%, W4A8 6개에서 +2~11.3%였다. 전체 목록은 출처의 PR 원문에 있다.
vLLM과 프롬프트 처리 비교
공통 조건은 DGX Spark(GB10), nvidia/Qwen3.8-27B-NVFP4(revision 482ca0f3), 1 시퀀스다.
조건: vllm bench latency, 출력 1토큰, FP16 활성화·KV 캐시(앞선 토큰의 키·값 저장), 프리필 청크 2048토큰, 접두사 캐싱 끔, FlashInfer 어텐션, 준비 2회·측정 5회.
단위: tok/s
표: vLLM의 프롬프트 처리 속도
| 빌드 | 8k | 16k |
|---|---|---|
| vLLM 0.33.0 | 3254.5 | 3012.4 |
조건: 아래 명령, 출력 0토큰, 측정 3회, F16 KV 캐시, NVFP4 W4A4. 어텐션은 행별 표시.
단위: tok/s
표: llama.cpp의 프롬프트 처리 속도
| 빌드 | 8k | 16k |
|---|---|---|
| master (Q8_0) | 1156.9 | 1118.2 |
| 본 PR (Q8_0) | 1414.5 | 1352.7 |
| #28413 + 본 PR (FP8) | 1604.7 | 1537.5 |
이 조건에서 본 PR 단독은 vLLM 처리량의 약 43.5%(8k)·44.9%(16k)다. FP8 cuBLAS PR #28413과 결합하면 master의 약 3분의 1에서 약 절반으로 높아진다. #28413은 미병합으로, 결합 조합은 b12122에 없다.
왜 이런 차이가 나나
게이트·업은 입력을 두 갈래로 계산해 게이트 결과로 업 결과를 조절한다. MMQ(양자화 행렬곱 전용 CUDA 커널 경로)에서 두 행렬곱과 GLU(두 결과를 결합하는 연산)를 한 번에 실행한다. 행을 8개씩 번갈아 배치해 각 스레드가 같은 출력 원소의 업·게이트 값을 함께 보유한다. 메모리 기록 때 레지스터로 GLU와 NVFP4 가중치 스케일을 적용한다.
선행 작업은 일반 순전파 신경망의 #29948(2026-10-25 병합), 전문가 분담형 MoE의 #31188(2026-10-28 병합)이다. 별도 DGX Spark 측정에서 Llama-3.1-8B Q4_K_M은 2749.3 → 3000.6 tok/s(+9.1%), Qwen3-30B-A3B Q4_K_M은 +17.2%였다. 이를 NVFP4로 확장했다.
vLLM과의 남은 격차는 nsys(성능 프로파일러) 트레이스로 나눠 보았다. DGX Spark·Qwen3.8-27B-NVFP4에서 이 PR과 FP8 PR #28413을 함께 적용한 조합을 추적한 결과, 8K 프롬프트 한 번의 GPU 시간은 llama.cpp 5.02초, vLLM 2.47초였고, GPU 점유율은 양쪽 모두 98~99%여서 차이는 전부 커널 시간이었다.
차이가 큰 순서는 FP4 행렬곱(1.59초 대 0.87초), 작은 보조 연산(0.96초 대 0.26초), 행렬곱 전 활성화 양자화(0.82초 대 0.27초)였다. 특히 양자화 쪽은 llama.cpp가 F32, 32비트 부동소수점 형식을 두 번 읽어 8K 프롬프트당 456ms를 쓰는 구조 때문이고, vLLM은 SwiGLU/RMSNorm, 활성화와 정규화를 수행하는 신경망 연산 안에 FP4 양자화를 융합해 amax(블록 최대 절댓값 계산) 패스를 없앴다.
고를 때 기준
블랙웰 GPU(DGX Spark, RTX 5090)의 W4A4 경로가 표에서 가장 큰 이득을 보였다. DGX Spark·Llama-3.1-8B NVFP4에서 4096토큰 프롬프트로 ubatch를 16까지 낮춘 경우에도 손해 없이 3.0% 상승했다. b12122는 연속 발행되는 b-번호 빌드다. 직전 정식판 v0.9.0(2026-11-04)은 OCP FP8 E4M3 양자화와 flash_attn_ext_rows 연산을 지원한다. 수치는 각 PR 작성자의 자체 측정이며, 비교 벤치마크·추적에는 Claude의 도움을 받았다고 밝혔다.
CUDA MMQ 지원 카드에서는 같은 모델·설정으로 이전 빌드와 b12122를 비교하자. 재현 예시의 <gguf>는 모델 파일로 바꾼다.
llama-bench -m <gguf> -ngl 99 -fa on -p 8192,16384 -n 0 -b 2048 -ub 2048 -r 3연산 융합은 입력 처리를 앞당겼지만, 행렬곱과 활성화 양자화의 커널 시간이 여전히 격차를 만든다.