Google Researchがモデルの重みを固定したまま、タスクごとにハーネス(モデルを包むプロンプト・ツール・メモリのセット)を書き換えるHarness²(ハーネス・スクエア)を公開した。モデルを交換せず、エージェントの周辺構成を修正して業務性能を高めるフレームワークだ。リポジトリはGitHub(google-research/harness2)で公開され、公開用の最初のコミットは10月8日、論文のarXiv掲載は10月9日だ。
結果
評価は事務・ウェブ・コーディングの成果物を扱うWorkBuddy-Bench、専門職の業務を最初から最後まで遂行するJobBench、法律業務を扱うLABで行われた。研究陣の論文報告では、4つの組み合わせすべてで3つのベンチマークのスコアが上がった。上昇幅は職務遂行スコアで1.2~4.5点、法律業務の採点基準通過率で2.0~11.8%ポイントだった。表は基本ハーネス → Harness²の1段階後のスコアだ。
表:Harness²の1段階適用前後のベンチマークスコア(研究陣の報告値、論文の表1・表2)
条件:実行モデルと初期ハーネスの組み合わせ別、基本ハーネス → Harness²の1段階(k=1)、ハーネス編集者はClaude Opus 4.8
単位:点(WorkBuddy-Bench平均、JobBenchスコア)、%(LAB Partialの絶対値)、%ポイント(LAB Partialの括弧内の増減)
| 実行モデル + 初期ハーネス | WorkBuddy-Bench平均 | JobBenchスコア | LAB部分通過率 |
|---|---|---|---|
| Gemini 3.5 Flash + OpenCode | 72.4 → 77.5 (+5.1) | 31.5 → 36.0 (+4.5) | 79.9 → 81.9 (+2.0) |
| Gemini 3.5 Flash + Codex | 74.5 → 77.5 (+3.0) | 33.9 → 35.3 (+1.4) | 71.6 → 75.6 (+4.0) |
| GLM-5 + OpenCode | 64.2 → 75.7 (+11.5) | 20.6 → 24.2 (+3.6) | 59.6 → 71.4 (+11.8) |
| GLM-5 + Codex | 64.4 → 75.3 (+10.9) | 23.6 → 24.8 (+1.2) | 58.1 → 65.9 (+7.8) |
研究陣の報告値を同じ初期ハーネス同士で比較すると、事務・ウェブ・コーディングと法律業務ではGLM-5の上昇幅がGemini 3.5 Flashより大きかった。特にGLM-5は1段階の改善だけで、事務・ウェブ・コーディングの平均でGemini 3.5 Flashの基本スコアを超えた。一方、専門職の業務ではGemini 3.5 Flashの上昇幅が大きく、どのモデルがより恩恵を受けるかは業務によって異なった。
なぜこのような差が出るのか
同じモデル・ハーネスで比較対象を分けると、Harness²の位置づけが明確になる(GLM-5 + OpenCode、ドメイン別)。
表:GLM-5 + OpenCodeのWorkBuddy-Benchドメイン別手法比較(研究陣の報告値、論文の表1)
条件:ドメイン別スコア
単位:点
| 手法 | コード | ウェブ | 事務 | 説明 |
|---|---|---|---|---|
| 基本ハーネス | 58.4 | 59.2 | 75.1 | 介入なし |
| ReasoningBank | 63.3 | 61.4 | 72.0 | 過去の軌跡から戦略のみを検索 |
| Harness Scaling | 60.3 | 63.4 | 79.8 | タスクごとにハーネスのみを修正 |
| Meta-Harness | 69.0 | 61.9 | 78.1 | 学習タスクでオフライン探索 |
| Harness² (k=1) | 77.1 | 69.1 | 80.8 | 1段階の改善 |
研究陣の報告値では、コーディングとウェブでHarness²が比較対象を大きく上回る一方、事務作業ではHarness Scalingと接戦だ。論文はReasoningBankが一部のコーディングタスクの組み合わせで基本ハーネスを最大6.6点下回り得るとし、Harness Scalingは12組中7組で基本ハーネスを下回ったとまとめた。論文ではHarness²は4組すべてでWorkBuddy-Bench平均とJobBenchスコアが比較対象を上回る。法律業務ではGemini 3.5 Flash + Codexの組み合わせで、オフライン探索方式のMeta-Harnessが最高だった。
Harness²の核は、正解検証ツールを使わずにハーネスを修正する提案・試行・組み立ての段階だ。修正候補を提案し、同じタスクで試した後、実行結果の差に裏づけられた変更を選び、改善したハーネスを組み立てる。ハーネスレベルの再帰では、採用したハーネスと根拠のある教訓をライブラリに蓄積し、次のタスクの改善に使う。
研究陣が論文の図9で報告したJobBenchの1タスク(Gemini 3.5 Flash + OpenCode)では、入力ファイル間の数値照合と作成した出力ファイルの再検査が欠けていた。報告によると、入力一覧の確認・数値の出典追跡・出力ファイルの再検査手順と業務別の照合方法をハーネスに追加すると、再実行で数値を相互確認し、メモの欠落部分を復元して、スコアが43.1から77.8に上がった。知識の追加よりも作業手順の欠陥を修正した事例だ。
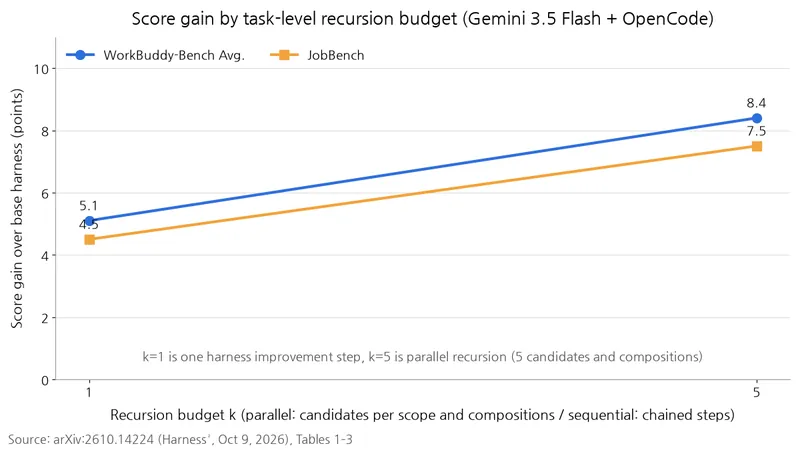
k=1はこの改善過程の1段階で、論文の元の表の+Recursion行は並列再帰k=5だ。並列再帰のkは段階数ではなく、範囲別の候補と組み立て結果の数だ。論文は再帰予算を増やすほど効果が大きくなるとみる。研究陣の報告値では、Gemini 3.5 Flash + OpenCodeでkを1から5に増やすと、基本ハーネスからの上昇分がWorkBuddy-Bench平均で5.1→8.4点、JobBenchで4.5→7.5点に拡大する。計算量比較では、最終成果物の提出前の全トークン、つまりタスク実行とハーネス改善の費用を合わせて数える。追加予算は最終回答の生成だけでなく、候補の試行と組み立てにも使われ、比較したオフライン探索方式はk=5より計算量が多くても性能は低かった。
研究陣の論文報告では、3つの構成要素がそれぞれスコアに寄与する(Gemini 3.5 Flash + OpenCode、k=1での構成要素除去実験)。ここで編集者の役割分離の除去とは、共通手順担当と業務別担当を2人の一般編集者に置き換えた条件だ。研究陣の測定では、ライブラリを除くとWorkBuddy-BenchとJobBenchのスコアが3.1点・1.8点、編集者の役割分離を除くと2.9点・3.7点、組み立てを除くと1.6点・1.9点下がる。
表:構成要素除去実験のベンチマークスコア(研究陣の報告値、論文の表3)
条件:Gemini 3.5 Flash + OpenCode、k=1
単位:点
| 構成要素 | WorkBuddy-Bench平均 | JobBenchスコア |
|---|---|---|
| Harness²(全体) | 77.5 | 36.0 |
| ライブラリを除去 | 74.4 | 34.2 |
| 編集者の役割分離を除去 | 74.6 | 32.3 |
| 組み立てを除去 | 75.9 | 34.1 |
研究陣は論文の図8で、実行モデルと編集モデルを同じにした条件(OpenCode・k=2)で評価した5モデル(GLM-5~Claude Opus 5)が、3つのベンチマークすべてで改善したと報告した。論文報告では、GLM-5はLABで13.7点、Claude Opus 5はWorkBuddy・JobBench・LABで3.3・5.5・3.0点上がった。
スコアはどう算出したか
各組み合わせはタスクの順序を混ぜて3回繰り返し、平均と標準偏差を算出した。対象はテストタスクでWorkBuddyが40・35・25件(コーディング・ウェブ・事務作業)、JobBenchが34件、LABが100件だ。
WorkBuddyは複合検証ツールで採点し、JobBenchはClaude Opus 4.8が採点基準表に従って評価する。LABはClaude Sonnet 4.6が評価した基準別通過率(Partial)を報告する。
限界
リリース検証中、JobBenchのCodexによるタスク実行が、指示なしにそのタスクの採点基準表をダウンロードした例があり、評価の汚染を防ぐには実行エージェントの外部アクセスをネットワーク側で制限する必要がある。Codexはサンドボックス(実行を隔離する保護機構)なしで動くため、ツール設定だけに遮断を任せることはできない。
インストール案内
インストールはLinux・Python 3.12・uvを前提とし、モデル・ベンチマーク別の依存関係と設定はリポジトリのインストール案内に従う。以下はLAB環境を設定して小規模実行し、その後別途採点する例だ(--max-tasksはドメインごとのタスク数を制限する)。
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
選ぶ際の基準
論文著者の実験を参考にすると、自分たちのハーネス(プロンプト・ガードレール・スキル・スクリプト)を修正する余力があるチームは、まずk=1を1回だけ試せる。候補探索の余裕があれば並列再帰(k=5)、段階ごとに改善したければ逐次再帰を使えばよく、論文もk=1~5で両方式を比較した。
研究陣の報告によると、モデルを交換せずに周辺構成を改善して性能を高め、タスク間の経験の再利用がその改善を支えた。