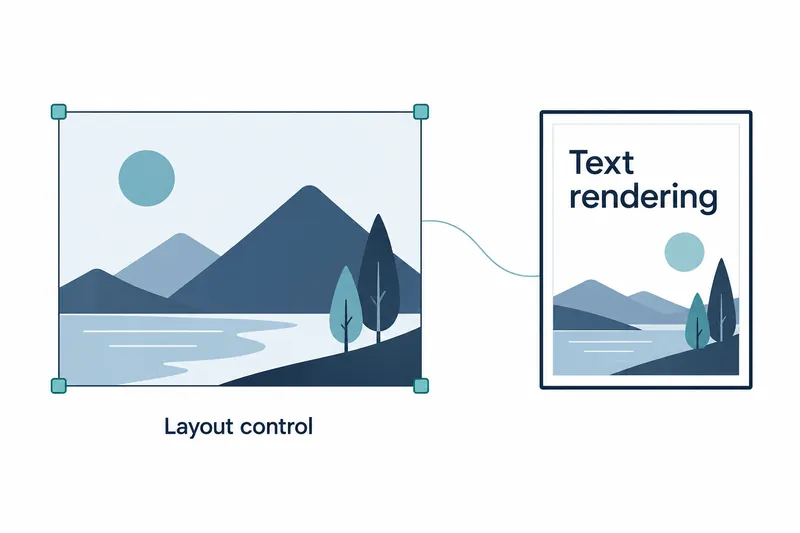
OpenMOSSが文字入りの画像を作り、文字や物体の位置も指定できるモデルをコードと重みとともに公開した。ポスターや案内文を作る開発者は、文章で場面を説明するだけでなく、要素ごとの位置を座標で伝える方法を試せるようになった。
1. 基本モデルと追加学習モデルの違い
OpenMOSSは2026年10月16日にMOSS-Image-BaseとMOSS-Image-SFTを公開した。前者は基本のテキスト画像生成モデルで、後者は選別したデータで基本モデルを追加学習したバージョンである。
入力は自然言語の説明、タグの列挙、JSON形式の配置情報に対応する。プロジェクトは最大4Kトークンの長い入力や、アニメ・実写風の生成に対応すると説明している。トークンは、モデルが入力文を処理するために分割した単位である。
リポジトリの比較例では、追加学習モデルの文字のまとまりがより明確で、ホワイトボードの構成も整っていると説明されている。この例だけで全般的な品質の優位性を断定するのは難しい。定量的な品質比較や速度・メモリの測定値と条件は、提供された原文には示されていない。
独立したパイプラインのコードはApache License 2.0で配布される。基本モデルのモデルカードも、重みと同梱の推論コードに同じライセンスを明記している。
2. 配置情報は画像の設計図の役割を果たす
配置入力では、場面全体の説明と個々の要素の一覧を分けて記述する。各要素には種類、説明、領域を囲む長方形を入れ、描画する文字は別に指定する。言葉だけで構図を指示する代わりに、文字や物体の位置を設計図のように伝える仕組みだ。
長方形の座標は、縦の最小値、横の最小値、縦の最大値、横の最大値の順である。原点は左上ではなく画面の中心にある。1024×1024の画面では各軸が−512から+512までで、右方向と下方向に値が大きくなる。
Web画面ではJSONを入力欄に貼り付け、生成する幅・高さを座標の基準に合わせる必要がある。コードで配置情報を文字列に変換する際はjson.dumps(layout, ensure_ascii=False)を使う。コードで要求する画像の幅・高さは、それぞれ16の正の倍数でなければならない。
文字、要素の説明、長方形を修正し、内容と構図を構造的に調整できるというのがリポジトリの説明だ。そのため配置編集ツールと連携する余地はあるが、座標入力自体を完成された編集画面と混同してはならない。
3. Web画面とノードツールで始める
モデルカードの実行案内ではPython 3.10以上とPyTorch 2.9以上が必要とされる。ハードウェアはCUDA対応のNVIDIA GPUを前提としている。
リポジトリをインストールした後、Web画面を起動する例は次のとおりだ。最初の行はWeb画面用の依存関係をインストールし、2行目は基本モデルでアプリを起動する。
pip install -e '.[ui]'
python gradio_app.py --model OpenMOSS-Team/MOSS-Image-Base
ノードで生成工程をつなぐComfyUIでは、プラグイン管理ツールでMOSS-Imageを検索してインストールできる。公式リポジトリへの統合は進行中である。
Comfy-Orgはノードツール向けに再パッケージしたモデルファイルを提供する。両モデルの16ビット浮動小数点ファイルと8ビット整数の量子化ファイル、別途テキストエンコーダーが含まれる。これは配布形式の選択肢であり、ファイル一覧だけで品質や速度の違いを判断する根拠にはならない。
4. 配置制御の利点と実行コストを併せて見る
利点は文字や物体の位置を構造的に指定し、基本モデルを自分の作業に合わせて追加学習できる点だ。ただし5B、つまり約50億パラメーターは画像生成本体の規模である。文章を解釈するテキストエンコーダーは別途9B級なので、本体の大きさだけで実行全体の負担を判断してはならない。
Web画面では、モデル全体をGPUに置く方法と、必要な構成要素をCPUとの間で移動する方法を選べる。メモリが不足する場合は解像度を下げるか逐次処理モードを選べるが、逐次処理では推論が遅くなり、コンパイル最適化も使えない。配置制御を得る代わりに、座標の作成と実行リソースの調整をユーザーが担う構造である。
このモデルの導入価値は、本体が小さいという説明よりも、配置制御が必要な作業で結果の品質と実行コストを併せて確認することで判断できる。