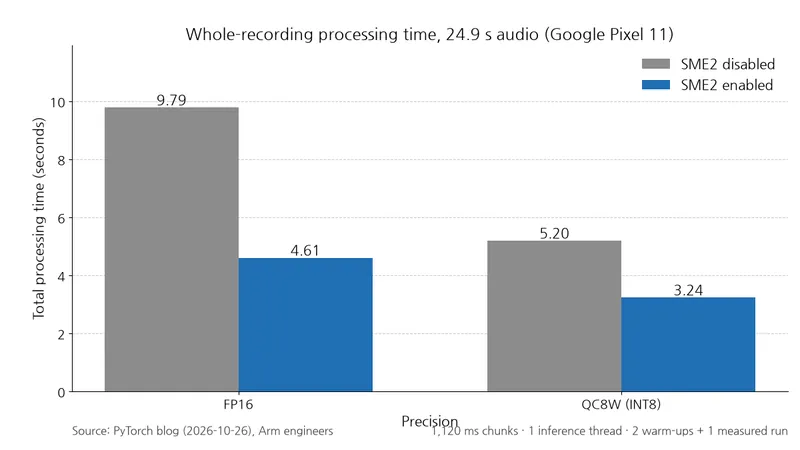
Armのエンジニア2人が2026年10月26日、PyTorchブログでExecuTorch 1.3.1によるストリーミング音声認識最適化の事例を公開した。発表元は、Google Pixel 11で24.9秒の録音のFP16(16ビット浮動小数点方式)処理時間が、SME2の有効化で約半分になったとした。アプリでは、まとめて処理する音声区間であるチャンクの長さと精度を併せて選び、最初の文字までの遅延と誤り率を調整する必要がある。
結果
全体の処理時間の原文。QC8Wは動的INT8活性値とチャネル別INT8重みを使う方式である。
条件:Google Pixel 11 · 24.9秒の録音 · 1,120 msチャンク · 推論スレッド1個(中間コアに固定) · ExecuTorch 1.3.1 SME2 on/off · ウォームアップ2回 + 測定1回
単位:処理時間は秒
| 精度 | SME2無効 | SME2有効 | 高速化倍率 | 実時間倍率(SME2有効) |
|---|---|---|---|---|
| FP16 | 9.79 | 4.61 | 2.12倍 | 0.19 |
| QC8W (INT8) | 5.20 | 3.24 | 1.61倍 | 0.13 |
実時間倍率は処理時間を音声の長さで割った値である。発表元によると、両構成とも実時間より速く、ほかのCPU処理を挟む余裕が残る。ただし最初のテキストが出るまでは、音声を集めた後、前処理と推論も待つ必要がある。
なぜこの差が生じるのか
SME2はArmの行列演算拡張である。発表元のETDump分析では行列積(GEMM)が最大の割合を占め、SME2を有効にすると、その時間と割合が低下した。
表:ETDumpによるGEMM演算時間の比較
条件:ETDumpの演算子時間 · Pixel 11 · SME2 on/off比較
単位:秒
| 精度 | SME2無効 | SME2有効 |
|---|---|---|
| FP16 | 8.2 | 3.1 |
| QC8W (INT8) | 4.1 | 2.0 |
同じ分析でGEMMの割合はFP16で84%→67%、QC8Wで78%→62%に低下した。コピーや連結などのデータ移動時間はほぼ変わらず、相対的なボトルネックとして残った。この処理が全体の高速化を制限するため、今後の最適化対象となる。
発表元のArm Streamline測定では、SME利用率はFP16で38.4%、QC8Wで53.7%だった。これは行列ハードウェアの割り当て比率であり、最大演算速度に対する比率ではない。
発表元のカーネルサンプリングでは、KleidiAIのSME2 GEMMカーネルの実行が確認された。一部のGEMMは、FP16ビルドではベクトル演算用のNEON経路を、QC8WビルドではFP32経路を引き続き使用していた。
選択の基準
チャンク別の精度の原文。WERは単語誤り率である。
条件:ホストでの測定 · ExecuTorchランタイム + XNNPACK CPUバックエンド · LibriSpeech Other·AMI Cleaned·Earnings22·VoxPopuli Cleaned AAの4コーパス、14,019発話の合算
単位:WERは%
| チャンクサイズ (ms) | FP16 WER | QC8W WER |
|---|---|---|
| 80 | 15.2 | 15.5 |
| 320 | 12.67 | 12.97 |
| 560 | 12.01 | 12.26 |
| 1,120 | 11.50 | 11.72 |
チャンクが長いほど誤り率は低いが、最初の文字までの待ち時間は長くなる。発表元による560 ms構成の初回出力遅延の推定は、SME2有効時にFP16で691 ms、QC8Wで660 msである。音声収集時間に、モデルの3処理段階の実行時間の中央値を加えた。合成入力と初期化済みストリーム状態で3ラウンド、構成ごとに75サンプルを測定し、初回出力がテキストであると仮定した推定である。
事例の800 msの遅延予算と13%のWER上限を併せて適用すると、320·560 ms構成が候補となる。80 msは誤り率、1,120 msは遅延目標を超える。320 msは応答速度、560 msは精度で有利であり、560 msでの遅延の余裕はQC8Wのほうが大きい。精度に余裕があればQC8Wで時間を節約し、余裕がなければFP16を使う。事例ではFP16とFP32の差は0.03%p未満で、QC8WのWERはFP32より0.21~0.31%p高かった。
測定方法
再現時にはNemotron 3.5のモデル資料を同一にし、XNNPACK·KleidiAIを維持したままSME2だけを有効・無効に切り替える。実機の条件は最初の表と同じである。
ETDumpは演算子時間を、Arm Streamlineはネイティブ関数のサンプルを示す。
ETDumpドキュメントの必須CMake設定は次のとおりである。
-DEXECUTORCH_BUILD_DEVTOOLS=ON
-DEXECUTORCH_ENABLE_EVENT_TRACER=ON
ExecuTorch 1.3.1を使うなら、まずSME2ビルドを確認し、ETDumpで収集したデータをInspector APIで分析するが、これらの数値はPixel 11の1台とNemotron 3.5の1モデルから得られた値であることを考慮する。