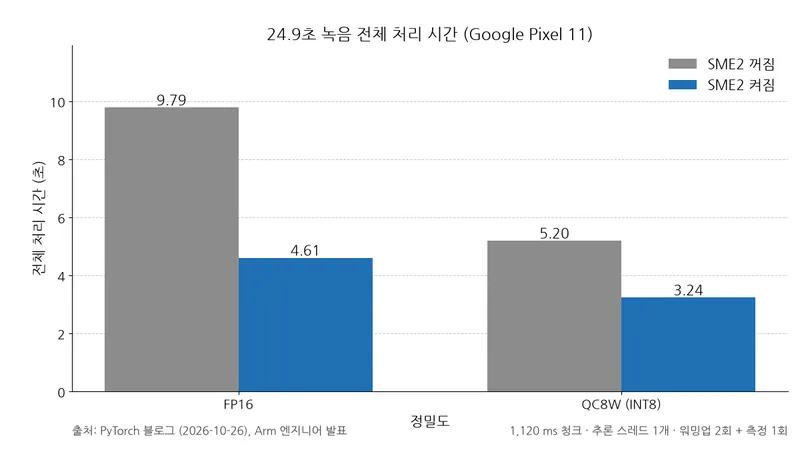
Arm 엔지니어 2인이 2026년 10월 26일 PyTorch 블로그에 ExecuTorch 1.3.1 기반 스트리밍 음성 인식 최적화 사례를 공개했다. 발표사는 Google Pixel 11에서 24.9초 녹음의 FP16(16비트 부동소수점 방식) 처리 시간이 SME2를 켜자 절반 수준으로 줄었다고 밝혔다. 앱에서는 한 번에 모아 처리하는 음성 구간인 청크의 크기와 정밀도를 함께 골라 첫 글자까지의 지연과 오류율을 맞춰야 한다.
결과
전체 처리 시간 원문. QC8W는 동적 INT8 활성값과 채널별 INT8 가중치를 쓰는 방식이다.
조건: Google Pixel 11 · 24.9초 녹음 · 1,120 ms 청크 · 추론 스레드 1개(중간 코어 고정) · ExecuTorch 1.3.1 SME2 on/off · 워밍업 2회 + 측정 1회
단위: 처리 시간은 초
| 정밀도 | SME2 꺼짐 | SME2 켜짐 | 가속 배율 | 실시간 배율(SME2 켜짐) |
|---|---|---|---|---|
| FP16 | 9.79 | 4.61 | 2.12배 | 0.19 |
| QC8W (INT8) | 5.20 | 3.24 | 1.61배 | 0.13 |
실시간 배율은 처리 시간을 오디오 길이로 나눈 값이다. 발표사에 따르면 두 구성 모두 실시간보다 빠르며 다른 CPU 작업을 끼워 넣을 여유가 남는다. 다만 첫 텍스트까지는 음성을 모은 뒤 전처리와 추론도 기다려야 한다.
왜 이런 차이가 나나
SME2는 Arm의 행렬 연산 확장이다. 발표사의 ETDump 분석에서 행렬 곱셈(GEMM)이 가장 큰 몫을 차지했고, SME2를 켜자 그 시간과 비중이 낮아졌다.
표: ETDump 기준 GEMM 연산 시간 비교
조건: ETDump 연산자 시간 · Pixel 11 · SME2 on/off 비교
단위: 초
| 정밀도 | SME2 꺼짐 | SME2 켜짐 |
|---|---|---|
| FP16 | 8.2 | 3.1 |
| QC8W (INT8) | 4.1 | 2.0 |
같은 분석에서 GEMM 비중은 FP16 84%→67%, QC8W 78%→62%로 줄었다. 복사·이어 붙이기 같은 데이터 이동 시간은 거의 그대로여서 상대적 병목으로 남았다. 이 작업이 전체 가속을 제한하므로 후속 최적화 대상이 된다.
발표사의 Arm Streamline 측정에서 SME 활용률은 FP16 38.4%, QC8W 53.7%였다. 이는 행렬 하드웨어 할당 비율이지 최대 연산 속도 대비 비율은 아니다.
발표사의 커널 샘플링에서는 KleidiAI의 SME2 GEMM 커널 실행이 확인됐다. 일부 GEMM은 FP16 빌드에서 벡터 연산용 NEON 경로를, QC8W 빌드에서 FP32 경로를 그대로 탔다.
고를 때 기준
청크별 정확도 원문. WER은 단어 오류율이다.
조건: 호스트 측정 · ExecuTorch 런타임 + XNNPACK CPU 백엔드 · LibriSpeech Other·AMI Cleaned·Earnings22·VoxPopuli Cleaned AA 4개 코퍼스 14,019 발화 합산
단위: WER은 %
| 청크 크기 (ms) | FP16 WER | QC8W WER |
|---|---|---|
| 80 | 15.2 | 15.5 |
| 320 | 12.67 | 12.97 |
| 560 | 12.01 | 12.26 |
| 1,120 | 11.50 | 11.72 |
청크가 길수록 오류율은 낮지만 첫 글자를 더 기다린다. 발표사가 제시한 560 ms 구성의 첫 출력 지연 추정은 SME2를 켰을 때 FP16 691 ms, QC8W 660 ms다. 오디오 수집 시간에 모델의 세 처리 단계 실행 시간 중앙값을 더했다. 합성 입력과 초기화된 스트림 상태로 3개 라운드, 구성당 75개 샘플을 측정했으며 첫 출력이 텍스트라고 가정한 추정이다.
사례의 800 ms 지연 예산·13% WER 상한을 함께 적용하면 320·560 ms 구성이 후보다. 80 ms는 오류율, 1,120 ms는 지연 목표를 넘는다. 320 ms는 빠른 응답, 560 ms는 정확도에 유리하며, 560 ms에서 지연 여유는 QC8W가 더 크다. 정확도 여유가 크면 QC8W로 시간을 아끼고 빡빡하면 FP16을 쓴다. 사례에서는 FP16이 FP32와 0.03%p 미만 차이였고 QC8W는 FP32 대비 0.21~0.31%p의 WER이 더 붙었다.
측정 방법
재현 시 Nemotron 3.5 모델 자료를 동일하게 두고 XNNPACK·KleidiAI를 유지한 채 SME2만 켜고 끈다. 실기기 조건은 첫 표와 같다.
ETDump는 연산자 시간을, Arm Streamline은 네이티브 함수 샘플을 보여준다.
ETDump 문서의 필수 CMake 설정은 다음과 같다.
-DEXECUTORCH_BUILD_DEVTOOLS=ON
-DEXECUTORCH_ENABLE_EVENT_TRACER=ON
ExecuTorch 1.3.1을 쓴다면 SME2 빌드를 먼저 확인하고, ETDump로 수집한 데이터를 Inspector API로 분석하되 이 수치가 Pixel 11 한 대와 Nemotron 3.5 한 모델에서 얻은 값임을 고려한다.