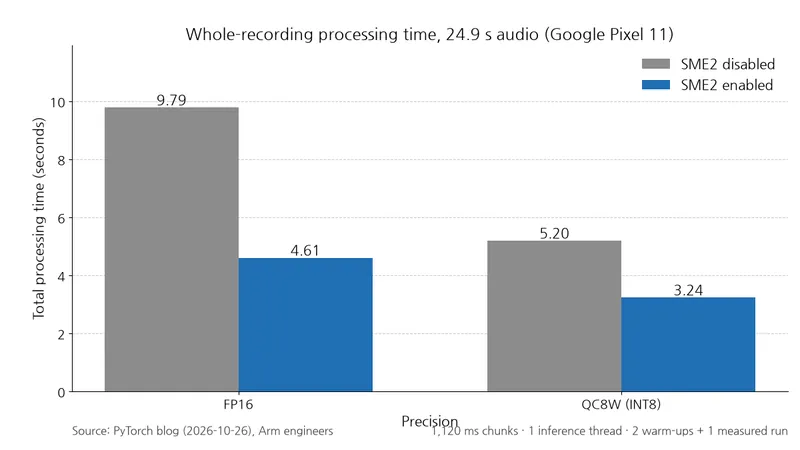
2 位 Arm 工程师于 2026 年 10 月 26 日在 PyTorch 博客发布了基于 ExecuTorch 1.3.1 的流式语音识别优化案例。发布方表示,在 Google Pixel 11 上启用 SME2 后,24.9 秒录音的 FP16(16 位浮点格式)处理时间降至约一半。应用需要同时选择每次集中处理的音频块大小与精度,以兼顾首字延迟和错误率。
结果
总处理时间原文。QC8W 使用动态 INT8 激活值和逐通道 INT8 权重。
条件:Google Pixel 11 · 24.9 秒录音 · 1,120 ms 音频块 · 1 个推理线程(固定在中核)· ExecuTorch 1.3.1 SME2 on/off · 预热 2 次 + 测量 1 次
单位:处理时间为秒
| 精度 | 关闭 SME2 | 开启 SME2 | 加速倍数 | 实时因子(开启 SME2) |
|---|---|---|---|---|
| FP16 | 9.79 | 4.61 | 2.12倍 | 0.19 |
| QC8W (INT8) | 5.20 | 3.24 | 1.61倍 | 0.13 |
实时因子为处理时间除以音频时长。发布方称,两种配置的处理速度均快于实时,仍有余量执行其他 CPU 任务。但首次文本输出不仅需要等待音频收集,还需等待预处理和推理。
为何出现这种差异
SME2 是 Arm 的矩阵运算扩展。发布方的 ETDump 分析显示,矩阵乘法(GEMM)占比最大,启用 SME2 后,其耗时和占比均有所下降。
表:基于 ETDump 的 GEMM 运算时间对比
条件:ETDump 算子耗时 · Pixel 11 · SME2 on/off 对比
单位:秒
| 精度 | 关闭 SME2 | 开启 SME2 |
|---|---|---|
| FP16 | 8.2 | 3.1 |
| QC8W (INT8) | 4.1 | 2.0 |
在同一分析中,GEMM 占比在 FP16 下从 84%→67%,在 QC8W 下从 78%→62%。复制、拼接等数据移动耗时几乎不变,成为相对瓶颈。这些操作限制了整体加速效果,因此是后续优化的对象。
发布方的 Arm Streamline 测量显示,SME 利用率在 FP16 下为 38.4%,在 QC8W 下为 53.7%。这表示矩阵硬件的分配比例,并非相对于峰值运算速度的比例。
发布方的内核采样确认执行了 KleidiAI 的 SME2 GEMM 内核。部分 GEMM 在 FP16 构建中仍走用于向量运算的 NEON 路径,在 QC8W 构建中仍走 FP32 路径。
选择标准
各音频块大小的准确率原文。WER 即词错误率。
条件:主机端测量 · ExecuTorch 运行时 + XNNPACK CPU 后端 · 汇总 LibriSpeech Other、AMI Cleaned、Earnings22、VoxPopuli Cleaned AA 共 4 个语料库的 14,019 条话语
单位:WER 为 %
| 音频块大小 (ms) | FP16 WER | QC8W WER |
|---|---|---|
| 80 | 15.2 | 15.5 |
| 320 | 12.67 | 12.97 |
| 560 | 12.01 | 12.26 |
| 1,120 | 11.50 | 11.72 |
音频块越长,错误率越低,但等待首字的时间也越长。发布方给出的 560 ms 配置首次输出延迟估算为:开启 SME2 时,FP16 为 691 ms,QC8W 为 660 ms。估算将音频收集时间与模型三个处理阶段执行时间的中位数相加。使用合成输入和已初始化的流状态,分 3 轮测量,每种配置采集 75 个样本,并假定首次输出为文本。
同时应用案例中的 800 ms 延迟预算与 13% WER 上限时,320·560 ms 配置可作为候选。80 ms 超出错误率目标,1,120 ms 超出延迟目标。320 ms 有利于快速响应,560 ms 有利于准确率;在 560 ms 下,QC8W 的延迟余量更大。准确率余量充足时可用 QC8W 节省时间,余量紧张时则用 FP16。案例中,FP16 与 FP32 的差异小于 0.03%p,而 QC8W 的 WER 比 FP32 高出 0.21~0.31%p。
测量方法
复现时,保持 Nemotron 3.5 模型资料相同,并保留 XNNPACK、KleidiAI,仅切换 SME2 的开关状态。真机条件与第一张表相同。
ETDump 展示算子耗时,Arm Streamline 展示原生函数采样。
ETDump 文档要求的 CMake 设置如下。
-DEXECUTORCH_BUILD_DEVTOOLS=ON
-DEXECUTORCH_ENABLE_EVENT_TRACER=ON
使用 ExecuTorch 1.3.1 时,应先确认 SME2 构建,再通过 Inspector API 分析 ETDump 采集的数据,同时注意这些数值仅来自一台 Pixel 11 和一个 Nemotron 3.5 模型。