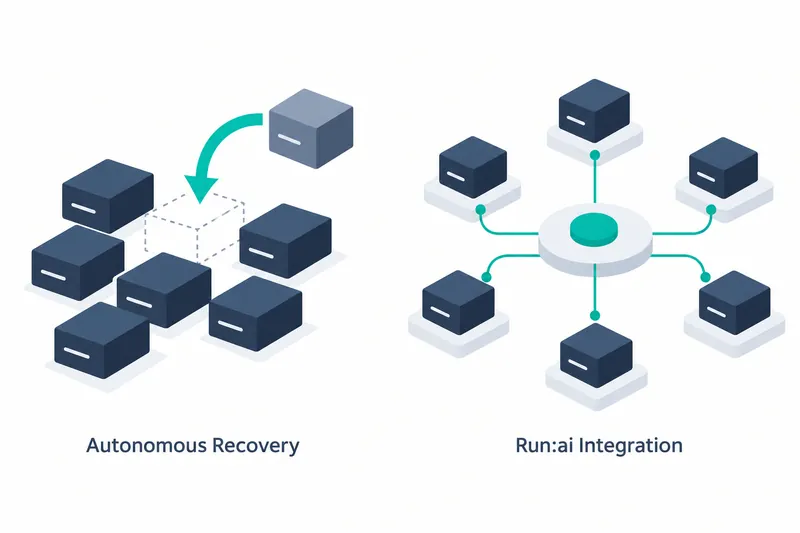
NVIDIAは、AI学習ジョブの自動復旧の範囲をKubernetes環境まで広げたNVIDIA Mission Control 2.5を公開した。大規模な学習を運用するチームは、障害原因を調査している間もジョブを再開し、疑わしい機器を次のジョブに割り当てないよう隔離できる。
1. ジョブの復旧とハードウェアへの対処を分離
従来の自己復旧エンジンは、Slurmを使って大規模な計算処理を行うハイパフォーマンスコンピューティングのジョブに適用されていた。今回は、製品に含まれるNVIDIA Run:aiが管理するKubernetesジョブへ範囲を広げた。両環境を運用するプラットフォームチームは、ジョブの配置方式に合わせて同じ復旧モデルを活用できるようになった。
復旧の流れは、ジョブを配置するスケジューラーと、ジョブ復旧サービス、ハードウェア復旧サービスが分担する。配車担当が実行リソースを選ぶと、ジョブ担当は失敗履歴と実行場所を見て再試行の方針を決め、機器担当は故障したリソースを点検する仕組みだ。
ハードウェア自己復旧サービスは、ノードとGPUの状態を確認する。異常が確認されると、そのリソースをスケジューリング対象から除外し、診断や対処を開始する。ジョブの復旧はハードウェアの修理を待たずに進められ、疑わしいノードが次のジョブに再び割り当てられるのも防ぐ構造だ。
2. 障害の種類に応じた復旧経路
GPUの故障で学習ジョブが停止すると、エラー信号とジョブのコンテキスト、実行状態や関連情報を使って疑わしいノードを特定する。ジョブ復旧側はスケジューラーとの連携でジョブを再起動または再配置し、ハードウェア復旧側は同時にノードを隔離して診断する。そのため、原因分析が終わるまでジョブの復旧が止まることはない。
一方、実際の処理を担うワーカーの終了や回復可能なタイムアウト、所定の時間内に応答しない状態など、一時的なソフトウェアエラーと判断されれば、スケジューラーのポリシーに従ってジョブを再試行できる。この場合、ハードウェアが正常なら不要な隔離は行わず、ハードウェアの状態監視を続ける。ジョブが失敗する前でも、GPUの状態警告や接続問題を根拠にリスクのあるノードをスケジューリングから除外できる。
3. Run:ai連携とインストールの準備
ジョブ復旧機能はRun:aiのKAIスケジューラーに統合された。ジョブ投入後、システムログと状態情報を失敗時点と照合し、ハードウェアまたはソフトウェアの原因を判断する。直近の異常の一因となったノードを除外するよう、実行設定や条件を記したジョブ定義を更新し、実行順を待つジョブの一覧であるキューに戻す。
自己復旧エンジン(ARE)は、ジョブ復旧、ハードウェア復旧、NVIDIA Resiliency Extensions(NVRx)から構成される。NVRxはNVIDIA Mission Controlとともにインストールされるものではなく、別途インストールが必要で、インストール手順は https://nvidia.github.io/nvidia-resiliency-ext/ に従う。
学習アプリには、Autonomous Job Recovery Training Telemetry Client Library(ジョブ復旧トレーニングテレメトリクライアントライブラリ)を組み込み、状態情報を記録できる。手動でのログ整形は不要で、ジョブ復旧サービスが監視するログメッセージを自動生成する。生成されるログには、一定時間に処理する量であるスループット、学習状態の保存地点であるチェックポイント、処理の進行停止を確認するハング検知が含まれ、アプリから復旧サービスに必要な情報を渡しやすくなる。
このトレーニングテレメトリクライアントは、NVIDIA PyPIから次のコマンドでインストールする。
pip install --extra-index-url https://pypi.nvidia.com --upgrade aidot_training_telemetry4. 適用するジョブと機器を先に確認
リリースノートの構成要素表では、DGX B200・B300とGB200・GB300 NVL72シリーズで、ジョブ管理と二つの自己復旧コンポーネントをサポートすると示されている。既存の対応機器を運用するチームにとっては、Kubernetes学習の復旧フローを拡張する選択肢ができたことになる。
リリースノートが明記するジョブ復旧の適用対象は、Kubeflow PyTorch学習オペレーターを使うジョブだ。Vera Rubin NVL72は今回のリリースでは必須の初期立ち上げサポートに限られ、Run:aiと自己復旧エンジンはサポートしない。
5. 手動対応を減らす代わりに連携の準備が必要
自動復旧の利点は、機器の修理完了までジョブの再開を延期せず、一時的なソフトウェアエラーのために正常な機器を隔離することも減らせる点にある。NVIDIAは、この分離が停止時間と不要なリソースの浪費を減らす運用効果につながると説明する。
その代わり、運用チームには学習アプリのログ統合や復旧コンポーネントのインストールなどの準備作業が残る。ハードウェア自己復旧ではDatadog、FluentBit、Elasticとの連携が削除されており、これらのツールに依存していた監視経路、つまりシステム状態を収集して確認する方法の見直しも導入コストに含まれる。
Mission Control 2.5の価値は、ジョブの再開と機器の診断を分離し、Kubernetes学習の復旧を手動対応から連携した運用フローへ移すことにある。