一个面向希望在个人电脑上运行大型 AI 模型的开发者的推理项目更名,并增加了支持的模型。项目还公布了用单张显卡运行 5520 亿参数模型的结果,但这些数据来自同时配备大容量内存和高速存储的电脑。
1. 更名与引擎整合
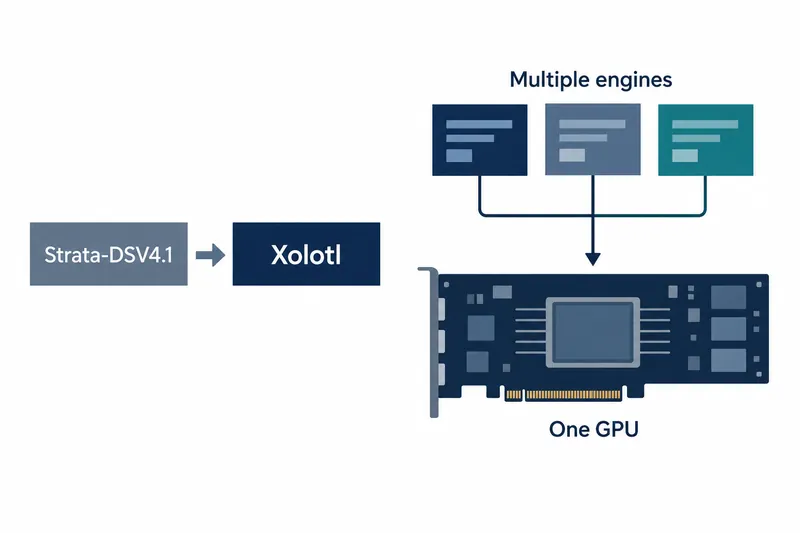
2026 年 10 月 17 日的模型卡更新宣布,Strata-DSV4.1 更名为 Xolotl。原有引擎保留,旧链接会跳转至新仓库。这不只是更名,还将多个模型的运行代码整合到了同一仓库。
在原有 DeepSeek-V4.1-Flash 的基础上,新增了 GLM-5.3-Flash 引擎。
Qwen3.8-Flash-Next 和 Qwen3.8-27B 也由同一服务器体系支持。
项目提供兼容 OpenAI 和 Anthropic 的 API,因此可以连接现有客户端。不过,各模型的配置和运行命令不同,并不意味着同一个服务器会自动切换模型。
2. 每秒约 27 个 token 的测试条件
测试电脑配备 RTX 4090 24 GB、Ryzen 7 5700X、90 GB DDR4 内存和一块 NVMe 存储设备。在实际服务器上执行了 21 道编程题、10 次工具调用和 3 项智能体错误修复任务。每次选择最可能的 token,并将推理预算设为 32K 个 token。
README 和模型卡列出的 DeepSeek 生成速度为每秒 26.8 个 token。但基准测试文档中的完成结果为 26.4 个 token。项目未提供解释两项记录差异的依据。据报告,21 道编程题、10 次工具调用和 3 项错误修复任务均通过。
在同一组任务中,GLM 每秒生成 25.3 个 token,并通过了 19 道编程题。测试采用了减少部分计算的设置及 0.25 的路由偏置。Qwen 的两个模型分别达到每秒 127.8 和 98.5 个 token,但模型大小和压缩方式不同,不能据此判断引擎本身的优劣。
长输入下的结果有所不同。在其他应用显存占用低于 1 GB 的单独测试中,输入约 6K、16.5K 个新 token 后再生成 256 个 token,DeepSeek 的速度分别为每秒 23.5、21.2 个 token。不能将短编程题中约 27 个 token 的速度直接套用于长对话。
3. 节省内存的代价
MoE 是一种每个 token 仅使用部分专家计算模块的模型架构。将常用计算模块放在显存中,其余分布在 RAM 和 NVMe 上,类似于只把需要的书搬到桌上。这不意味着整个模型都能装进 24 GB 显存。
路由偏置通过给显存中的专家加分、给 NVMe 中的专家减分,来减少磁盘读取。由于参与计算的专家发生变化,提速可能带来质量损失。当前默认值为此前强度的 0.5 倍,应与模型卡历史对比表中记录的全强度默认值区分开来。
4. 准备与运行
DeepSeek 引擎面向 Linux,尚未验证 16 GB 显存配置及 WSL2 运行。减少系统 RAM 会增加磁盘读取量,从而降低速度。
由于采用按专家压缩的格式,发布文件无法由常规的 llama.cpp 或 Ollama 读取。
模型卡指出,163 GB 的模型加上 203 GB 的 Engram 内存表,共需约 366 GB 的高速 SSD 空间。提取表时还需要约 203 GB 的额外空间;合并模型分片时,也需预留额外空间,或选择删除已合并的分片。
准备好模型和单独发布的表并构建引擎后,修改配置文件中的模型路径。README 中的服务器启动示例如下。
python3 tools/v41/serve/serve_ds41.py --engine strata --config tools/v41/serve/strata-ds41.json --port 8150 # DeepSeek-V4.1-Flash5. 能够运行不等于质量相当
在使用相同提示词、温度设为 0 的 7 项多步骤编程任务中,官方 API 解决了 5 项,采用默认偏置的本地模型解决了 4 项。样本较小,且本地模型同时进行了压缩和拒绝倾向移除,无法分离差异的成因。也未确认 API 是否使用完全相同的检查点。
Xolotl 的成果在于拓宽了大型模型的本地运行选择,不能仅凭约 27 个 token 的速度就认定其质量与官方服务相同。