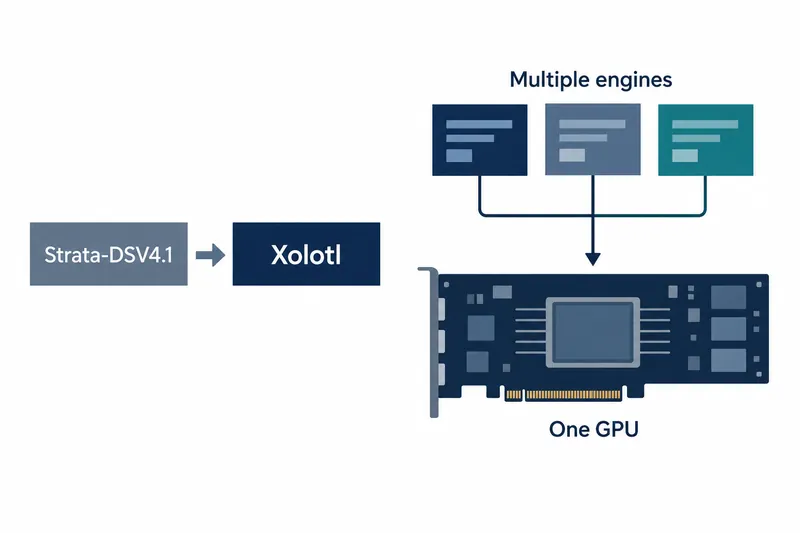
個人用PCで大型AIモデルを実行したい開発者向けの推論プロジェクトが名称を変更し、対応モデルを増やした。グラフィックカード1枚で5520億パラメータのモデルを実行した結果も公開したが、大容量メモリと高速ストレージも備えたPCでの数値だ。
1. 名称変更とエンジン統合
2026年10月17日のモデルカード更新で、Strata-DSV4.1の新名称がXolotlだと発表された。既存のエンジンは維持され、以前のリンクは新しいリポジトリにつながる。単なる名称変更にとどまらず、複数モデルの実行コードを1つのリポジトリにまとめた。
従来のDeepSeek-V4.1-FlashにGLM-5.3-Flashエンジンが加わった。
Qwen3.8-Flash-NextとQwen3.8-27Bも同じサーバー構成で対応する。
OpenAIおよびAnthropic互換APIを提供するため、既存のクライアントを接続できる。ただし、モデルごとに設定と実行コマンドは異なり、1つのサーバーがモデルを自動で切り替えるという意味ではない。
2. 毎秒約27トークンの測定条件
測定用PCはRTX 4090 24 GB、Ryzen 7 5700X、DDR4メモリ90 GBとNVMeストレージ1台を備えていた。実際のサーバーでコード問題21問、ツール呼び出し10件、エージェントによるバグ修正3件を実行した。毎回最も確率の高いトークンを選び、推論予算は32Kトークンに設定した。
READMEとモデルカードはDeepSeekの生成速度を毎秒26.8トークンとしている。しかし、ベンチマーク文書の完了結果は26.4トークンだ。両記録の差を説明する根拠は示されていない。コード問題21問、ツール呼び出し10件、バグ修正3件はすべて合格したと報告した。
同じ課題群でGLMは毎秒25.3トークンを生成し、コード問題19問に合格した。この際、一部の計算を減らす設定とルーティングバイアス0.25を使用した。Qwenの2モデルはそれぞれ毎秒127.8トークンと98.5トークンを記録したが、モデルの規模と圧縮方式が異なり、エンジンだけの優劣とは見なせない。
長い入力では結果が変わる。他のアプリによるグラフィックメモリ使用量が1 GB未満の別測定では、約6K・16.5Kトークンの新規入力後に256トークンを生成した際、DeepSeekの速度はそれぞれ毎秒23.5・21.2トークンだった。短いコード問題での約27トークンを長い会話にそのまま当てはめてはならない。
3. メモリ節約の代償
MoEはトークンごとに一部のエキスパート計算部だけを使うモデル構造だ。よく使う計算部をグラフィックメモリに、残りをRAMとNVMeに分けて置く方式は、必要な本だけを机の上に移すことに似ている。モデル全体が24 GBのグラフィックメモリに収まるという意味ではない。
ルーティングバイアスは、グラフィックメモリ内のエキスパートに加点し、NVMe上のエキスパートには減点してディスク読み込みを減らす。速度を得る代わりに計算に参加するエキスパートが変わるため、品質が低下する可能性がある。現在のデフォルト値は以前の強度の0.5倍であり、モデルカードの過去の比較表に記載された最大強度のデフォルト値とは区別する必要がある。
4. 準備と実行
DeepSeekエンジンはLinux用であり、16 GBのグラフィックメモリやWSL2での実行は検証されていない。システムRAMを減らすとディスクから読み込む量が増え、速度が低下する。
配布ファイルはエキスパートごとの圧縮形式を採用しているため、一般的なllama.cppやOllamaでは読み込めない。
モデルカードは、モデル163 GBとEngramメモリテーブル203 GBを合わせて、約366 GBの高速SSD容量が必要だと案内している。テーブル抽出中は約203 GBが追加で必要となり、モデルの分割ファイルを結合する際も、別途空き容量を確保するか、結合済みの分割ファイルを削除する方式を選ぶ必要がある。
モデルと別配布のテーブルを準備してエンジンをビルドした後、設定ファイルのモデルパスを修正する。READMEのサーバー実行例は次のとおりだ。
python3 tools/v41/serve/serve_ds41.py --engine strata --config tools/v41/serve/strata-ds41.json --port 8150 # DeepSeek-V4.1-Flash5. 実行可能性と品質の同等性は異なる
同じプロンプトと温度0で実行した7件の多段階コーディング課題では、公式APIは5件、デフォルトのバイアスを使ったローカルモデルは4件を解決した。標本が小さく、ローカルモデルには圧縮と拒否傾向の除去が同時に適用されており、差の原因を切り分けられなかった。APIが厳密に同じチェックポイントかどうかも確認されていない。
Xolotlの成果は、大型モデルをローカルで実行する選択肢を広げたことにあり、約27トークンという速度だけで公式サービスと品質が同じだとは判断できない。