TensorRT 11.1 新增自动调优器 Global Performance Tuner,可探索引擎(执行推理的可执行文件)本身的构建方式。NVIDIA 表示,指定参考输出与阈值并启用准确度验证后,仅对达标候选排名,这一机制可自动化原本需针对各模型和 GPU 手动调整的推理优化流程。TensorRT 11.1 于 2026 年 6 月 24 日发布,截至 2026 年 10 月,最新版本为 11.4。
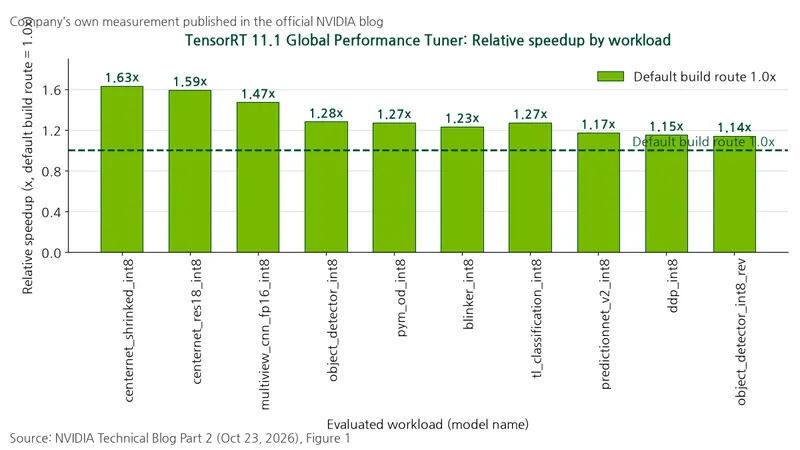
根据 NVIDIA 于 2026 年 10 月 23 日发布的官方博客,10 个工作负载(计算机需要处理的一组任务)相对默认构建路径的性能提升倍数介于 1.14 倍至 1.63 倍之间。
测量方法
对象:TensorRT 11.1 Global Performance Tuner,trtexec --tuneBuildRoutes 调优循环。基准:将所有 knob(编译器设置开关)均为默认值的默认构建路径归一化为 1.0x,据此换算数值。候选判定:丢弃崩溃路径;启用准确度验证时,也丢弃验证失败的路径,从达标候选中选择最快引擎。数值来源:NVIDIA 官方博客 Part 2 Figure 1,2026 年 10 月 23 日。
结果
表:各工作负载调优后相对默认路径的性能
条件:TensorRT 11.1 调优器,NVIDIA 官方博客 Figure 1 中的 10 个工作负载,原文未公开 GPU、批大小及搜索路径数量
单位:相对性能倍数(倍)
| 工作负载模型 | 默认构建路径 | 调优后相对性能 |
|---|---|---|
| centernet_shrinked_int8 | 1.0 | 1.63 |
| centernet_res18_int8 | 1.0 | 1.59 |
| multiview_cnn_fp16_int8 | 1.0 | 1.47 |
| object_detector_int8 | 1.0 | 1.28 |
| pym_od_int8 | 1.0 | 1.27* |
| blinker_int8 | 1.0 | 1.23 |
| tl_classification_int8 | 1.0 | 1.27* |
| predictionnet_v2_int8 | 1.0 | 1.17* |
| ddp_int8 | 1.0 | 1.15 |
| object_detector_int8_rev | 1.0 | 1.14 |
注:* 为原图标记,原文未解释其含义。
提升幅度分布并不均匀。相对基准线,前三个工作负载的性能增长为 47~63%,而后三个为 14~17%,因此需分别测量各模型的收益。这些数值是 NVIDIA 公布的自测结果。
为何存在这些差异
第一,默认构建路径是固定内部启发式规则(即工程师预设的判断规则)的一种优化方式。NVIDIA 解释,没有任何一种方式对所有模型都是最优的。
第二,单独测量内核(在 GPU 上运行的计算单元)的耗时,其总和并不等于整个引擎的运行时间。Global Performance Tuner 的调优循环测量并优化的是从输入到输出的整体性能,而非逐层基准测试。
第三,加入准确度条件后,候选本身也会减少。NVIDIA 提出一个思想实验:切换四个设置的开关会产生 16 个候选,准确度标准越严格,达标候选就越少。这并非某个 TensorRT 版本的实际设置,而是用于解释准确度约束作用的概念示例。
局限
官方博客未披露 Figure 1 的 GPU 型号、批大小及搜索的路径数量。官方文档指出,默认构建路径可能已经最优,收益因模型、硬件和版本而异,且非默认路径在 TensorRT 主要版本之间没有性能保证。
选择标准
先测量默认路径。根据搜索空间大小选择搜索策略。fast 每次只改变一个 knob,因此随 knob 数量线性增长;mixed 则在 fast 之后,仅穷举带来改进的 knob 组合。full 生成所有组合,呈指数增长。官方仓库的实现(trtexec sampleTuning.h)将传入 mixed 第 2 阶段的改进 knob 限制为 10 个(kMixedSearchMaxPositiveKnobs)。先固定准确度标准。必须同时指定参考输出和阈值,才会启用验证。损失指标即量化输出差异的标准,默认为 l0,也可选择 l1、l2、lInf、cos。标准过严可能淘汰所有提速路径,因此应根据部署应用的实际质量要求,使用包含代表性输入和重要边界案例的参考输出来确定容差。官方文档的运行示例如下。
  trtexec --onnx=model.onnx \
  --tuneBuildRoutes="-match_ragged_mha=[on|off]" \
  --loadInputs=input:input.bin \
  --loadRefOutputs=output:ref_output.bin \
  --accuracyThreshold=0.5 \
  --saveEngine=best.plan
通过标志控制成本。--dryRun 不执行构建,仅显示候选路径列表,可在实际搜索前运行以估算规模。官方文档称它可搭配任何搜索模式,但官方博客称不能用于 mixed 搜索,因此按博客说明,仅在 fast 或 full 中预览。--tuningCacheFile 可将每轮的路径、GPU 耗时和准确度逐行记录为 JSON,并通过 --continue 继续;--tuningTimeOut 可设置总时间预算。--saveAllEngines 保留所有引擎,会占用大量磁盘空间,主要用于调试。迁移时需匹配版本。knob 及默认值随调优器版本而变,因此搜索和部署应使用相同的 TensorRT 及调优器版本。模型、shape(输入数据的大小和结构)、GPU 或 CUDA 发生变化时,需重新调优。
启用准确度验证后,准确度标准决定候选资格,整体运行性能决定达标候选中的胜者。