TensorRT 11.1이 엔진(추론을 수행하는 실행 파일)의 빌드 방식 자체를 탐색하는 자동 튜너 'Global Performance Tuner'를 추가했다. NVIDIA는 참조 출력과 임계값을 지정해 정확도 검증을 켠 경우 통과한 후보끼리만 순위를 매기며, 이 구조로 모델과 GPU마다 손대던 추론 최적화 공정을 자동화할 수 있다고 설명했다. TensorRT 11.1은 2026년 6월 24일 나왔고 2026년 10월 기준 최신 릴리스는 11.4다.
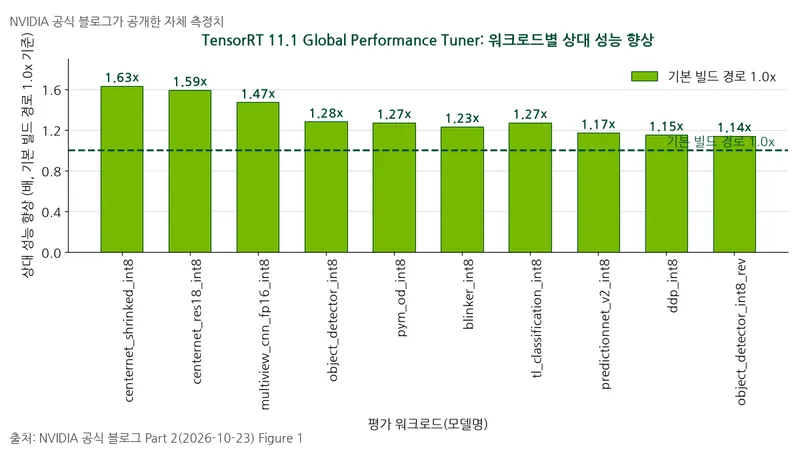
NVIDIA가 2026년 10월 23일 공개한 공식 블로그를 보면, 10개 워크로드(컴퓨터가 처리할 작업의 묶음)에서 기본 빌드 경로 대비 상대 성능 향상 배율은 1.14배에서 1.63배 사이였다.
측정 방법
대상은 TensorRT 11.1 Global Performance Tuner의 trtexec --tuneBuildRoutes 튜닝 루프다. 기준은 모든 knob, 즉 컴파일러 설정 스위치를 기본값으로 둔 기본 빌드 경로이며, 이를 1.0x로 정규화해 값을 환산한다. 후보 판정에서는 크래시한 경로와 정확도 검증을 켠 경우 검증에서 탈락한 경로를 제외하고, 통과한 후보 중 가장 빠른 엔진을 선택한다. 수치 출처는 NVIDIA 공식 블로그 Part 2 Figure 1, 2026년 10월 23일이다.
결과
표: 워크로드별 기본 경로 대비 튜닝 성능
조건: TensorRT 11.1 튜너, NVIDIA 공식 블로그 Figure 1의 10개 워크로드, GPU·배치·검색 경로 수 원문 미공개
단위: 상대 성능 배율(배)
| 워크로드 모델 | 기본 빌드 경로 | 튜닝 후 상대 성능 |
|---|---|---|
| centernet_shrinked_int8 | 1.0 | 1.63 |
| centernet_res18_int8 | 1.0 | 1.59 |
| multiview_cnn_fp16_int8 | 1.0 | 1.47 |
| object_detector_int8 | 1.0 | 1.28 |
| pym_od_int8 | 1.0 | 1.27* |
| blinker_int8 | 1.0 | 1.23 |
| tl_classification_int8 | 1.0 | 1.27* |
| predictionnet_v2_int8 | 1.0 | 1.17* |
| ddp_int8 | 1.0 | 1.15 |
| object_detector_int8_rev | 1.0 | 1.14 |
주: *는 원그림의 표시이며 원문에 의미 설명 없음.
상승 폭이 고르게 분포하지 않는다. 기준선 대비 상위 세 워크로드의 성능 증가는 47~63%인 반면 하위 세 워크로드는 14~17%여서, 이득을 모델별로 따로 측정해야 한다. 이 수치는 NVIDIA가 공개한 자체 측정치다.
왜 이런 차이가 나나
첫째, 기본 빌드 경로는 내부 휴리스틱, 즉 엔지니어가 규칙으로 박아 둔 판단을 고정한 한 가지 최적화 방식이다. 어떤 방식도 모든 모델에 최선은 아니라는 게 NVIDIA의 설명이다.
둘째, 커널, GPU에서 실행되는 계산 단위를 따로 측정한 시간의 합이 엔진 전체 실행 시간과 같지는 않다. Global Performance Tuner의 튜닝 루프는 레이어 단위 벤치마크가 아니라 입구부터 출력까지의 전체 성능을 측정하고 최적화한다.
셋째, 정확도 조건까지 얹히면 후보 자체가 줄어든다. NVIDIA는 설정 네 개를 켜고 끄면 후보 16개가 생기고, 정확도 기준을 엄격하게 할수록 통과 후보가 줄어드는 사고 실험을 제시한다. 이는 특정 TensorRT 릴리스의 실제 설정이 아니라 정확도 제약의 역할을 설명하는 개념 예시다.
한계
공식 블로그는 Figure 1의 GPU 모델과 배치 크기, 검색한 경로 수를 밝히지 않았다. 공식 문서는 기본 빌드 경로가 이미 최적일 수 있고 이득이 모델과 하드웨어와 버전에 따라 달라지며, 비기본 경로에는 주요 TensorRT 릴리스 간 성능 보장이 없다고 적어 두었다.
고를 때 기준
기본 경로는 먼저 측정해 둔다. 검색 전략은 공간 크기에 맞춰 고른다. fast는 knob 하나씩만 바꿔 가므로 knob 수에 선형이고, mixed는 fast 이후 개선된 knob 조합만 전수 조사한다. full은 모든 조합을 만들어 지수적으로 늘어난다. 공식 저장소 구현(trtexec sampleTuning.h)은 mixed 2단계에 넘기는 개선 knob을 10개로 제한한다(kMixedSearchMaxPositiveKnobs). 정확도 기준을 먼저 고정한다. 참고 출력과 임계값을 함께 지정해야 검증이 켜진다. 손실 지표, 출력 차이를 수치화한 기준은 l0가 기본값이며 l1, l2, lInf, cos 중에서 고른다. 기준이 너무 엄격하면 속도 개선 경로가 전부 탈락할 수 있으니, 배포 애플리케이션의 실제 품질 요구에 맞는 허용오차를 대표 입력과 중요한 경계 사례를 담은 참고 출력으로 정한다. 공식 문서의 실행 예제는 다음과 같다.
  trtexec --onnx=model.onnx \
  --tuneBuildRoutes="-match_ragged_mha=[on|off]" \
  --loadInputs=input:input.bin \
  --loadRefOutputs=output:ref_output.bin \
  --accuracyThreshold=0.5 \
  --saveEngine=best.plan
비용은 플래그로 조절한다. --dryRun은 빌드 없이 후보 경로 목록만 보여 주므로 실제 탐색 전에 먼저 돌려 규모를 잰다. 공식 문서는 어떤 검색 모드와도 붙여 쓸 수 있다고 적지만 공식 블로그는 mixed 검색과는 쓸 수 없다고 적어, 블로그 기준 fast나 full에서만 미리 본다. --tuningCacheFile로 반복마다 경로와 GPU 시간과 정확도를 JSON 한 줄씩 남겨 --continue로 이어가고, --tuningTimeOut으로 전체 시간 예산을 둔다. --saveAllEngines는 모든 엔진을 남겨 디스크를 많이 쓰므로 주로 디버깅할 때 쓴다. 옮길 때 버전을 맞춰야 한다. knob과 기본값은 튜너 버전에 따라 달라지므로 탐색과 배포를 같은 TensorRT와 같은 튜너 버전에서 한다. 모델이나 shape, 입력 데이터의 크기와 구조나 GPU나 CUDA가 바뀌면 다시 튜닝한다.
정확도 검증을 켜면 정확도 기준이 후보 자격을 정하고, 전체 실행 성능이 통과한 후보 중 승자를 정한다.