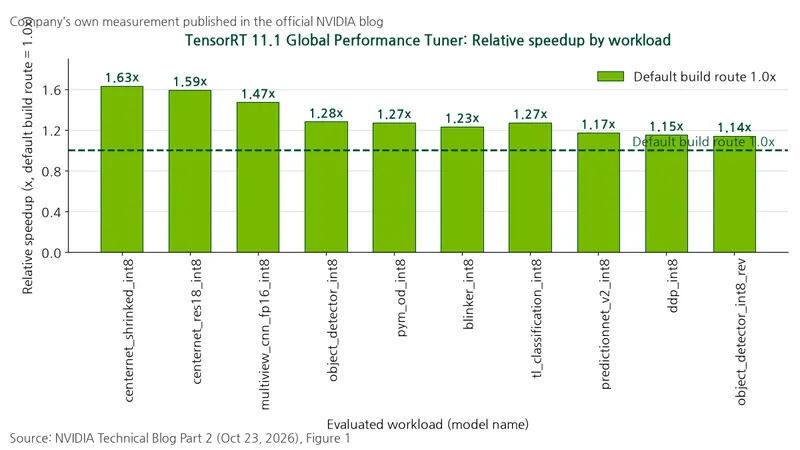
TensorRT 11.1は、エンジン(推論を実行する実行ファイル)のビルド方法そのものを探索する自動チューナー「Global Performance Tuner」を追加した。NVIDIAによると、参照出力としきい値を指定して精度検証を有効にした場合、合格した候補だけを順位付けする。この仕組みにより、モデルやGPUごとに調整していた推論最適化の工程を自動化できるという。TensorRT 11.1は2026年6月24日にリリースされ、2026年10月時点の最新リリースは11.4だ。
NVIDIAが2026年10月23日に公開した公式ブログによると、10ワークロード(コンピューターが処理する作業のまとまり)で、デフォルトのビルド経路に対する相対的な性能向上倍率は1.14倍から1.63倍だった。
測定方法
対象:TensorRT 11.1 Global Performance Tuner、trtexec --tuneBuildRoutesのチューニングループ。基準:すべてのknob、つまりコンパイラー設定スイッチをデフォルト値にしたビルド経路を1.0xに正規化し、値を換算。候補の判定:クラッシュした経路を除外し、精度検証を有効にした場合は検証に不合格の経路も除外して、合格した候補から最速のエンジンを選択。数値の出典:NVIDIA公式ブログPart 2 Figure 1、2026年10月23日。
結果
表:ワークロード別のデフォルト経路に対するチューニング性能
条件:TensorRT 11.1チューナー、NVIDIA公式ブログFigure 1の10ワークロード、GPU・バッチ・探索経路数は原文で非公開
単位:相対性能倍率(倍)
| ワークロードモデル | デフォルトのビルド経路 | チューニング後の相対性能 |
|---|---|---|
| centernet_shrinked_int8 | 1.0 | 1.63 |
| centernet_res18_int8 | 1.0 | 1.59 |
| multiview_cnn_fp16_int8 | 1.0 | 1.47 |
| object_detector_int8 | 1.0 | 1.28 |
| pym_od_int8 | 1.0 | 1.27* |
| blinker_int8 | 1.0 | 1.23 |
| tl_classification_int8 | 1.0 | 1.27* |
| predictionnet_v2_int8 | 1.0 | 1.17* |
| ddp_int8 | 1.0 | 1.15 |
| object_detector_int8_rev | 1.0 | 1.14 |
注:*は元の図の表記であり、原文に意味の説明はない。
向上幅は均等ではない。基準線に対する上位3ワークロードの性能向上は47~63%だが、下位3ワークロードは14~17%のため、効果をモデル別に測定する必要がある。この数値はNVIDIAが公開した自社測定値だ。
なぜこの差が生まれるのか
第一に、デフォルトのビルド経路は、内部ヒューリスティクス、つまりエンジニアが規則として組み込んだ判断を固定した1つの最適化方法だ。どの方法もすべてのモデルに最適とは限らない、というのがNVIDIAの説明だ。
第二に、カーネル、つまりGPUで実行される計算単位を個別に測定した時間の合計は、エンジン全体の実行時間と同じではない。Global Performance Tunerのチューニングループは、レイヤー単位のベンチマークではなく、入力から出力までの性能全体を測定し、最適化する。
第三に、精度条件も加わると、候補自体が減る。NVIDIAは、4つの設定をオン・オフすると16候補が生まれ、精度基準を厳しくするほど合格候補が減るという思考実験を示している。これは特定のTensorRTリリースの実際の設定ではなく、精度制約の役割を説明する概念的な例だ。
限界
公式ブログはFigure 1のGPUモデル、バッチサイズ、探索した経路数を明らかにしていない。公式ドキュメントには、デフォルトのビルド経路がすでに最適な場合もあり、効果はモデル、ハードウェア、バージョンによって変わり、非デフォルト経路にはTensorRTのメジャーリリース間での性能保証がないと記されている。
選択時の基準
デフォルト経路を先に測定しておく。探索戦略は探索空間の大きさに合わせて選ぶ。fastはknobを1つずつ変えるためknob数に対して線形で、mixedはfastの後、改善したknobの組み合わせだけを全数調査する。fullはすべての組み合わせを作るため、指数関数的に増える。公式リポジトリの実装(trtexec sampleTuning.h)では、mixedの第2段階に渡す改善knobを10個に制限している(kMixedSearchMaxPositiveKnobs)。精度基準を先に固定する。検証を有効にするには参照出力としきい値を両方指定する必要がある。損失指標、つまり出力の差を数値化する基準はl0がデフォルトで、l1、l2、lInf、cosから選ぶ。基準が厳しすぎると高速化する経路がすべて不合格になる可能性がある。代表的な入力と重要な境界事例を含む参照出力を使い、配備先アプリケーションの実際の品質要件に合う許容誤差を定める。公式ドキュメントの実行例は次のとおりだ。
  trtexec --onnx=model.onnx \
  --tuneBuildRoutes="-match_ragged_mha=[on|off]" \
  --loadInputs=input:input.bin \
  --loadRefOutputs=output:ref_output.bin \
  --accuracyThreshold=0.5 \
  --saveEngine=best.plan
コストはフラグで調整する。--dryRunはビルドせずに候補経路の一覧だけを表示するため、実際の探索前に実行して規模を把握する。公式ドキュメントにはどの探索モードでも併用できるとあるが、公式ブログにはmixed探索では使えないとあるため、ブログに従ってfastかfullでのみ事前確認する。--tuningCacheFileで各反復の経路、GPU時間、精度をJSONで1行ずつ記録し、--continueで再開する。--tuningTimeOutで全体の時間予算を設定する。--saveAllEnginesはすべてのエンジンを保存してディスクを大量に使うため、主にデバッグ時に使う。移行時はバージョンをそろえる必要がある。knobとデフォルト値はチューナーのバージョンによって変わるため、探索と配備を同じTensorRTと同じチューナーのバージョンで行う。モデルやshape、入力データの大きさや構造、GPU、CUDAが変わったら再チューニングする。
精度検証を有効にすると、精度基準が候補の適格性を決め、実行全体の性能が合格した候補の中から勝者を決める。