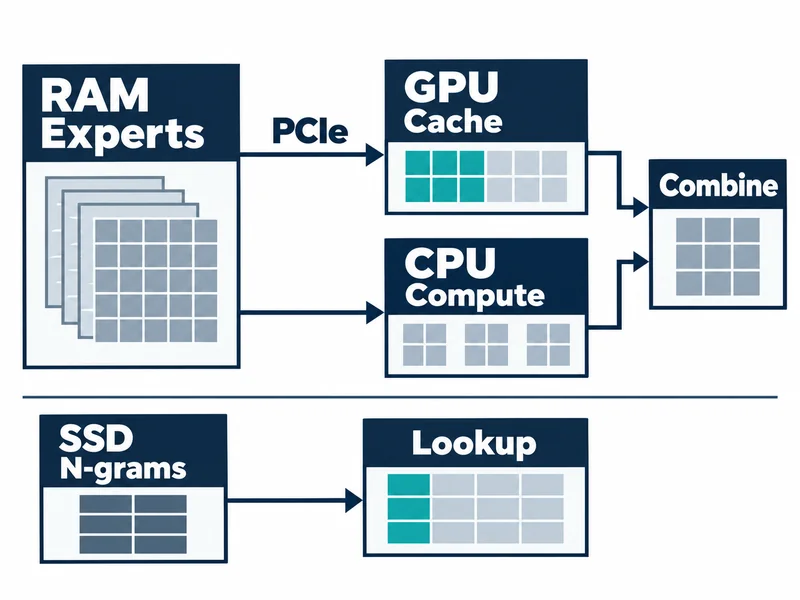
Strata 是一款推理引擎,把比 GPU 显存更大的模型拆分到 GPU、内存、CPU 和 SSD 上运行。默认配置下,它把全部 24,576 个专家放在内存中,并把最常用的专家缓存在 GPU 显存里。
本文依据 10 月 4 日发布的 v0.1.39 和固定提交的文档来考察这种布局。性能数字来自项目和公开测试者的报告,并非 devotd 在硬件上复现的结果。
大模型的每个部分并非时刻都在忙
Strata 面向的 Qwen3.8-Flash-Next 是混合专家(MoE)模型,由路由器为每个输入挑选所需专家。官方模型卡写明 125B 参数中激活 6B,另有 51B 的 n-gram 嵌入和 4B 的 MTP 参数。
当前没用到的专家,在下一个 token 或其他层中也可能被选中。因此需要让全部权重都可访问,同时快速使用眼下需要的那一部分。
选择把哪些权重放在近处
经常被选中的专家值得留在快速内存中。如果连很少用的专家也都放在 GPU 上,显存需求会变大;全部放远处,数据移动又会吃掉计算量小的优势。
Strata 的模型指南只涵盖 Qwen3.8-Flash-Next 及其量化和衍生模型。仅凭文件格式相同,没有依据认为其他模型也会得到相同的布局效果。
各层内存承担的数据
显存中放着注意力和 DeltaNet 混合器、路由器、共享专家、输出头、MTP 草拟层以及 KV 缓存。从 64K 起,KV 缓存只有最常读取的部分留在显存,其余从内存流式读取。
剩余显存由存放最常用专家的专家缓存填满,并随对话调整。因此 GPU 显存总量并不等于专家缓存容量。
内存中固定(pinned)存放全部 24,576 个专家。SSD 上有 28.8GB 的 n-gram 表,每个 token 只绕过操作系统缓存读取其中几行。
容量、带宽与延迟
评估布局时,可以把容量(能放多少)、带宽(单位时间能搬多少)和延迟(请求后要等多久)分开看。
把更多专家放进显存能减少移动,但 KV 缓存和计算缓冲区也要用同一块显存。选择更长的上下文,会改变留给专家的空间。
存储位置不等于计算位置
放在内存里的权重不一定由 CPU 计算。GPU 缓存中的专家由 GPU 处理,GPU 上没有的专家由 CPU 直接在内存中就地计算。
CPU 的计算与 GPU 处理缓存专家同时进行。文档还单独讨论了显存中缺失的专家里,有多大比例改为复制到 GPU 而不是由 CPU 计算。
必须一起完成的工作
CPU 那部分如果完成得晚,GPU 再快也无法完成这一步。如果主要等待来自数据移动,只提高算力可能收效甚微。
自适应缓存会根据使用情况更换放在 GPU 上的专家。它并不改变模型选择的专家,而是调整同一计算在哪里执行。
SSD 上的 n-gram 表按小块读取
模型卡把 n-gram 嵌入描述为以短 n-gram 为索引的组件,并称它适合在内存受限的加速器上做卸载。
Strata 的 IQ4_NL 表有 320,001,536 行、每行 90 字节(26.8GiB)。一个 token 需要位于 16 个不同页面上的 16 行,每行都通过无缓冲的 4KiB 读取获得。
已经读取过的行会留在容量有限的行缓存中。对这类查询来说,小读取能否及时完成比 SSD 的顺序读取速度更重要。
低内存模式的两种变体
默认配置会把全部专家(23~50GB)复制到内存,但内存不足时,setup 会选择从模型目录中的文件映射专家的低内存模式。文档指出,如果 GPU 较小,大部分专家就要从 SSD 读取,速度会慢很多。
引擎 0.1.30 的 resident 变体用于 GPU 上没有的专家能放进内存的情况,让内存副本只保存 GPU 所缺的专家。即使同为低内存模式,速度也取决于所需权重最终留在哪一层。
从 SSD 供应专家时的规模
实验性的 UD-Q4_K_XL 文档是在一台配备 Windows 10、RTX 5070 12GB、64GB 内存和 AVX-512 CPU 的电脑上验证的。在 40GiB 内存预算下,同一个简短 greedy 提示跑 6 次,得到 6.7~8.6 tok/s,平均 7.9 tok/s。
此时每个验证轮次从 SSD 读取 1.1GB,约合每个 token 0.33GB。这是开发者在一台特定电脑上测得的数值。
每个 token 0.33GB 乘以 8 tok/s,约为每秒 2.64GB 的专家读取量。这是由文档数字换算而来,并非单独测得的 SSD 吞吐量。
SSD 可以缓解容量限制,但相应的数据移动成本依然存在。
读取提示与写出回答时
预填充把长输入按 token 分块处理,一次准备好的专家权重可以服务多个 token。Strata 的预填充路径会按固定顺序通过环形缓冲区,把 GPU 上没有的专家流式送到 GPU。
源码注释记录,在 8,192 token 分块下,把环从 96 槽增加到 384 槽,速度从 1,153 提升到 1,294 tok/s。环越大,占用的专家缓存槽也越多,因此分块大小与缓存空间之间需要平衡。
解码要根据已生成的 token 决定下一个 token,很难像预填充那样一次把大量工作打包。
因此,读长文档后简短回答的任务,与对简短问题给出长回答的任务,可能适合不同的配置。
用草拟 token 提高生成速度的 MTP
Strata 用模型的 MTP 层草拟最多 3 个 token,再一次通过全部 48 层进行验证。文档称平均每次可得到 2.4~3.2 个 token。
被接受的数量取决于生成的内容。这也是同一台电脑上每秒 token 数会随提示和回答类型变化的原因之一。
注意事项:同一个模型不等于同样的 token
文档说明,即使 temperature 为 0,只要草拟、缓存状态或续接的对话不同,同一个提示也可能得出不同的(同样合理的)回答。要实现逐字节相同的重复,需要额外的选项。
运行同一个模型,与在所有设置下输出相同的 token,是强度不同的两种说法。
每秒 token 数与实际等待的时间
engine 0.1.26 基准运行在 RTX 5070 12GB(PCIe 5.0 x16)、Ryzen 5 7600、64GB DDR5-5200 和 Windows 10 上。采用 setup 默认设置并开启 MTP 和 greedy,生成 256 个 token,关闭图像功能,每种条件各跑一次。
原始记录中,Q2_0 的 32K 输入为 31,566 个 token,预填充 2,170.85 tok/s,生成 81.75 tok/s,首个 token 用时 16.02 秒。81.75 tok/s 是回答开始之后的速度,此前等待的 16.02 秒是另一回事。
读文档后简短回答的服务,首次响应等待占比大;写长草稿的任务,生成速度占比大。对编码智能体来说,包括工具执行和重试在内的完成时间才重要。
PP(预填充)、TG(生成)和 TTFT(首 token 时间)测量的是不同阶段。
上述记录的引擎版本是 0.1.26。v0.1.39 的发布说明表示,这次发布没有重新测量 README 中的速度表。
因此这些数字只是一个记录完善的参考点,而非最新版本的保证值。
加快单个请求与处理多个请求
9 月 29 日,rhgo1749 在 GitHub issue #127 中介绍了一种实验配置:每块 GPU 运行一个独立的 Strata 引擎,每个请求分配给一条 GPU 通道。大型主机专家区通过 Linux 的 MAP_SHARED 在各通道进程间共享。
在 3 块 RTX 5070 Ti 16GB、IQ3_XXS、每条通道 262K 上下文的条件下,预热后的生成速度分别为 78.8、78.4 和 80.1 tok/s。作者明确说明,合计的 237.3 tok/s 只是各通道数值的简单相加,并不是时间同步的整体吞吐量。
这是独立分支中的实验实现,不能视为原版 Strata 的性能。
个人对话看重单个请求的等待,而同时运行多个智能体的服务,还看重并发请求不被积压的能力。
合计吞吐量会掩盖个别用户的等待,单请求测试则会漏掉共享资源上的争用。
小模型包不等于合适的模型
模型指南列出的专家大小为 Q2_0 34GB、IQ2_XS 35.5GB、IQ3_XXS 43GB、IQ3_S 50GB、Coder 23GB。默认配置下,还需要再为 Windows 和其他程序留出约 10GB。
Coder 是一个衍生模型,只保留了按代码数据挑选的 512 个专家中的 256 个。指南指出它在代码以外的任务和英语以外的语言上较弱。
安装指南的主要对象是 Windows 10/11 或 Linux、带 AVX2 的 x86-64 CPU,以及显存 12GB 以上的 NVIDIA RTX 20~50 系列或受支持的 AMD 显卡。Pascal、Volta 等旧款 NVIDIA 显卡在 v0.1.39 中作为实验路径加入。
磁盘方面,模型约需 70~80GB,MTP 层约需 6GB;在 AVX-512 CPU 上使用 Q2_0 时,还会一次性写入约 40GB 的副本。
Strata 引擎采用 MIT 许可证,但官方 Qwen 模型卡标注的是 Qwen Community License 1.0。模型文件适用各自的许可证。
适合自己工作的内存布局
值得拿 Strata 做比较的环境,是需要受支持模型的质量、显存不足但内存和 CPU 尚有余量的情况。第一个问题不是最大的模型包能否运行,而是所需模型包的权重在回答期间留在哪里。
把首次运行与预热状态分开,并一并记录输入长度、并发请求数、引擎与模型版本和硬件条件,就能追踪结果变化的原因。
Strata 的速度与其说取决于所运行模型的大小,不如说取决于权重留在哪一层、在哪里计算。