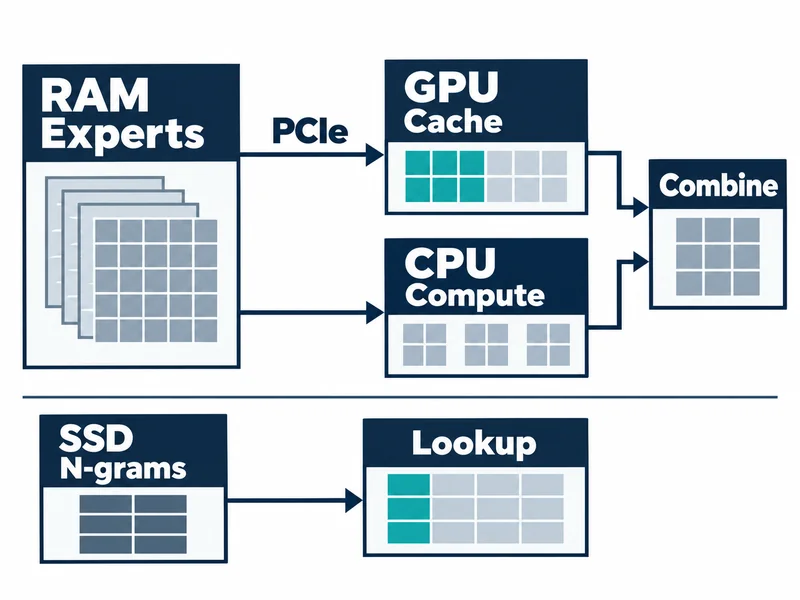
Strata는 GPU 메모리보다 큰 모델을 GPU, RAM, CPU, SSD에 나눠 실행하는 추론 엔진이다. 기본 구성에서는 전문가 24,576개 전체를 RAM에 두고, 가장 많이 쓰는 전문가를 GPU 메모리에 캐시한다.
이 글은 10월 4일 나온 v0.1.39와 고정된 커밋의 문서를 바탕으로 이 배치를 살펴본다. 성능 수치는 프로젝트와 공개 실험자의 보고이며, devotd가 하드웨어에서 재현한 결과가 아니다.
큰 모델의 모든 부분이 매 순간 바쁘지는 않다
Strata가 다루는 Qwen3.8-Flash-Next는 전문가 혼합(MoE) 모델로, 라우터가 입력마다 필요한 전문가를 고른다. 공식 모델 카드는 125B 파라미터 중 6B가 활성화되고, 이와 별도로 51B n-그램 임베딩과 4B MTP 파라미터가 있다고 적는다.
지금 쓰이지 않는 전문가도 다음 토큰이나 다른 층에서는 선택될 수 있다. 그래서 가중치 전체는 접근 가능한 곳에 두고, 지금 필요한 일부를 빠르게 쓰는 구조가 필요하다.
가까이 둘 가중치를 고르는 일
자주 선택되는 전문가는 빠른 메모리에 남겨 둘 가치가 크다. 드문 전문가까지 모두 GPU에 두면 VRAM 요구량이 커지고, 전부 멀리 두면 데이터 이동이 작은 계산량의 이점을 갉아먹는다.
Strata의 모델 안내는 Qwen3.8-Flash-Next와 그 양자화·파생 모델만 다룬다. 파일 형식이 같다는 이유만으로 다른 모델에서 같은 배치 효과가 난다고 볼 근거는 없다.
메모리 계층마다 맡는 데이터
VRAM에는 어텐션과 DeltaNet 믹서, 라우터, 공유 전문가, 출력 헤드, MTP 초안 층, KV 캐시가 들어간다. 64K부터는 KV 캐시 가운데 자주 읽는 부분만 VRAM에 두고 나머지는 RAM에서 스트리밍한다.
남은 VRAM은 가장 많이 쓰는 전문가를 담는 전문가 캐시가 채우며, 이 캐시는 대화에 맞춰 바뀐다. 그래서 GPU 메모리 전체가 곧 전문가 캐시 용량은 아니다.
RAM에는 전문가 24,576개 전체가 고정(pinned)돼 있다. SSD에는 28.8GB n-그램 표가 있고, 토큰마다 몇 행만 OS 캐시를 거치지 않고 읽는다.
용량, 대역폭, 지연 시간
배치를 평가할 때는 용량(얼마나 담는가), 대역폭(일정 시간에 얼마나 옮기는가), 지연 시간(요청한 뒤 얼마나 기다리는가)을 나눠 볼 수 있다.
전문가를 VRAM에 더 두면 이동이 줄지만, KV 캐시와 계산 버퍼도 같은 VRAM을 쓴다. 컨텍스트를 늘리는 선택은 전문가를 둘 공간을 바꾼다.
저장 위치와 계산 위치는 다르다
RAM에 있는 가중치라고 반드시 CPU가 계산하지는 않는다. GPU 캐시에 있는 전문가는 GPU가 처리하고, GPU에 없는 전문가는 CPU가 RAM에서 그 자리에서 계산한다.
CPU 계산은 GPU가 캐시된 전문가를 처리하는 동안 함께 진행된다. 문서는 VRAM에 없는 전문가 가운데 CPU 계산 대신 GPU로 복사하는 비율도 따로 다룬다.
함께 끝나야 하는 작업
CPU 몫이 늦게 끝나면 GPU가 빨라도 한 단계가 완성되지 않는다. 데이터 이동이 주된 대기라면 연산 능력만 높여서는 효과가 작을 수 있다.
적응형 캐시는 사용 양상에 따라 GPU에 둘 전문가를 바꾼다. 모델이 고른 전문가를 바꾸는 것이 아니라 같은 계산을 어디서 할지 조정하는 것이다.
SSD의 n-그램 표는 작은 조각을 읽는다
모델 카드는 n-그램 임베딩을 짧은 n-그램으로 색인하는 구성요소로 설명하며, 메모리가 제한된 가속기에서 오프로딩하기 좋다고 적는다.
Strata의 IQ4_NL 표는 90바이트 행 320,001,536개(26.8GiB)다. 토큰 하나에 서로 다른 페이지의 16개 행이 필요하고, 각 행은 버퍼 없는 4KiB 읽기로 가져온다.
이미 가져온 행은 크기가 제한된 행 캐시에 남긴다. 이런 조회에서는 SSD의 순차 읽기 속도보다 작은 읽기가 제때 끝나는지가 더 중요해진다.
저RAM 모드의 두 변형
기본 구성은 전문가 전체(23~50GB)를 RAM에 복사하지만, RAM이 부족하면 setup이 모델 폴더의 파일을 매핑하는 저RAM 모드를 고른다. 문서는 GPU가 작으면 대부분의 전문가를 SSD에서 읽게 돼 훨씬 느려진다고 밝힌다.
엔진 0.1.30의 resident 변형은 GPU에 없는 전문가가 RAM에 들어갈 때 쓰이며, RAM 복사본이 GPU가 갖지 않은 전문가만 담도록 유지한다. 같은 저RAM 모드라도 필요한 가중치가 어느 계층에 남느냐에 따라 속도가 달라진다.
SSD에서 전문가를 공급할 때의 규모
실험적 UD-Q4_K_XL 문서는 Windows 10, RTX 5070 12GB, RAM 64GB, AVX-512 CPU를 갖춘 PC 한 대에서 검증됐다. RAM 예산 40GiB에서 같은 짧은 greedy 프롬프트를 6번 돌려 6.7~8.6 tok/s, 평균 7.9 tok/s가 나왔다.
이때 SSD에서 검증 라운드마다 1.1GB, 토큰당 약 0.33GB를 읽었다. 특정 PC 한 대에서 개발자가 잰 값이다.
토큰당 0.33GB에 8 tok/s를 곱하면 초당 약 2.64GB의 전문가 읽기가 된다. 문서 수치를 환산한 계산이며, 따로 측정한 SSD 처리량은 아니다.
SSD로 용량 제약을 낮출 수는 있어도 그만큼의 데이터 이동 비용은 남는다.
프롬프트를 읽을 때와 답을 쓸 때
프리필은 긴 입력을 토큰 묶음(청크)으로 처리해, 한 번 준비한 전문가 가중치로 여러 토큰을 계산한다. Strata의 프리필 경로는 GPU에 없는 전문가를 고정된 순서로 링 버퍼에 흘려 GPU로 보낸다.
소스 주석에는 8,192토큰 청크에서 링을 96슬롯에서 384슬롯으로 늘리자 1,153에서 1,294 tok/s가 됐다는 측정이 있다. 링이 커지면 그만큼 전문가 캐시 슬롯을 차지하므로 묶음 크기와 캐시 공간 사이에 균형이 필요하다.
디코드는 앞서 만든 토큰을 바탕으로 다음 토큰을 정하므로, 프리필처럼 많은 일을 한 번에 묶기 어렵다.
그래서 긴 문서를 읽고 짧게 답하는 작업과 짧은 질문에 길게 답하는 작업은 서로 다른 구성에서 유리할 수 있다.
초안 토큰으로 생성 속도를 높이는 MTP
Strata는 모델의 MTP 층으로 최대 3개 토큰을 초안으로 만들고, 48개 층을 한 번 통과하며 검증한다. 문서는 한 번에 평균 2.4~3.2토큰을 얻는다고 밝힌다.
얼마나 많이 수락되는지는 생성하는 내용에 따라 달라진다. 같은 PC에서도 초당 토큰 수가 프롬프트와 답의 종류에 따라 바뀌는 이유 가운데 하나다.
주의할 점: 같은 모델이 같은 토큰을 뜻하지는 않는다
문서는 temperature 0에서도 초안, 캐시 상태, 이어 가는 대화가 다르면 같은 프롬프트가 다른(똑같이 괜찮은) 답으로 끝날 수 있다고 설명한다. 바이트 단위로 같은 반복에는 별도 옵션이 필요하다.
같은 모델을 실행한다는 말과 모든 설정에서 같은 토큰을 낸다는 말은 다른 수준의 주장이다.
초당 토큰 수와 실제로 기다린 시간
engine 0.1.26 벤치마크는 RTX 5070 12GB(PCIe 5.0 x16), Ryzen 5 7600, DDR5-5200 64GB, Windows 10에서 실행됐다. setup 기본 설정에 MTP와 greedy를 쓰고 256토큰을 생성했으며, 이미지는 끄고 각 조건을 한 번씩 돌렸다.
원시 기록에서 Q2_0의 32K 입력은 31,566토큰이었고, 프리필 2,170.85 tok/s, 생성 81.75 tok/s, 첫 토큰까지 16.02초였다. 81.75 tok/s는 답이 나오기 시작한 뒤의 속도이며, 그 전에 기다린 16.02초는 따로 있다.
문서를 읽고 짧게 답하는 서비스는 첫 응답 대기가, 긴 초안을 쓰는 작업은 생성 속도가 큰 비중을 차지한다. 코딩 에이전트는 도구 실행과 재시도까지 포함한 완료 시간이 중요하다.
PP(프리필), TG(생성), TTFT(첫 토큰까지 시간)는 서로 다른 구간을 재는 지표다.
위 기록의 엔진은 0.1.26이다. v0.1.39 릴리스 노트는 README 속도표를 이번 릴리스에서 다시 측정하지 않았다고 밝힌다.
그래서 이 수치는 최신 버전의 보장값이 아니라 잘 기록된 기준점 하나다.
한 요청을 빠르게 하는 일과 여러 요청을 처리하는 일
9월 29일 GitHub 이슈 #127에서 rhgo1749는 GPU마다 독립 Strata 엔진을 두고 요청 하나를 한 GPU 레인에 배정하는 실험 구성을 소개했다. 큰 호스트 전문가 영역은 Linux의 MAP_SHARED로 레인 프로세스들이 공유한다.
RTX 5070 Ti 16GB 3장, IQ3_XXS, 레인별 컨텍스트 262K에서 준비된 상태의 생성 속도는 78.8, 78.4, 80.1 tok/s였다. 합계 237.3 tok/s는 레인 값의 단순 합이며 시간을 맞춘 전체 처리량이 아니라고 작성자가 직접 밝혔다.
별도 포크의 실험 구현이므로 기본 Strata의 성능으로 볼 수는 없다.
개인용 대화에서는 한 요청의 대기가, 여러 에이전트를 돌리는 서비스에서는 동시에 들어온 요청이 밀리지 않는 능력이 중요하다.
합산 처리량은 개별 사용자의 대기를 가리고, 단일 요청 시험은 공유 자원의 경합을 놓친다.
작은 팩과 맞는 모델은 다르다
모델 안내가 제시하는 전문가 크기는 Q2_0 34GB, IQ2_XS 35.5GB, IQ3_XXS 43GB, IQ3_S 50GB, Coder 23GB다. 기본 구성에서는 여기에 Windows와 다른 프로그램용 약 10GB가 더 필요하다.
Coder는 512개 전문가 가운데 코드 데이터로 고른 256개만 남긴 파생 모델이다. 문서는 코드 밖 작업과 영어 이외 언어에서 더 약하다고 밝힌다.
설치 안내의 기본 대상은 Windows 10/11이나 Linux, AVX2가 있는 x86-64 CPU, VRAM 12GB 이상인 NVIDIA RTX 20~50 시리즈나 지원 AMD 카드다. Pascal·Volta 같은 구형 NVIDIA 카드는 v0.1.39에서 실험적 경로로 추가됐다.
디스크는 모델에 약 70~80GB, MTP 층에 약 6GB가 필요하고, AVX-512 CPU에서 Q2_0을 쓰면 약 40GB 복사본을 한 번 더 만든다.
Strata 엔진은 MIT 라이선스지만, 공식 Qwen 모델 카드는 Qwen Community License 1.0을 표시한다. 모델 파일에는 각자의 라이선스가 적용된다.
내 작업에 맞는 메모리 배치
Strata를 비교해 볼 만한 환경은 지원 모델의 품질이 필요하고, VRAM은 부족하지만 RAM과 CPU에 여유가 있는 경우다. 첫 질문은 가장 큰 팩이 돌아가는지가 아니라 필요한 팩의 가중치가 응답 중 어디에 남는가다.
처음 실행과 준비된 상태를 나누고 입력 길이, 동시 요청 수, 엔진·모델 버전, 하드웨어 조건을 함께 기록하면 결과가 바뀐 이유를 추적할 수 있다.
Strata의 속도는 실행한 모델의 크기보다 가중치가 어느 계층에 남고 어디서 계산되는지에 달려 있다.