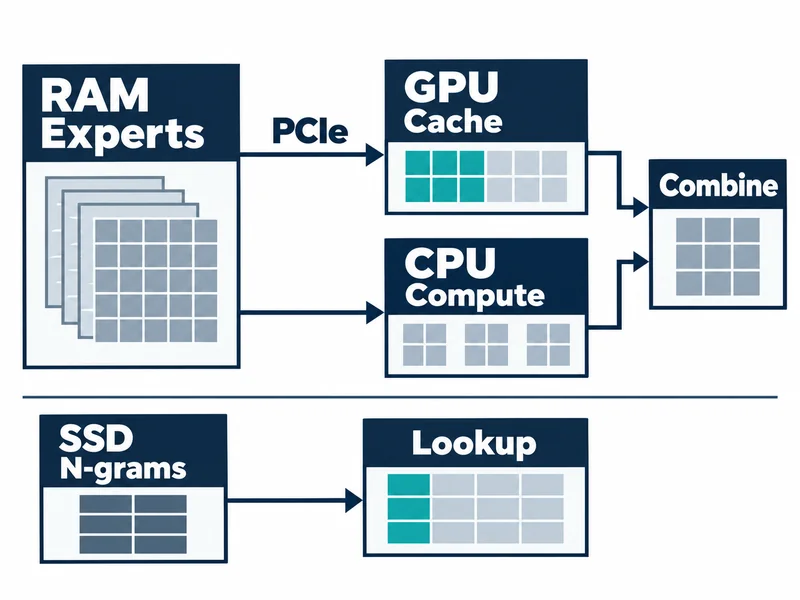
Strataは、GPUメモリより大きなモデルをGPU、RAM、CPU、SSDに分けて動かす推論エンジンだ。既定の構成では24,576個のエキスパートすべてをRAMに置き、最もよく使うものをGPUメモリにキャッシュする。
この記事は、10月4日に出たv0.1.39と固定コミットの文書をもとにこの配置を見ていく。性能の数値はプロジェクトと公開テスターの報告で、devotdがハードウェアで再現した結果ではない。
大きなモデルのすべてが常に忙しいわけではない
Strataが対象とするQwen3.8-Flash-Nextは混合エキスパート(MoE)モデルで、ルーターが入力ごとに必要なエキスパートを選ぶ。公式モデルカードは125Bパラメーターのうち6Bがアクティブになり、それとは別に51Bのn-gram埋め込みと4BのMTPパラメーターがあると記している。
今使われていないエキスパートも、次のトークンや別の層では選ばれうる。そのため重み全体は手の届く場所に置きつつ、今必要な一部を素早く使う仕組みが要る。
近くに置く重みを選ぶこと
よく選ばれるエキスパートは、速いメモリに置いておく価値が大きい。まれなエキスパートまですべてGPUに置けばVRAMの必要量が増え、すべて遠くに置けばデータ移動が計算量の小ささという利点を食いつぶす。
Strataのモデル案内は、Qwen3.8-Flash-Nextとその量子化・派生モデルだけを扱う。ファイル形式が同じというだけで、他のモデルでも同じ配置の効果が出ると考える根拠はない。
メモリ階層ごとに受け持つデータ
VRAMには、アテンションとDeltaNetのミキサー、ルーター、共有エキスパート、出力ヘッド、MTPのドラフト層、KVキャッシュが入る。64K以降はKVキャッシュのうちよく読む部分だけをVRAMに置き、残りはRAMからストリーミングする。
残りのVRAMは最もよく使うエキスパートを入れるエキスパートキャッシュが埋め、このキャッシュは会話に合わせて入れ替わる。そのためGPUメモリ全体がそのままエキスパートキャッシュの容量になるわけではない。
RAMには24,576個のエキスパートすべてが固定(pinned)されている。SSDには28.8GBのn-gramテーブルがあり、トークンごとに数行だけをOSキャッシュを通さずに読む。
容量、帯域幅、レイテンシー
配置を評価するときは、容量(どれだけ入るか)、帯域幅(一定時間にどれだけ運べるか)、レイテンシー(要求してからどれだけ待つか)を分けて見られる。
VRAMにエキスパートを多く置けば移動は減るが、KVキャッシュや計算バッファーも同じVRAMを使う。コンテキストを伸ばす選択は、エキスパートを置ける場所を変える。
保存場所と計算場所は違う
RAMにある重みだからといって、必ずCPUが計算するわけではない。GPUキャッシュにあるエキスパートはGPUが処理し、GPUにないエキスパートはCPUがRAM上でその場で計算する。
CPUの計算は、GPUがキャッシュ済みのエキスパートを処理しているあいだに並行して進む。文書は、VRAMにないエキスパートのうちCPUで計算せずGPUにコピーする割合も別に扱っている。
一緒に終わらなければならない作業
CPUの分担が遅れて終われば、GPUがいくら速くても1つの段階が完了しない。データ移動が主な待ちなら、演算能力だけを上げても効果は小さいことがある。
適応型キャッシュは、使われ方に応じてGPUに置くエキスパートを入れ替える。モデルが選んだエキスパートを変えるのではなく、同じ計算をどこで行うかを調整するものだ。
SSDのn-gramテーブルは小さな断片を読む
モデルカードは、n-gram埋め込みを短いn-gramで索引する構成要素と説明し、メモリの限られたアクセラレーターでのオフロードに向くとしている。
StrataのIQ4_NLテーブルは90バイトの行が320,001,536行(26.8GiB)ある。1トークンに異なる16ページ上の16行が必要で、各行はバッファーなしの4KiB読み出しで取得する。
すでに取得した行は、容量に上限のある行キャッシュに残す。こうした参照では、SSDの順次読み出し速度より、小さな読み出しが間に合うかどうかのほうが重要になる。
低RAMモードの2つの変種
既定の構成ではエキスパート全体(23〜50GB)をRAMにコピーするが、RAMが足りないとsetupはモデルフォルダーのファイルをマップする低RAMモードを選ぶ。文書は、GPUが小さいとほとんどのエキスパートをSSDから読むことになり、大幅に遅くなると明記している。
エンジン0.1.30のresident変種は、GPUにないエキスパートがRAMに収まる場合に使われ、RAMのコピーがGPUの持たないエキスパートだけを保つようにする。同じ低RAMモードでも、必要な重みがどの階層に残るかで速度が変わる。
SSDからエキスパートを供給するときの規模
実験的なUD-Q4_K_XLの文書は、Windows 10、RTX 5070 12GB、RAM 64GB、AVX-512 CPUを備えたPC 1台で検証された。RAM予算40GiBで同じ短いgreedyプロンプトを6回実行し、6.7〜8.6 tok/s、平均7.9 tok/sだった。
このとき検証ラウンドごとにSSDから1.1GB、トークンあたり約0.33GBを読んでいた。特定のPC 1台で開発者が測った値だ。
トークンあたり0.33GBに8 tok/sを掛けると、毎秒約2.64GBのエキスパート読み出しになる。文書の数値を換算した計算で、別に測ったSSDのスループットではない。
SSDで容量の制約は和らげられても、そのぶんのデータ移動のコストは残る。
プロンプトを読むときと答えを書くとき
プリフィルは長い入力をトークンのまとまり(チャンク)で処理し、一度用意したエキスパートの重みで多くのトークンを計算する。Strataのプリフィル経路は、GPUにないエキスパートを固定順でリングバッファーに流してGPUへ送る。
ソースのコメントには、8,192トークンのチャンクでリングを96スロットから384スロットに増やすと1,153から1,294 tok/sになったという測定がある。リングが大きいほどエキスパートキャッシュのスロットを占めるため、チャンクの大きさとキャッシュ領域のあいだで釣り合いが要る。
デコードは生成済みのトークンをもとに次のトークンを決めるため、プリフィルのように多くの作業を一度にまとめにくい。
そのため、長い文書を読んで短く答える作業と、短い質問に長く答える作業では、有利な構成が違いうる。
ドラフトトークンで生成速度を上げるMTP
StrataはモデルのMTP層で最大3トークンのドラフトを作り、48層を1回通して検証する。文書によると、1回あたり平均2.4〜3.2トークンが得られる。
どれだけ採用されるかは生成する内容によって変わる。同じPCでも毎秒トークン数がプロンプトや回答の種類で変わる理由の1つだ。
注意点:同じモデルが同じトークンを意味するわけではない
文書は、temperature 0でも、ドラフト、キャッシュの状態、続きの会話が違えば、同じプロンプトが別の(同じくらい妥当な)答えで終わりうると説明している。バイト単位で同じ繰り返しには別のオプションが必要だ。
同じモデルを動かすという主張と、すべての設定で同じトークンを出すという主張は、強さの違う主張だ。
毎秒トークン数と実際に待った時間
engine 0.1.26のベンチマークは、RTX 5070 12GB(PCIe 5.0 x16)、Ryzen 5 7600、DDR5-5200 64GB、Windows 10で実行された。setupの既定設定にMTPとgreedyを使って256トークンを生成し、画像はオフにして各条件を1回ずつ実行した。
生の記録では、Q2_0の32K入力は31,566トークンで、プリフィル2,170.85 tok/s、生成81.75 tok/s、最初のトークンまで16.02秒だった。81.75 tok/sは答えが出始めてからの速度で、その前に待った16.02秒は別にある。
文書を読んで短く答えるサービスでは最初の応答までの待ちが、長い下書きを書く作業では生成速度が大きな比重を占める。コーディングエージェントでは、ツールの実行や再試行を含めた完了時間が重要になる。
PP(プリフィル)、TG(生成)、TTFT(最初のトークンまでの時間)は、別々の区間を測る指標だ。
上の記録のエンジンは0.1.26だ。v0.1.39のリリースノートは、READMEの速度表を今回のリリースで測り直していないと明記している。
そのため、これらの数値は最新版の保証値ではなく、よく記録された基準点の1つだ。
1つのリクエストを速くすることと、多くのリクエストをさばくこと
9月29日、rhgo1749はGitHubのissue #127で、GPUごとに独立したStrataエンジンを置き、1つのリクエストを1本のGPUレーンに割り当てる実験構成を紹介した。大きなホストのエキスパート領域は、LinuxのMAP_SHAREDでレーンのプロセス間で共有する。
RTX 5070 Ti 16GB 3枚、IQ3_XXS、レーンごとのコンテキスト262Kで、準備済み状態の生成速度は78.8、78.4、80.1 tok/sだった。合計237.3 tok/sはレーンの値の単純な和で、時間をそろえた全体スループットではないと作者自身が明記している。
別フォークの実験的な実装なので、標準のStrataの性能とは見なせない。
個人の対話では1つのリクエストの待ちが、複数のエージェントを動かすサービスでは同時に来たリクエストを滞らせない力が重要になる。
合計スループットは個々の利用者の待ちを覆い隠し、単一リクエストのテストは共有資源での競合を見落とす。
小さいパックと合ったモデルは別物
モデル案内が示すエキスパートのサイズは、Q2_0が34GB、IQ2_XSが35.5GB、IQ3_XXSが43GB、IQ3_Sが50GB、Coderが23GBだ。既定の構成では、これにWindowsや他のプログラム用の約10GBが加わる。
Coderは、512個のエキスパートのうちコードデータで選んだ256個だけを残した派生モデルだ。案内は、コード以外の作業や英語以外の言語では弱くなると明記している。
インストール案内の主な対象は、Windows 10/11またはLinux、AVX2を備えたx86-64 CPU、VRAM 12GB以上のNVIDIA RTX 20〜50シリーズか対応AMDカードだ。PascalやVoltaなど古いNVIDIAカードは、v0.1.39で実験的な経路として加わった。
ディスクはモデルに約70〜80GB、MTP層に約6GBが必要で、AVX-512 CPUでQ2_0を使うと約40GBのコピーをもう1つ一度だけ書き出す。
StrataのエンジンはMITライセンスだが、公式のQwenモデルカードはQwen Community License 1.0を表示している。モデルファイルにはそれぞれのライセンスが適用される。
自分の作業に合うメモリ配置
Strataを比べてみる価値があるのは、対応モデルの品質が必要で、VRAMは足りないがRAMとCPUに余裕がある環境だ。最初の問いは最大のパックが動くかではなく、必要なパックの重みが応答中にどこに残るかだ。
初回の実行と準備済みの状態を分け、入力長、同時リクエスト数、エンジンとモデルのバージョン、ハードウェアの条件を一緒に記録すれば、結果が変わった理由をたどれる。
Strataの速度は、動かすモデルの大きさよりも、重みがどの階層に残りどこで計算されるかで決まる。