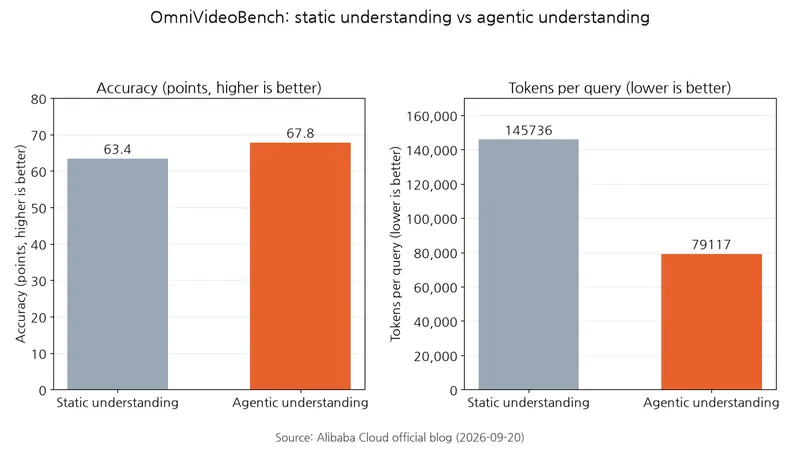
阿里云发布了可同时处理多种感官信息的全模态模型 Qwen3.8-Omni-Flash。根据阿里云的测量,对同一组 OmniVideoBench 问题进行静态解析与智能体模式比较时,智能体模式在每轮保留上下文,即此前的对话和任务信息,将准确率从 63.4 提升至 67.8,并将每次查询的 token 消耗从 145,736 降至 79,117。处理方式从输入整段视频转向选择片段,为连接多个处理步骤的视频摘要流水线增添了一种选择。
测量方法
阿里云在音视频推理基准测试,即衡量性能的标准测试 OmniVideoBench 和 Video-MME-v2,以及长视频推理基准测试 LVOmniBench 上,对比了 Qwen3.8-Omni-Flash 与 Gemini 3.8 Flash。
Static 是模型直接解析输入的模式,智能体模式则由协调执行的工具框架 Qwen Code harness 驱动,围绕问题制定计划并调用工具。Gemini 3.8 Flash 也采用相同的两种设置。价格依据 Model Studio 新加坡地域的公开价目表。每小时费用由 2 分钟片段的输入成本乘以 30 换算,视频按 720p、每秒 1 帧计算,帧指构成视频的单张图像。
表:三项基准测试的静态解析与智能体模式准确率
条件:三项基准测试均采用静态解析和 Qwen Code 智能体模式,Gemini 3.8 Flash 使用相同条件,依据阿里云公布的数据
单位:分
| 基准测试(推理类型) | Qwen3.8 静态 | Qwen3.8 智能体 | Gemini 3.8 静态 | Gemini 3.8 智能体 |
|---|---|---|---|---|
| OmniVideoBench(音视频) | 63.4 | 67.8 | 65.2 | 70.1 |
| Video-MME-v2(音视频) | 65.0 | 71.3 | 71.0 | 72.7 |
| LVOmniBench(长视频) | 63.3 | 73.6 | 70.7 | 70.7 |
结果
根据阿里云的设计说明,在长视频中,智能体模式会自主选择观看和聆听的片段,将预算用于相关部分;以下为公开的基准测试结果。
表:OmniVideoBench 静态解析与智能体理解对比
条件:OmniVideoBench,Qwen3.8-Omni-Flash 静态解析与智能体模式对比,智能体模式每轮保留上下文,依据阿里云公布的数据
| 项目 | 静态解析 | 智能体理解 | 差值 |
|---|---|---|---|
| 准确率(↑) | 63.4 | 67.8 | +4.4 |
| 每次查询的 token(↓) | 145,736 | 79,117 | −45.7% |
Qwen3.8-Omni-Flash 在三项基准测试中均通过智能体模式提高了准确率。差距因基准测试而异:Video-MME-v2 中两款模型几乎持平,LVOmniBench 中则只有 Qwen3.8-Omni-Flash 明显提升。在 OmniVideoBench 中,准确率提高了 4.4 分,每次查询的 token 消耗减少约 45.7%。
为何存在这种差异
阿里云从智能体设计角度解释了这一差异。智能体从问题出发,自主决定观看和聆听的片段,并从较大范围逐步缩小至细节片段来收集证据。其解释是,无需处理全部帧,也能将 token 预算用于相关片段。
支撑长内容处理的是上下文。根据文档,上下文长度为 1M token,可在一次请求中输入文本、图像、音频和视频,音频输入按每秒 7 token 换算计费。
阿里云还公开了改进更小模型的实验。智能体接到在 12 小时内改进 Qwen2.5-Omni-3B 四川话语音识别的任务后,自行确定了用于检验性能的评估集,并在四轮实验中生成了 3,413 条用于训练模型的样本。在 WenetSpeech-Chuan 的同一评估集上,按识别字符统计的错误比例,即字符错误率 CER,从 25.79% 降至 15.30%。
据阿里云公布的数据,29 项评估的平均得分较 Qwen3.5-Omni-Plus 提高了 25% 以上。同一对比中,WildClawBench-MM 使用 Claude Code harness 提高了 36.5 分,AgenticVBench 提高了 22.3 分,LongAudioSpan 提高了 8.3 分,OmniCap-IF 指令遵循度提高了 14.1 分。UniClawBench 使用 OpenClaw harness 取得 69.6。AliMeeting 说话人分离错误率 DER,即说话人区分结果的错误比例,从 88.11 降至 3.35。
表:Model Studio 新加坡地域 API 价格对比
条件:Model Studio 新加坡地域公开价目表,Qwen3.8-Omni-Flash 不区分模态,即输入信息的传递形式,采用统一费率
单位:USD / 100万 token
| 费用 | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus |
|---|---|---|
| 输入文本、图像、视频 | 0.15 | 1.4 |
| 输入音频 | 0.15 | 11 |
| 输出文本 | 0.47 | 8.3 |
据阿里云公布的数据,每 1 小时音频输入的价格降低了 98% 以上,每 1 小时音视频输入的价格降低了 93% 以上。
选择标准
长视频摘要和会议分析可选 qwen3.8-omni-flash。它接受 113 种语言及方言的音频输入,仅输出文本。需要语音输出则选 qwen3.5-omni-plus,可输出 29 种语言、7 种方言的语音。实时音视频对话可选 qwen3.8-omni-flash-realtime 和 Qwen-Live-Harness。v1.0.0 于 2026 年 9 月 21 日发布,桌面应用需要 macOS 12 及以上版本和 Node.js 22.13 及以上版本。根据阿里云的测量,输入 20 秒音视频时,文本输出为每秒 83.00 token,首个文本 token 延迟为 981.01 毫秒,首个音频包延迟为 1350.49 毫秒。音频生成实时因子 RTF,即生成时间与播放时间之比,为 0.1528。将本地教程视频转换为带插图的 PDF 笔记,可用 Qwen-MM-Plugins 的 omni-video2note;将演示视频转为可复用的 Agent Skill,可用 omni-skill-creator。安装脚本支持 Claude Code、Codex、Qwen Code、Gemini CLI 等。视频制作可用 omni-chatcut,长视频视听记忆构建可用 omni-memory。
如果正在运行长视频摘要流水线,请在更换模型之前,先将同一组问题分别交给静态解析和 Qwen Code 智能体模式运行。