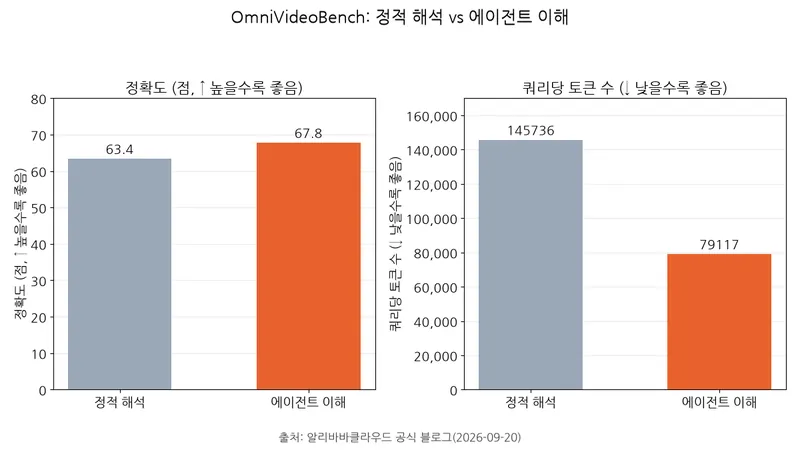
알리바바클라우드가 옴니모달, 여러 감각 정보를 함께 다루는 모델 Qwen3.8-Omni-Flash를 공개했습니다. 알리바바클라우드 측정 기준으로 같은 OmniVideoBench 문제를 정적 해석과 에이전트 모드로 비교하면, 에이전트 모드는 턴마다 컨텍스트, 앞선 대화와 작업 정보를 유지한 채 정확도를 63.4에서 67.8로 높이고 쿼리당 토큰 소비를 145,736에서 79,117로 줄입니다. 영상을 통째로 넣지 않고 볼 구간을 골라 처리하는 쪽으로 방향이 틀어져 영상 요약 파이프라인, 여러 처리 단계를 잇는 흐름에 선택지가 하나 늘었습니다.
측정 방법
알리바바클라우드는 Qwen3.8-Omni-Flash와 Gemini 3.8 Flash를 오디오·비디오 추론 벤치마크, 성능을 재는 표준 시험 OmniVideoBench와 Video-MME-v2, 장편 영상 추론 벤치마크 LVOmniBench에서 비교했습니다.
Static은 모델이 입력을 직접 해석하는 모드이고, 에이전트 모드는 Qwen Code 하네스, 실행을 조율하는 도구 틀이 질문을 계획하고 도구를 호출하도록 돌립니다. Gemini 3.8 Flash에도 같은 두 설정을 적용했습니다. 가격은 Model Studio 싱가포르 리전 공개 가격표 기준입니다. 시간당 요금은 2분 분량 클립의 입력 비용을 30배 해 환산하고 영상은 720p·초당 1프레임, 영상의 한 장을 이루는 이미지로 계산했습니다.
표: 세 벤치마크의 정적 해석과 에이전트 모드 정확도
조건: 세 벤치마크 모두 정적 해석과 Qwen Code 에이전트 모드, Gemini 3.8 Flash는 동일 조건, 알리바바클라우드 발표 기준
단위: 점
| 벤치마크 (추론 유형) | Qwen3.8 정적 | Qwen3.8 에이전트 | Gemini 3.8 정적 | Gemini 3.8 에이전트 |
|---|---|---|---|---|
| OmniVideoBench (오디오·비디오) | 63.4 | 67.8 | 65.2 | 70.1 |
| Video-MME-v2 (오디오·비디오) | 65.0 | 71.3 | 71.0 | 72.7 |
| LVOmniBench (장편 영상) | 63.3 | 73.6 | 70.7 | 70.7 |
결과
알리바바클라우드의 설계 설명상 긴 영상에서는 에이전트 모드가 볼·들을 구간을 스스로 골라 관련 구간에 예산을 쓰고, 아래 수치는 공개된 벤치마크 결과입니다.
표: OmniVideoBench 정적 해석과 에이전트 이해 비교
조건: OmniVideoBench, Qwen3.8-Omni-Flash 정적 해석 대 에이전트 모드, 에이전트 모드는 턴마다 컨텍스트 유지, 알리바바클라우드 발표 기준
| 항목 | 정적 해석 | 에이전트 이해 | 차이 |
|---|---|---|---|
| 정확도 (↑) | 63.4 | 67.8 | +4.4 |
| 쿼리당 토큰 (↓) | 145,736 | 79,117 | −45.7% |
Qwen3.8-Omni-Flash는 세 벤치마크 모두 에이전트 모드에서 정확도가 올라갔습니다. 격차는 벤치마크마다 달라 Video-MME-v2에서는 두 모델이 거의 맞붙고, LVOmniBench에서는 Qwen3.8-Omni-Flash만 눈에 띄게 올랐습니다. OmniVideoBench에서는 정확도가 4.4점 오르고 쿼리당 토큰 소비는 약 45.7% 줄었습니다.
왜 이런 차이가 나나
알리바바클라우드는 이 차이를 에이전트 설계에서 설명합니다. 에이전트는 질문에서 출발해 볼·들을 구간을 스스로 정하고, 넓은 구간에서 세부 구간으로 좁혀 가며 증거를 모읍니다. 프레임을 전부 처리하지 않아도 토큰 예산을 관련 구간에 쓸 수 있다는 설명입니다.
길이를 받쳐 주는 것은 컨텍스트입니다. 문서 기준으로 컨텍스트 길이는 1M 토큰이고 텍스트·이미지·오디오·비디오를 한 요청에 넣을 수 있으며, 오디오 입력은 초당 7토큰으로 환산해 과금됩니다.
알리바바클라우드는 더 작은 모델을 고치는 실험도 공개했습니다. 12시간 동안 Qwen2.5-Omni-3B의 사천어 음성 인식을 개선하라는 과제를 받은 에이전트가 평가 세트, 성능을 확인하는 문제 묶음을 스스로 정하고, 네 차례 실험에서 3,413개의 학습 샘플, 모델을 학습시키는 예시 자료를 만들어 WenetSpeech-Chuan의 동일 평가 세트에서 측정한 문자 오류율 CER, 인식 글자의 단위별 오답 비율을 25.79%에서 15.30%로 낮췄습니다.
알리바바클라우드 발표 기준으로 29개 평가의 평균 점수는 Qwen3.5-Omni-Plus 대비 25% 이상 올랐습니다. 같은 비교에서 WildClawBench-MM은 Claude Code 하네스로 36.5점, AgenticVBench는 22.3점, LongAudioSpan은 8.3점, OmniCap-IF 명령 충족도는 14.1점 올랐고, UniClawBench는 OpenClaw 하네스로 69.6을 기록했습니다. AliMeeting 발화자 분리 오류율 DER, 화자를 구분한 결과의 오류 비율은 88.11에서 3.35로 내려갔습니다.
표: Model Studio 싱가포르 리전 API 가격 비교
조건: Model Studio 싱가포르 리전 공개 가격표, Qwen3.8-Omni-Flash는 모달리티, 입력 정보가 전달되는 형식 구분 없이 단일 요금
단위: USD / 100만 토큰
| 요금 | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus |
|---|---|---|
| 입력 텍스트·이미지·비디오 | 0.15 | 1.4 |
| 입력 오디오 | 0.15 | 11 |
| 출력 텍스트 | 0.47 | 8.3 |
알리바바클라우드 발표 기준으로 오디오 입력 1시간당 가격은 98% 이상, 오디오·비디오 입력 1시간당 가격은 93% 이상 낮습니다.
고를 때 기준
장시간 영상 요약과 회의 분석에는 qwen3.8-omni-flash. 입력 오디오 113개 언어·방언을 받고 텍스트만 출력합니다. 음성 출력이 필요하면 qwen3.5-omni-plus. 29개 언어·7개 방언으로 음성을 출력합니다. 실시간 음성·영상 대화는 qwen3.8-omni-flash-realtime과 Qwen-Live-Harness. 2026년 9월 21일 v1.0.0이 공개됐고 데스크톱 앱은 macOS 12 이상과 Node.js 22.13 이상이 필요합니다. 알리바바클라우드 측정 기준으로 오디오·비디오 20초 입력에서 텍스트 출력은 초당 83.00토큰, 첫 텍스트 토큰은 981.01밀리초, 첫 오디오 패킷은 1350.49밀리초, 오디오 생성 실시간 배율 RTF, 생성 시간과 재생 시간의 비율은 0.1528입니다. 로컬 튜토리얼 영상을 그림 포함 PDF 노트로 바꾸려면 Qwen-MM-Plugins의 omni-video2note, 시연 영상을 재사용 가능한 Agent Skill로 만들려면 omni-skill-creator. 설치 스크립트는 Claude Code, Codex, Qwen Code, Gemini CLI 등을 지원합니다. 영상 제작은 omni-chatcut, 장시간 영상의 시청각 기억 구축은 omni-memory.
긴 영상 요약 파이프라인을 돌리고 있다면 모델을 바꾸기 전에 같은 질문 세트를 정적 해석과 Qwen Code 에이전트 모드로 각각 돌려 보세요.