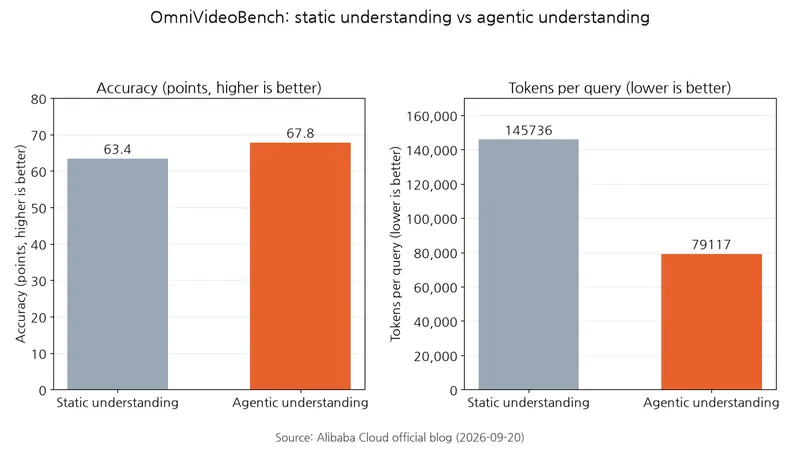
アリババクラウドが、複数の感覚情報をまとめて扱うオムニモーダルモデルQwen3.8-Omni-Flashを公開しました。同社の測定では、同じOmniVideoBenchの問題で静的解析とエージェントモードを比較すると、後者は各ターンで過去の会話や作業情報であるコンテキストを保持し、正確度を63.4から67.8へ高め、クエリ当たりのトークン消費を145,736から79,117へ減らします。動画全体を入力せず、見る区間を選んで処理する方向に転じ、複数の処理段階をつなぐ動画要約パイプラインの選択肢が増えました。
測定方法
アリババクラウドはQwen3.8-Omni-FlashとGemini 3.8 Flashを、音声・動画推論の性能を測る標準試験OmniVideoBenchとVideo-MME-v2、長時間動画推論ベンチマークLVOmniBenchで比較しました。
Staticはモデルが入力を直接解釈するモードで、エージェントモードは実行を調整するツール基盤Qwen Codeハーネスを使い、質問に対する計画とツール呼び出しを行います。Gemini 3.8 Flashにも同じ2つの設定を適用しました。価格はModel Studioシンガポールリージョンの公開料金表に基づきます。時間当たりの料金は2分のクリップの入力費用を30倍して換算し、動画は720p・毎秒1フレーム、つまり動画を構成する画像1枚として計算しました。
表:3つのベンチマークにおける静的解析とエージェントモードの正確度
条件:3つのベンチマークすべてで静的解析とQwen Codeエージェントモードを使用、Gemini 3.8 Flashも同条件、アリババクラウドの発表に基づく
単位:点
| ベンチマーク(推論の種類) | Qwen3.8 静的 | Qwen3.8 エージェント | Gemini 3.8 静的 | Gemini 3.8 エージェント |
|---|---|---|---|---|
| OmniVideoBench(音声・動画) | 63.4 | 67.8 | 65.2 | 70.1 |
| Video-MME-v2(音声・動画) | 65.0 | 71.3 | 71.0 | 72.7 |
| LVOmniBench(長時間動画) | 63.3 | 73.6 | 70.7 | 70.7 |
結果
アリババクラウドの設計説明によると、長時間動画ではエージェントモードが見る・聞く区間を自ら選び、関連区間に処理予算を割り当てます。以下は公開されたベンチマーク結果です。
表:OmniVideoBenchの静的解析とエージェント理解の比較
条件:OmniVideoBench、Qwen3.8-Omni-Flashの静的解析とエージェントモードの比較、エージェントモードは各ターンでコンテキストを保持、アリババクラウドの発表に基づく
| 項目 | 静的解析 | エージェント理解 | 差 |
|---|---|---|---|
| 正確度(↑) | 63.4 | 67.8 | +4.4 |
| クエリ当たりのトークン(↓) | 145,736 | 79,117 | −45.7% |
Qwen3.8-Omni-Flashは、3つのベンチマークすべてでエージェントモードの正確度が向上しました。差はベンチマークごとに異なり、Video-MME-v2では両モデルがほぼ拮抗し、LVOmniBenchではQwen3.8-Omni-Flashだけが目立って向上しました。OmniVideoBenchでは正確度が4.4点上がり、クエリ当たりのトークン消費は約45.7%減少しました。
なぜ差が生まれるのか
アリババクラウドは、この差をエージェント設計から説明しています。エージェントは質問を起点に、見る・聞く区間を自ら決め、広い区間から細かな区間へと絞りながら根拠を集めます。全フレームを処理せずとも、関連区間にトークン予算を使えるという説明です。
長さを支えるのはコンテキストです。文書によるとコンテキスト長は1Mトークンで、テキスト・画像・音声・動画を1つのリクエストに入力でき、音声入力は毎秒7トークンに換算して課金されます。
アリババクラウドは、より小さなモデルを改善する実験も公開しました。12時間でQwen2.5-Omni-3Bの四川語音声認識を改善する課題を与えられたエージェントは、性能確認用の問題群である評価セットを自ら決めました。4回の実験でモデルの学習用の例となる3,413件の学習サンプルを作り、WenetSpeech-Chuanの同一評価セットで測定した、認識文字単位の誤り率である文字誤り率CERを25.79%から15.30%へ下げました。
アリババクラウドの発表では、29の評価の平均スコアはQwen3.5-Omni-Plus比で25%以上向上しました。同じ比較でWildClawBench-MMはClaude Codeハーネスで36.5点、AgenticVBenchは22.3点、LongAudioSpanは8.3点、OmniCap-IFの指示充足度は14.1点向上し、UniClawBenchはOpenClawハーネスで69.6を記録しました。AliMeetingの話者を区別した結果の誤り率である話者分離誤り率DERは88.11から3.35へ下がりました。
表:Model StudioシンガポールリージョンのAPI料金比較
条件:Model Studioシンガポールリージョンの公開料金表、Qwen3.8-Omni-Flashは入力情報の形式であるモダリティを問わず単一料金
単位:USD / 100万トークン
| 料金 | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus |
|---|---|---|
| 入力テキスト・画像・動画 | 0.15 | 1.4 |
| 入力音声 | 0.15 | 11 |
| 出力テキスト | 0.47 | 8.3 |
アリババクラウドの発表では、音声入力1時間当たりの料金は98%以上、音声・動画入力1時間当たりの料金は93%以上低くなっています。
選ぶ際の基準
長時間動画の要約や会議分析にはqwen3.8-omni-flash。113の言語・方言の音声入力に対応し、出力はテキストのみです。音声出力が必要ならqwen3.5-omni-plus。29言語・7方言で音声を出力します。リアルタイムの音声・動画会話にはqwen3.8-omni-flash-realtimeとQwen-Live-Harness。2026年9月21日にv1.0.0が公開され、デスクトップアプリにはmacOS 12以上とNode.js 22.13以上が必要です。アリババクラウドの測定では、音声・動画20秒の入力でテキスト出力は毎秒83.00トークン、最初のテキストトークンは981.01ミリ秒、最初の音声パケットは1350.49ミリ秒、生成時間と再生時間の比率である音声生成のリアルタイム係数RTFは0.1528です。ローカルのチュートリアル動画を図入りPDFノートに変えるならQwen-MM-Pluginsのomni-video2note、実演動画を再利用可能なAgent Skillにするならomni-skill-creator。インストールスクリプトはClaude Code、Codex、Qwen Code、Gemini CLIなどに対応します。動画制作にはomni-chatcut、長時間動画の視聴覚記憶の構築にはomni-memory。
長時間動画の要約パイプラインを運用しているなら、モデルを変える前に、同じ質問セットを静的解析とQwen Codeエージェントモードでそれぞれ実行してみてください。