NVIDIA公布了无需重新训练即可加速PET的结果,该神经网络模型用于预测原子的能量和力。NVIDIA的评估显示,不仅矩阵运算加快,更新原子位置和速度的分子动力学完整单步也更快,展现了用现有模型缩短模拟时间的可能性。
在这类计算中,微小的力误差可能逐步累积,扰乱原子运动。因此,即使使用专门处理矩阵运算的GPU计算单元——张量核心,也必须兼顾速度与数值稳定性(原文)。
测量方法
NVIDIA使用参数量为2,600万的PET-MAD,评估了192原子的水盒及其扩展后的17,280原子结构。BF16x9在Blackwell B300上测量,TF32x3在A100上测量。矩阵乘法以各GPU的原生FP32执行为基准,BF16x9分子动力学单步则以编译后的FP32为基准(测量方法)。
结果
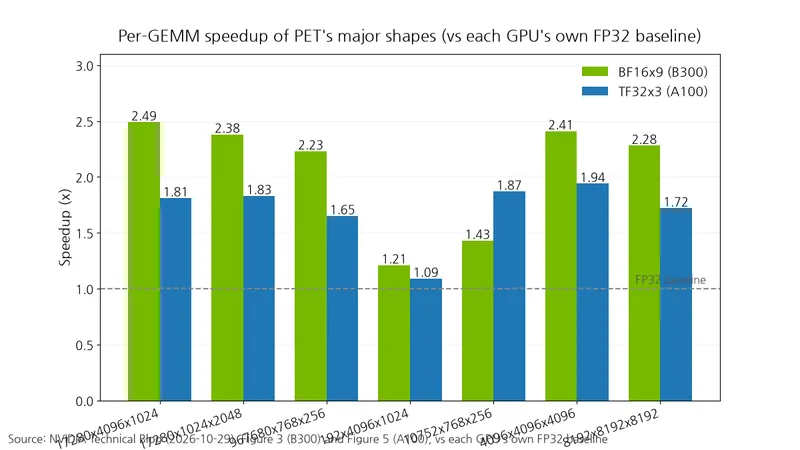
矩阵乘法(GEMM)的加速比需要按设备分别看待。
表:B300的BF16x9 GEMM加速比
条件:PET-MAD 26M,相对于Blackwell B300的native FP32,数值取自NVIDIA Figure 3的柱状图
单位:倍
| GEMM形状 MxNxK | BF16x9 B300 |
|---|---|
| 17280x4096x1024 | 2.49 |
| 17280x1024x2048 | 2.38 |
| 967680x768x256 | 2.23 |
| 192x4096x1024 | 1.21 |
| 10752x768x256 | 1.43 |
| 4096x4096x4096 | 2.41 |
| 8192x8192x8192 | 2.28 |
表:A100的TF32x3 GEMM加速比
条件:PET-MAD 26M,相对于A100的native FP32,数值取自NVIDIA Figure 5的柱状图
单位:倍
| GEMM形状 MxNxK | TF32x3 A100 |
|---|---|
| 17280x4096x1024 | 1.81 |
| 17280x1024x2048 | 1.83 |
| 967680x768x256 | 1.65 |
| 192x4096x1024 | 1.09 |
| 10752x768x256 | 1.87 |
| 4096x4096x4096 | 1.94 |
| 8192x8192x8192 | 1.72 |
NVIDIA的测量显示,B300上的BF16x9在大矩阵中加速尤为明显(Figure 3),A100上的TF32x3在所有展示的形状中也均快于该设备的FP32(Figure 5)。由于设备不同,这并不代表两种方法的优劣。
BF16x9的performant策略仅在cuBLAS预计更快时使用。NVIDIA测得,相对于编译后的FP32,完整单步在192原子时的加速比为1.2倍,在17,280原子时为1.7倍。NVIDIA测得的TF32x3加速比在大系统中为1.5倍,基准为该设备的FP32(Figure 4·6及说明)。
在小系统中,GPU任务启动时间和邻近原子处理等非矩阵任务占比较大,收益会降低。TF32x3需要针对矩阵形状和GPU调优内核,并根据模型精度和物理稳定性要求进行验证(局限与选择标准)。
NVIDIA的精度评估显示,BF16x9产生的误差小于同一模型运行时自身产生的波动。在NVIDIA的测量中,TF32x3的力误差约为重新编译并运行FP32所产生差异的3倍(精度分析)。
将539原子合金表面的位置调整至稳定构型的结构弛豫使用了PET、FIRE2和NVIDIA ALCHEMI Toolkit。在NVIDIA的3次重复评估中,FP32在218步、TF32x3在218~222步达到1.0×10⁻³ eV/Å的力容差。NVIDIA测得,仅做一次TF32转换的路径每步更快,但到1,000步仍未收敛(Figure 8及说明)。
在NVIDIA将一氧化碳分子从铂表面分离的测试中,TF32x3也遵循了FP32平滑的能量曲线。NVIDIA另行评估了粒子数、体积和能量固定的192原子水体系的30 ps模拟,结果显示其能量波动与FP32相近。在NVIDIA的评估中,单次转换TF32在两项测试中分别出现了曲线波动和能量漂移(Figure 7及说明)。
为何存在这些差异
BF16x9将FP32输入值拆成三个BF16分量,计算九对乘积后以FP32求和(cuBLAS文档)。TF32x3将输入值拆成较大分量和近似后剩余的差值,舍去小差值之间的乘积,仅将三个乘积以FP32累加(算法说明)。
PET通过对预测能量求导来计算力。因此,TF32x3也用于计算传递给神经网络层输入的导数,使能量和力都采用相同的运算路径(实现说明)。
选择标准
BF16x9支持CUDA 12.9及以上版本,以及GPU架构支持编号即计算能力为10.0·10.3的架构。通过CUBLAS_EMULATE_SINGLE_PRECISION=1启用后,兼容的PyTorch矩阵运算即可使用该路径(支持条件)。
A100上的TF32x3需要单独实现。NVIDIA将PET的nn.Linear替换为调用CUTLASS内核的TF32Linear。原文中的核心运算符配置也见于CUTLASS示例27。
cutlass::arch::OpMultiplyAddFastF32PET加速的实际价值不在于矩阵乘法的峰值速度,而在于稳定完成模拟所需的总时间。