NVIDIAが原子のエネルギーと力を予測するニューラルネットワークモデルPETを、再学習なしで高速化した結果を公開した。NVIDIAの評価では行列演算だけでなく、原子の位置と速度を更新する分子動力学の1ステップ全体も高速化し、既存モデルでシミュレーション時間を短縮できる可能性を示した。
この計算では小さな力の誤差がステップごとに蓄積し、原子の動きを乱すことがある。行列演算専用のGPU演算部であるテンソルコアを使う場合も、速度と数値的安定性を両立する必要がある理由だ(原文)。
測定方法
NVIDIAは2,600万パラメータのPET-MADで、192原子の水ボックスと、それを拡張した17,280原子の構造を評価した。BF16x9はBlackwell B300、TF32x3はA100で測定した。行列乗算は各GPUの通常のFP32実行を、BF16x9の分子動力学ステップはコンパイル済みFP32を基準とした(測定方法)。
結果
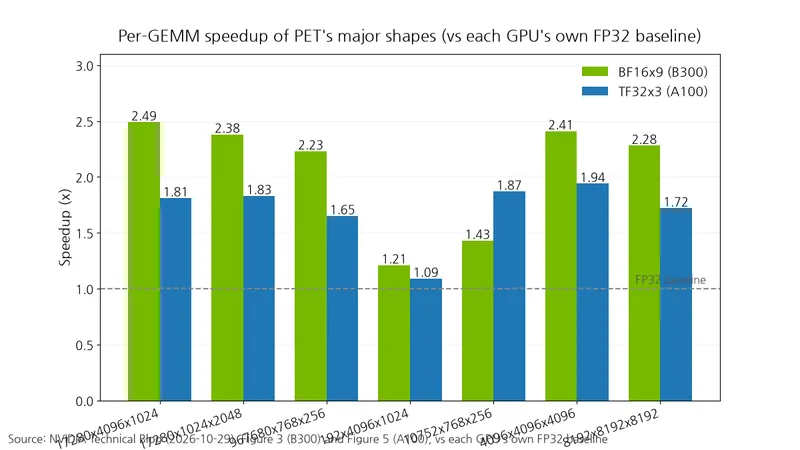
行列乗算(GEMM)の高速化率は、デバイス別に見る必要がある。
表:B300のBF16x9 GEMM高速化率
条件:PET-MAD 26M、Blackwell B300のnative FP32比、NVIDIA Figure 3の棒の値
単位:倍
| GEMM形状 MxNxK | BF16x9 B300 |
|---|---|
| 17280x4096x1024 | 2.49 |
| 17280x1024x2048 | 2.38 |
| 967680x768x256 | 2.23 |
| 192x4096x1024 | 1.21 |
| 10752x768x256 | 1.43 |
| 4096x4096x4096 | 2.41 |
| 8192x8192x8192 | 2.28 |
表:A100のTF32x3 GEMM高速化率
条件:PET-MAD 26M、A100のnative FP32比、NVIDIA Figure 5の棒の値
単位:倍
| GEMM形状 MxNxK | TF32x3 A100 |
|---|---|
| 17280x4096x1024 | 1.81 |
| 17280x1024x2048 | 1.83 |
| 967680x768x256 | 1.65 |
| 192x4096x1024 | 1.09 |
| 10752x768x256 | 1.87 |
| 4096x4096x4096 | 1.94 |
| 8192x8192x8192 | 1.72 |
NVIDIAの測定では、B300で大きな行列のBF16x9高速化が顕著だった(Figure 3)。A100でもTF32x3は提示されたすべての形状で同GPUのFP32より速かった(Figure 5)。デバイスが異なるため、両手法の優劣を意味するものではない。
BF16x9のperformant戦略は、cuBLASがより速いと予測した場合のみ使う。NVIDIAの測定ではステップ全体がコンパイル済みFP32比で192原子では1.2倍、17,280原子では1.7倍高速だった。NVIDIAが測定したTF32x3の高速化率は、大規模システムで同GPUのFP32を基準に1.5倍だった(Figure 4・6と説明)。
小規模システムではGPUの処理開始時間や近傍原子処理など、行列演算以外の処理の割合が大きく、利点が小さくなる。TF32x3には行列形状とGPUに合わせたカーネル調整と、モデルの精度および物理的安定性の要件に応じた検証が必要だ(制約と選択基準)。
NVIDIAの精度評価では、BF16x9が生む誤差は同じモデルを実行しても生じる固有の変動より小さかった。NVIDIAの測定では、TF32x3の力の誤差はFP32を再コンパイルして実行した際の差の約3倍だった(精度分析)。
539原子の合金表面の位置を安定した配置に調整する構造緩和には、PET・FIRE2・NVIDIA ALCHEMI Toolkitを使った。NVIDIAの3回の反復評価で、FP32は218ステップ、TF32x3は218~222ステップで力の許容誤差1.0×10⁻³ eV/Åに到達した。NVIDIAの測定でTF32変換を1回だけ行う経路はステップ当たりでは速かったが、1,000ステップでも収束しなかった(Figure 8と説明)。
NVIDIAが白金表面から一酸化炭素分子を引き離して評価した試験でも、TF32x3はFP32の滑らかなエネルギー曲線に追従した。NVIDIAが別途、粒子数・体積・エネルギーを固定した192原子の水の30 psシミュレーションを評価した結果では、FP32と同程度のエネルギー変動を示した。NVIDIAの評価で単一変換のTF32は、それぞれ曲線の揺れとエネルギーの一方向への偏りを示した(Figure 7と説明)。
なぜこのような差が生じるのか
BF16x9はFP32の入力値を3つのBF16成分に分け、9組の積を計算してFP32で合算する(cuBLASドキュメント)。TF32x3は入力値を大きな成分と近似後の残差に分け、小さな残差同士の積を除く3つの積だけをFP32で累積する(アルゴリズムの説明)。
PETは予測エネルギーを微分して力を求める。このためTF32x3はニューラルネットワーク層の入力に伝わる微分値の計算にも適用され、エネルギーと力の両方で同じ演算経路を使う(実装の説明)。
選択の基準
BF16x9はCUDA 12.9以降、GPUアーキテクチャの対応番号であるコンピュートケイパビリティ10.0・10.3でサポートされる。CUBLAS_EMULATE_SINGLE_PRECISION=1で有効にすると、互換性のあるPyTorchの行列演算がこの経路を利用できる(対応条件)。
A100のTF32x3には別途実装が必要だ。NVIDIAはPETのnn.Linearを、CUTLASSカーネルを呼び出すTF32Linearに置き換えた。原文の主要な演算子設定はCUTLASSサンプル27にもある。
cutlass::arch::OpMultiplyAddFastF32PET高速化の実益は、行列乗算の最高速度ではなく、安定して完了するシミュレーションの全体時間にある。