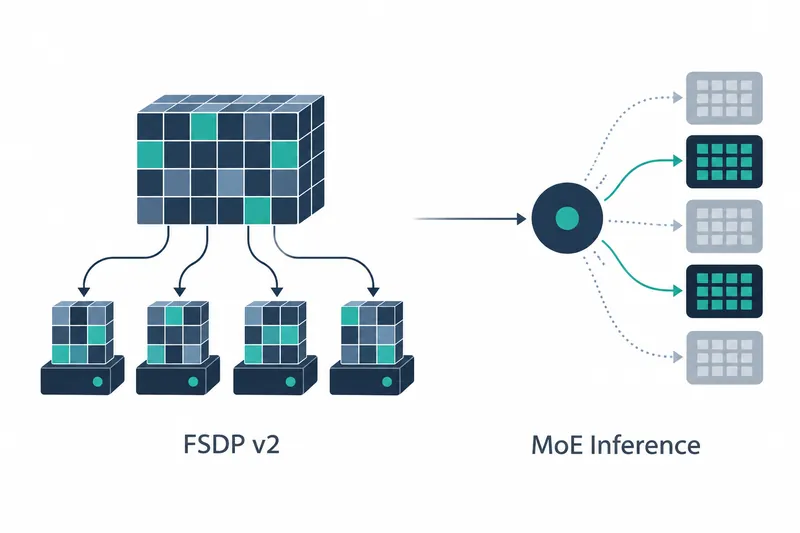
NVIDIA 发布了 Megatron Core 0.20.0,面向在多个设备上分布式训练和部署大型模型的开发团队。在训练方面,可以更细致地选择模型分工配置;在推理方面,新增了即使共同处理的请求批次发生变化,也能保持输出一致的执行路径。
1. 细化模型分工的训练配置
核心是处于实验阶段的 Megatron-FSDP v2 适配器,它是将功能接入现有训练体系的模块。FSDP 将训练所需的状态分片存储在多个设备上,此次适配器支持按输入上下文、专家模块和模型阶段划分工作的并行方式,以及混合数据并行分片。同时新增了 Megatron Bridge 集成。
混合 FSDP 可为通过设备间互联网络 NVLink 连接的区域内部和外部指定不同的分片级别。对均匀计算整个模型的稠密部分,以及选择部分专家模块进行计算的混合专家部分,也可分别配置。这样便能根据硬件互联结构和模型部分分别选择分片方式。
训练状态的保存和恢复也纳入了集成范围。新增了通过 PyTorch 分布式检查点机制保存和加载模型及优化器状态的路径。优化器是在训练中更新权重的组件,因此,这一变化不仅涉及模型,也关系到继续训练所需状态的统一处理。
2. 请求批次变化时仍保持 MoE 计算一致
混合专家模型 MoE 的推理新增了批次不变执行路径,防止同一请求因与不同请求组合处理而导致计算结果波动。支持的精度包括 16 位浮点格式 BF16,以及微缩放 8 位数值格式 MXFP8。覆盖范围包括 vLLM 的融合专家运算,即合并执行多个运算的方式,以及专家矩阵乘法,即对专家权重进行矩阵乘法的计算。
每个请求的随机种子处理也得到增强。指定随机数生成初始值的请求,不会受到批次组成、请求迁移或其他请求消耗随机数的影响。与专家计算的一致性一样,这项变化对于混合处理请求的服务复现结果十分重要。
推理引擎还支持专家张量并行,即将专家内部的张量计算分配到多个设备上。不同于训练适配器,这是为推理引擎新增的并行执行选项,因此有必要分别评估训练配置和服务配置。
3. 计算效率收益伴随着配置评估负担
新的训练适配器支持 MXFP8 运算、量化参数收集、混合精度,以及同时使用多种数值精度的优化器。量化是用更少的位数表示数值的方式。面向内存和计算效率的选项增多后,采用团队不仅要协调精度,还需同时匹配并行方式和状态恢复路径。
配置评估有明确条件。适配器的张量并行规模和专家张量并行规模必须分别为 1,且优化器检查点功能目前不支持专家并行布局。
对于受支持的稠密模型配置,还新增了用 CUDA 图捕获和重放整个训练迭代的功能,即将 GPU 工作序列打包后再次执行。在推理方面,保留 vLLM 专家矩阵乘法缓冲区以用于图执行;按照公司的公告,融合 MoE 路径的性能改进也被列入此次发布的变更清单。
4. 减少存储和连接处理造成的推理阻塞
在运维方面,为生成的词元做存储准备的工作被移到了推理循环之外。这调整了检查点写入缓慢时导致解码停顿的路径,重点是在处理结果存储的同时继续生成。
HTTP 前端可随数据并行规模扩展,分词工作也被移到了协调请求处理的事件循环之外。分词是将文本拆分为模型输入单位的过程。这些调整旨在改善接收多个请求的入口与实际推理执行之间的处理流程。
客户端连接断开时,相应请求的生成也会停止。这是为了避免用户离开后,剩余任务仍占用处理容量。如果说批次不变执行解决的是输出可复现性,那么这项变化更侧重于管理服务使用的处理容量。
此次发布对训练团队的采用价值在于分片配置的灵活性,对推理团队则在于即使请求批次和运维流程发生变化,也能保持服务执行的一致性。