엔비디아가 원자의 에너지와 힘을 예측하는 신경망 모델 PET을 재학습 없이 가속한 결과를 공개했다. 엔비디아의 평가에서는 행렬 연산뿐 아니라 원자 위치와 속도를 갱신하는 분자역학의 한 스텝 전체도 빨라져, 기존 모델로 시뮬레이션 시간을 줄일 가능성을 보였다.
이 계산은 작은 힘 오차가 스텝마다 쌓여 원자의 움직임을 흔들 수 있다. 행렬 연산 전용 GPU 연산부인 텐서코어를 쓰더라도 속도와 수치 안정성을 함께 확보해야 하는 이유다(원문).
측정 방법
엔비디아는 2,600만 파라미터 PET-MAD로 192원자 물 상자와 이를 확장한 17,280원자 구조를 평가했다. BF16x9는 Blackwell B300, TF32x3는 A100에서 측정했다. 행렬 곱셈은 각 GPU의 기본 FP32 실행을, BF16x9 분자역학 스텝은 컴파일된 FP32를 기준으로 삼았다(측정 방법).
결과
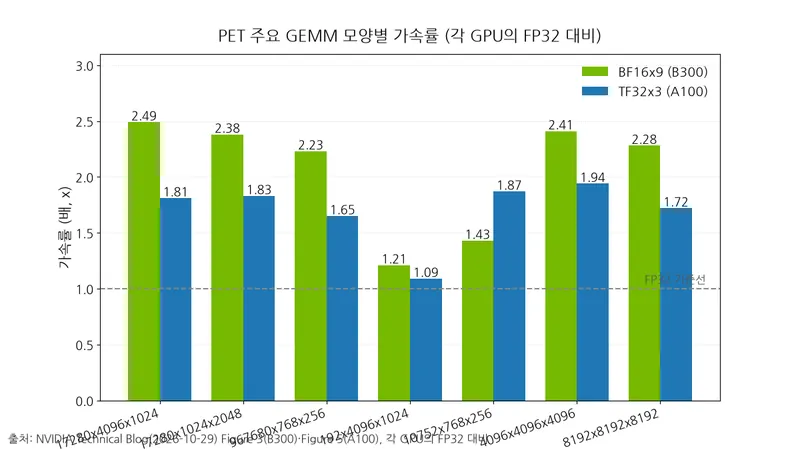
행렬 곱셈(GEMM)의 가속률은 장치별로 나눠 봐야 한다.
표: B300의 BF16x9 GEMM 가속률
조건: PET-MAD 26M, Blackwell B300의 native FP32 대비, NVIDIA Figure 3의 막대값
단위: 배
| GEMM 모양 MxNxK | BF16x9 B300 |
|---|---|
| 17280x4096x1024 | 2.49 |
| 17280x1024x2048 | 2.38 |
| 967680x768x256 | 2.23 |
| 192x4096x1024 | 1.21 |
| 10752x768x256 | 1.43 |
| 4096x4096x4096 | 2.41 |
| 8192x8192x8192 | 2.28 |
표: A100의 TF32x3 GEMM 가속률
조건: PET-MAD 26M, A100의 native FP32 대비, NVIDIA Figure 5의 막대값
단위: 배
| GEMM 모양 MxNxK | TF32x3 A100 |
|---|---|
| 17280x4096x1024 | 1.81 |
| 17280x1024x2048 | 1.83 |
| 967680x768x256 | 1.65 |
| 192x4096x1024 | 1.09 |
| 10752x768x256 | 1.87 |
| 4096x4096x4096 | 1.94 |
| 8192x8192x8192 | 1.72 |
엔비디아 측정에서 B300에서는 큰 행렬의 BF16x9 가속이 두드러졌고(Figure 3), A100에서도 TF32x3가 모든 제시 모양에서 자체 FP32보다 빨랐다(Figure 5). 장치가 달라 두 기법의 우열을 뜻하지는 않는다.
BF16x9의 performant 전략은 cuBLAS가 더 빠르다고 예상할 때만 쓴다. 엔비디아 측정에서 전체 스텝은 컴파일된 FP32 대비 192원자에서 1.2배, 17,280원자에서 1.7배 빨랐다. 엔비디아가 측정한 TF32x3의 가속률은 큰 시스템에서 자체 FP32 기준 1.5배였다(Figure 4·6과 설명).
작은 시스템에서는 GPU 작업 시작 시간과 이웃 원자 처리 같은 비행렬 작업의 비중이 커 이득이 줄어든다. TF32x3는 행렬 모양·GPU에 맞춘 커널 튜닝과 모델의 정확도·물리 안정성 요구에 따른 검증이 필요하다(한계와 선택 기준).
엔비디아의 정확도 평가에서는 BF16x9가 만든 오차가 같은 모델을 실행해도 생기는 자체 변동보다 작았다. 엔비디아 측정에서 TF32x3의 힘 오차는 FP32를 재컴파일해 실행했을 때의 차이보다 약 3배였다(정밀도 분석).
539원자 합금 표면의 위치를 안정한 배치로 조정하는 구조 완화에는 PET·FIRE2·NVIDIA ALCHEMI Toolkit을 썼다. 엔비디아의 3회 반복 평가에서 FP32는 218스텝, TF32x3는 218~222스텝에 힘 허용오차 1.0×10⁻³ eV/Å에 도달했다. 엔비디아 측정에서 TF32 변환을 한 번만 하는 경로는 스텝당 더 빨랐지만 1,000스텝까지도 수렴하지 못했다(Figure 8과 설명).
엔비디아가 백금 표면에서 일산화탄소 분자를 떼어내며 평가한 시험에서도 TF32x3는 FP32의 매끄러운 에너지 곡선을 따랐다. 엔비디아가 별도로 입자 수·부피·에너지를 고정한 192원자 물의 30 ps 시뮬레이션을 평가한 결과에서는 FP32와 비슷한 에너지 변동을 보였다. 엔비디아 평가에서 단일 변환 TF32는 각각 곡선의 흔들림과 에너지가 한쪽으로 치우치는 현상을 보였다(Figure 7과 설명).
왜 이런 차이가 나나
BF16x9는 FP32 입력값을 BF16 성분 세 개로 나눠 아홉 쌍의 곱을 계산하고 FP32로 합친다(cuBLAS 문서). TF32x3는 큰 성분과 근사 뒤 남은 차이로 입력값을 나누고, 작은 차이끼리의 곱을 뺀 세 곱만 FP32로 누적한다(알고리즘 설명).
PET은 예측 에너지를 미분해 힘을 구한다. 따라서 TF32x3는 신경망 층의 입력으로 전달되는 미분값 계산에도 적용돼 에너지와 힘 모두 같은 연산 경로를 쓴다(구현 설명).
고를 때 기준
BF16x9는 CUDA 12.9 이상, GPU 아키텍처 지원 번호인 컴퓨트 카패빌리티 10.0·10.3에서 지원한다. CUBLAS_EMULATE_SINGLE_PRECISION=1로 활성화하면 호환되는 PyTorch 행렬 연산이 이 경로를 쓸 수 있다(지원 조건).
A100의 TF32x3는 별도 구현이 필요하다. 엔비디아는 PET의 nn.Linear를 CUTLASS 커널을 호출하는 TF32Linear로 바꿨다. 원문의 핵심 연산자 설정은 CUTLASS 예제 27에도 있다.
cutlass::arch::OpMultiplyAddFastF32PET 가속의 실익은 행렬 곱의 최고 속도보다 안정적으로 끝나는 시뮬레이션의 전체 시간에 있다.