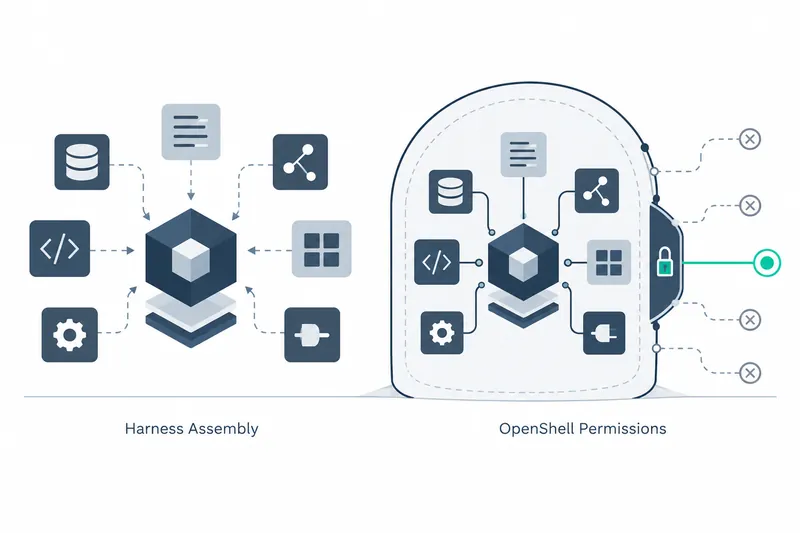
NVIDIA 发布了 NemoClaw 蓝图,这是一种为现有智能体整合模型与执行管控功能的参考配置。希望将智能体连接到内部系统的开发团队,可以保留定义工作方式的现有工具,同时管控文件和网络访问,并查看执行记录。
其核心是将智能体的工作方式和可访问范围作为不同层来管理。它不是替换现有工作框架,而是在其外围组装模型优化与访问权限策略。
1. 在现有工作框架中组装模型与运维工具
框架(Harness)用于定义智能体使用工具和推进任务的方式。NemoClaw 在开发者选定的框架基础上,结合模型、优化工具与安全运行时。运行时是在实际执行过程中管理访问权限的层。
受支持的 OpenClaw 可处理文件与应用程序,支持编写代码、运行子智能体以及跨会话保留上下文。Hermes Agent 则将重复任务中获得的模式保存为可复用的技能。
LangChain Deep Agents 提供规划、上下文管理、记忆,以及向专业子智能体委派任务的功能。已使用这些框架的开发者无需重写智能体,即可整合周边配置。
各配置均包含 Nemotron 开放模型与 NeMo 优化工具。优化工具可观测并改进执行过程,也提供路由功能,将请求发送到合适的模型,帮助改善吞吐量(单位时间内处理的任务量)、成本与可靠性。
2. 重点是调整工作环境,而非重新训练模型
NVIDIA 表示,模型与框架不匹配时,可能会反复请求上下文,或陷入没有进展的重复。这意味着优化对象不仅是模型本身,也包括模型的工作环境。
LangChain 针对 Nemotron 3 Ultra 调整了框架。其做法并非重新训练模型,而是修改提示词、工具与中间处理层。
据公司公布的信息,调整后的配置与领先的闭源模型(不公开权重的模型)相比,每次执行成本约为其 1/10,性能则接近顶尖水平。原文未提供评测任务、硬件与成本计算标准,因此可用于和实际业务直接对照的详细条件有限。
调整后的配置已纳入 LangChain 版 NemoClaw 蓝图。开发者使用相同的模型与框架组合时,无需重复调整即可应用。
3. OpenShell 通过策略约束运行中的访问范围
OpenShell 通过策略管理智能体对文件、网络、凭据和工具的访问。在 NVIDIA 介绍的基于 Hermes 的记忆型助手配置中,它管控文件系统、进程与网络访问。连接推理服务和外部工具所需的凭据则放在沙箱这一隔离执行空间之外。
即使记忆或检索上下文引发非预期行为,这一配置仍让运行时策略管控访问。也就是说,智能体记住什么,以及实际上能访问哪里,是分开管理的。
NeMo Relay 集成到该助手的会话中,收集执行记录。它会按会话开始、重置、到期等边界关闭追踪区段(将一次任务执行汇总记录的区段),并导出记录供审计与进一步优化使用。
在快速入门的 OpenClaw 设置中,先确定可选的网页搜索与消息功能,再选择网络策略。默认 Balanced 策略包含适用于开发工具仓库和所选搜索提供商的预设策略包。用于填充会话成本记录的策略包也会自动添加。
4. 通过编程智能体引导或终端开始安装
开发者可将安装启动提示词粘贴到 Cursor 或 Claude Code 等编程智能体中,也可使用终端的交互式安装流程。面向编程智能体的提示词要求先确认选项,并在安装、系统变更、大量下载或处理凭据前取得许可。
以下是原文中使用 NVIDIA 推理服务(向已训练模型请求答案的服务)的非交互式安装示例,执行过程无需用户输入。
curl -fsSL https://www.nvidia.com/nemoclaw.sh | \
  NEMOCLAW_NON_INTERACTIVE=1 \
  NEMOCLAW_ACCEPT_THIRD_PARTY_SOFTWARE=1 \
  NEMOCLAW_AGENT=openclaw \
  NEMOCLAW_PROVIDER=build \
  NVIDIA_INFERENCE_API_KEY=<your-key> \
  NEMOCLAW_SANDBOX_NAME=my-gpt-claw \
  bash
终端安装向导在预检并启动 OpenShell 网关后,获取提供商、模型、凭据与沙箱名称。确认配置摘要后完成注册,首次创建沙箱可能需要几分钟。支持两种模式的策略包可调整为只读或读写模式。
5. 获得管控与可观测能力,也需维护配置
蓝图的实际价值在于,可通过独立的运行时策略管控智能体访问实际系统的环节,并查看执行轨迹,即智能体经历的执行步骤记录。但开发团队不仅要确定框架与模型组合,还要决定网络策略、预设、搜索与消息功能以及凭据配置。因此,保留现有技术栈的便利,也伴随着管理运维配置的负担。
NemoClaw 的核心不是新框架,而是一种将模型优化与运行时权限管控一并附加到现有智能体上的部署模式。