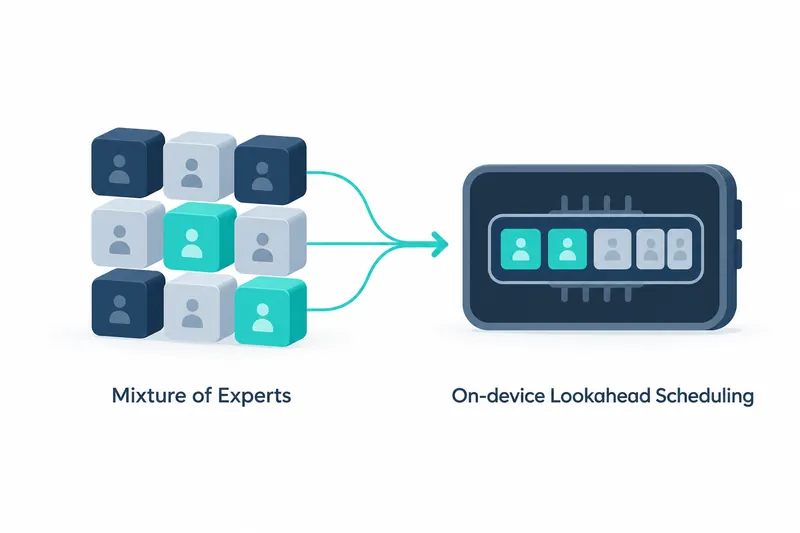
OpenBMB 为理解图像和视频的新模型加入了提前加载所需计算模块的技术。对于开发手机人工智能的开发者,这种方法无需限制模型的计算选择,就能缓解存储读取导致的响应延迟。
1. 即使只计算一部分,仍需完整权重
2026年10月12日发布的 MiniCPM-V 4.7 35B-A3B 是该系列首款 MoE 模型。MoE 是从多个称为专家的计算模块中选择一部分使用的架构。即使每次计算量较小,不同输入和层仍会使用不同专家,因此所需存储空间并不会同比缩小。
模型卡说明,如果设备内存无法容纳全部专家权重,就会在需要时从存储设备读取。这就像桌面放不下所有书,只能轮流从书架取用。如果反复等待读取,生成速度就会下降。
2. 不减少计算对象,而是改变读取顺序
Lookahead Expert Scheduling 会提前读取下一层可能使用的专家,并在加载其余专家时,先计算实际选中且已就绪的专家。即使预测失误,也会读取并计算所需专家,因此预测只改变读取和执行顺序,保留模型原本的选择。
此外,逐层量化用更少的比特表示权重,以减少存储空间和数据搬运量。它还结合了通过提前推测输出来加速生成的 DSpark。因此,不能把公布的速度仅归功于预读取技术。
其好处是不必固定使用哪些专家来限制能力,而是减少读取等待。不过,权重读取并未消失,执行流程还需要管理预测以及读取与计算的重叠。可以将其视为把成本从限制模型选择转移到执行调度上的方法。
3. 应在公开条件下解读速度数据
模型卡报告称,在 iPhone 17 Pro Max 上使用 3GB 内存,实现了每秒生成超过 13 个 token。token 是模型生成文本的单位。代码仓库另行报告,真机推理优化前后对比实现了 5倍提速,但没有依据将这一倍率乘以前述速度。
开发团队表示,在指令响应模式下,其综合得分高于 Qwen3.6 35B-A3B,推理时间也更短。但保存的原文未列出输入长度、分辨率、设备设置或倍率对比的具体机型。因此,很难将这些结果推广为其他手机的保证速度或普遍优势。
4. 视觉信息量需单独调节
视觉编码器负责将图像转换为计算用表示,它在早期压缩视觉 token,以减少后续计算量。16倍压缩通过合并 token 提高效率,4倍压缩则保留比前者多四倍的 token,以保留细节。这是一种权衡:选择更精细的图像理解,也会增加需要处理的信息。
压缩设置必须在构建聊天模板和生成输出两个阶段传入相同的值。因为前一阶段决定图像占位的数量,后一阶段决定视觉编码器的处理方式。应检查是否只设置了压缩率,却漏掉了其中一处传参。
5. 区分常规推理与端侧部署路径
常规推理是在 Transformers 中加载模型和预处理器,再将图像或视频与问题组合成聊天输入。以下原样保留模型卡中的安装命令。
pip install "transformers[torch]>=5.18.0" torchvision torchcodec视频解码器可能与部分 CUDA 版本冲突。原文建议安装替代解码器,或根据运行环境固定版本作为解决办法,因此使用视频输入时需要检查兼容性。
该安装示例是开始常规推理的路径,并非应用全部手机优化的流程。端侧部署所需的应用和源码在原文链接的独立仓库中提供说明,支持的操作系统为 iOS、Android 和 HarmonyOS。
关键不只是强调较小的计算量,而是在保留原有专家选择的同时,设计部署路径以减少设备等待权重的时间。