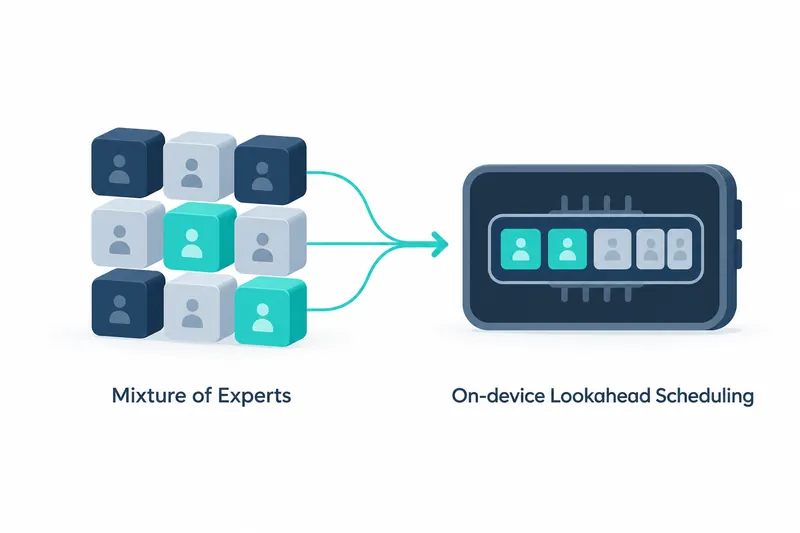
OpenBMBは、画像や動画を理解する新モデルに、必要な計算ユニットを先に読み込む技術を加えた。スマートフォン向けAIを開発する人にとって、モデルの計算対象の選択を制限せずに、ストレージの読み込みによる応答の遅れを減らす手法となる。
1. 一部だけを計算しても重み全体は必要になる
2026年10月12日に公開されたMiniCPM-V 4.7の35B-A3Bは、シリーズ初のMoEモデルだ。MoEは、複数の計算ユニットであるエキスパートの一部を選んで使う構造である。一度に行う計算が少なくても、入力や層によって異なるエキスパートを使うため、必要な保存容量まで同じように小さくなるわけではない。
モデルカードによると、端末のメモリにエキスパートの重みをすべて収められない場合、必要に応じてストレージから読み込むという。机に本をすべて広げられず、本棚から交互に取り出すようなものだ。この読み込み待ちが繰り返されると、生成速度が低下する。
2. 計算対象を減らさずに読み込み順を変える
Lookahead Expert Schedulingは、次の層で使う可能性が高いエキスパートを先読みし、実際に選ばれたもののうち準備できたものから計算しながら残りを読み込む。予測が外れても必要なエキスパートは読み込んで計算するため、予測が変えるのは読み込みと実行の順序だけで、モデル本来の選択は維持される。
さらに、重みを少ないビット数で表す層別の量子化で、保存容量とデータ転送量を減らす。出力を先に推測して生成を高速化するDSparkも組み合わせる。そのため、公開された速度を先読み技術だけの効果と解釈してはならない。
利点は、使うエキスパートを固定して能力を制限するのではなく、読み込み待ちを減らす点にある。ただし、重みの読み込みがなくなるわけではなく、実行経路では予測と、読み込み・計算の重なりを管理する必要がある。負担をモデルの選択制限から実行スケジュールの管理へ移す手法と捉えられる。
3. 速度の数値は公開された条件の範囲で読む
モデルカードは、iPhone 17 Pro Maxでメモリ3GBを使い、毎秒13トークン以上を生成したと報告している。トークンはモデルが文章を生成する単位だ。リポジトリでは別途、実機の推論最適化前後の比較で5倍の高速化を報告しているが、この倍率を先の速度に掛ける根拠はない。
開発チームによると、指示応答モードではQwen3.6 35B-A3Bより総合スコアが高く、推論時間も短いという。ただし、保存された原文テキストには、入力長・解像度・端末設定や、倍率比較に使った具体的な機種が示されていない。この結果を、他のスマートフォンでの保証速度や汎用的な優位性にまで広げるのは難しい。
4. 視覚情報の量は別途調整する
視覚エンコーダー、つまり画像を計算用の表現に変換する部分は、初期段階で視覚トークンを圧縮し、後段の計算量を減らす。16倍圧縮はトークンをまとめて効率を高め、4倍圧縮はそれより4倍多いトークンを残して細部を保持する。細かな画像理解を選べば、処理する情報も増えるというトレードオフがある。
圧縮設定は、チャットテンプレートを作る段階と出力を生成する段階の両方に、同じ値を渡す必要がある。前者は画像を入れる位置の数を、後者は視覚エンコーダーの処理を決めるためだ。圧縮率を決めるだけでなく、片方への指定を忘れないよう確認する必要がある。
5. 通常の推論と端末への導入経路を区別する
通常の推論では、Transformersでモデルと前処理器を読み込み、画像や動画と質問をチャット入力にまとめる。以下はモデルカードのインストールコマンドをそのまま示したものだ。
pip install "transformers[torch]>=5.18.0" torchvision torchcodec動画デコーダーは一部のCUDAバージョンと競合する可能性がある。原文は代替デコーダーのインストールや、実行環境に合わせたバージョン固定を回避策として案内しているため、動画入力を使う際は互換性を確認する必要がある。
このインストール例は通常の推論を始めるための経路であり、スマートフォン向け最適化をすべて適用する手順ではない。端末導入用のアプリとソースは、原文からリンクされた別のリポジトリで案内されており、対応OSはiOS・Android・HarmonyOSである。
要点は、計算量の少なさだけを掲げるのではなく、本来のエキスパート選択を維持したまま、端末で重みを待つ時間を減らすよう導入経路を設計した点にある。