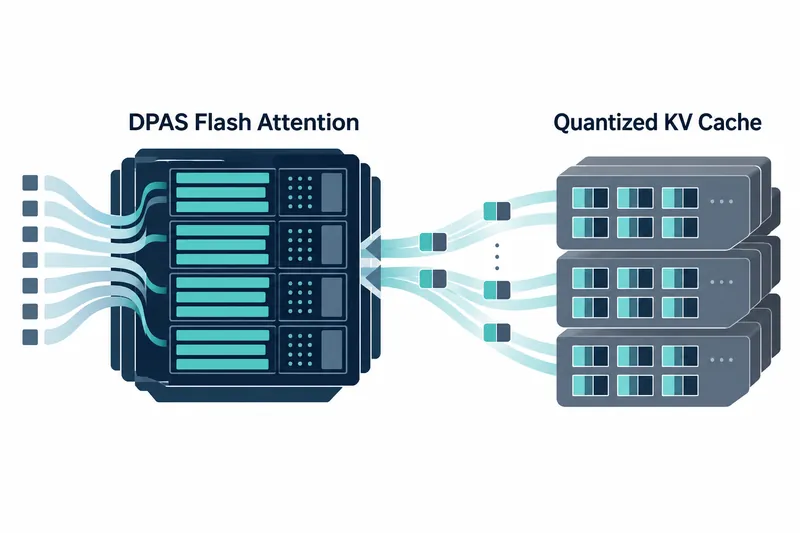
键值缓存保存生成过程中重复使用的中间信息。llama.cpp 新增了一条 GPU 运算路径,无需将压缩的键值缓存整体解压即可用于生成回答。在受支持的 GPU 上运行本地语言模型的开发者,可以减少每次生成时重复进行的缓存转换工作。
1. 不再解压,而是直接读取已存储的缓存
2026年10月29日发布的 b11980,其核心是在 SYCL 后端新增了可降低内存使用量的闪电注意力内核。SYCL 是面向异构处理器的并行计算标准。
此前,需要逐元素解压量化缓存,或在每次调用时将整个缓存转换为 16 位浮点数再计算。新路径更像是按所需状态直接读取,而不是把压缩的行李全部摊开。支持的键值缓存格式为 q4_0 和 q8_0。
核心运算使用矩阵计算功能 DPAS,查询与键的乘积采用 8 位与 4 位整数的组合,或采用 8 位整数之间的运算。值是注意力中用于加权求和的信息,值与概率的乘积仍使用可表示小数的 16 位浮点数格式。
2. 确认模型配置是引入生成路径的起点
发布说明列出支持头维度 64~512、分组查询注意力最高 32,以及将注意力固定在初始词元上的注意力汇聚机制。头维度是单个注意力头的向量宽度,分组查询注意力让多个查询头共享键值。不过,后续变更条目也注明移除了对头维度 192 的支持。新路径面向逐个生成词元的阶段,以及查询词元数为 1~31 的小批次,提示词处理仍保留现有内核。
3. 相同生成条件下吞吐量提高
项目发布说明给出了在 B580 上使用 Llama 3.1 8B 模型测得的生成性能。
模型量化为 Q4_K_M,键值缓存格式为 q4_0,上下文设为 16K,生成词元数设为 128。根据项目公布的数据,在这些条件下,吞吐量从每秒 31.3 个词元提高到 54.2 个词元。
表:应用新路径前后的生成吞吐量
条件:B580、Llama 3.1 8B Q4_K_M、q4_0 键值缓存、16K 上下文、生成 128 个词元
单位:词元/秒
| 类别 | 生成吞吐量 |
|---|---|
| 变更前 | 31.3 |
| 变更后 | 54.2 |
图表:生成吞吐量对比(条件与单位同上表)
变更前 | ████████████████            31.3
变更后 | ███████████████████████████ 54.2
按原文数据计算,变更后的吞吐量约为变更前的 1.73 倍,增幅约为 73.2%。这意味着在相同条件下,每秒生成的词元数增加。开发者在自己的环境中验证时,也可据此同时对齐硬件、模型量化、缓存格式、上下文长度和生成量。
发布说明还列出了测试结果。FLASH_ATTN_EXT 测试共 4584 项,其中 4582 项通过;说明指出,失败的 2 项在现有开发分支中也同样失败。这些与吞吐量一同公布的结果,可供评估新路径的计算行为时参考。
4. 避免重复转换的设计转化为生成性能
旧路径每次调用都要转换整个缓存,新路径通过直接对已存储的块进行运算来避免这项工作。项目给出的生成吞吐量提升,为考察这种避免转换的设计效果提供了依据。
发行列表中的 Ubuntu x64 SYCL 软件包分为 32 位和 16 位浮点数版本,也包含 Windows x64 软件包。已使用该后端的开发者,可以从相应发行包和自身的缓存配置入手考察新路径。
发布说明还提供了关闭新路径的设置。将环境变量设为以下值即可禁用该路径,便于在引入后观察生成行为时保留选择余地。
GGML_SYCL_FA_DPAS=0b11980 的价值在于提供了一条 SYCL 运算路径,减少使用量化缓存的生成任务中的重复转换,并将其转化为实际的吞吐量提升。