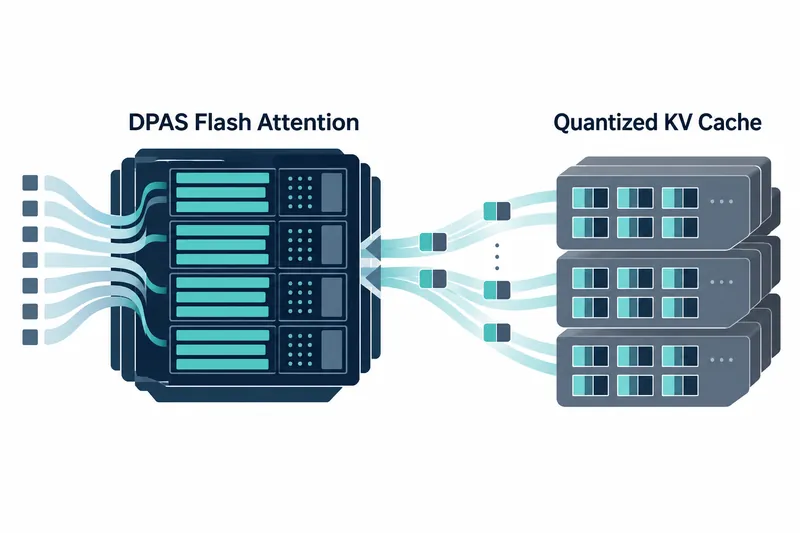
キー・バリューキャッシュは、生成中に再利用する中間情報を保存する。llama.cppは、圧縮されたキー・バリューキャッシュを丸ごと展開せずに応答生成に使うGPU演算経路を追加した。対応GPUでローカル言語モデルを実行する開発者は、生成のたびに繰り返していたキャッシュ変換を減らせる。
1. 展開せずに保存済みのキャッシュを直接読む
2026年10月29日に公開されたb11980の要点は、異種プロセッサ向けの並列計算標準であるSYCLのバックエンドに追加された、メモリ使用量を抑えるフラッシュアテンションカーネルだ。
従来は量子化したキャッシュを要素ごとに展開するか、呼び出すたびにキャッシュ全体を16ビット浮動小数点数に変換して計算していた。新経路は、圧縮された荷物をすべて広げるのではなく、必要な状態のまま読む方式に近い。対応するキー・バリューキャッシュ形式はq4_0とq8_0だ。
主要な演算には行列計算機能のDPASを使い、クエリとキーの積を8ビット・4ビット整数の組み合わせ、または8ビット整数同士で計算する。アテンションの加重和に使う情報であるバリューと確率の積は、小数を表す数値形式の16ビット浮動小数点数に維持する。
2. モデル構成の確認が生成経路導入の出発点になる
リリースノートは、アテンション単位一つのベクトル幅であるヘッドサイズ64~512、複数のクエリヘッドでキー・バリューを共有するグループ化クエリアテンション最大32、初期トークンに注意を固定する手法であるアテンションシンクへの対応を説明している。ただし、後続の変更項目にはヘッドサイズ192の対応削除も記載されている。新経路は、トークンを一つずつ生成する段階とクエリトークンが1~31個の小さなバッチを対象とし、プロンプト処理には既存のカーネルを維持する。
3. 同じ生成条件でスループットが向上した
プロジェクトのリリースノートは、B580でLlama 3.1 8Bモデルを使って測定した生成性能を示した。
モデルの量子化はQ4_K_M、キー・バリューキャッシュ形式はq4_0で、コンテキストは16K、生成トークン数は128に設定した。この条件で、プロジェクトの発表によるスループットは毎秒31.3トークンから54.2トークンに向上した。
表:新経路適用前後の生成スループット
条件:B580、Llama 3.1 8B Q4_K_M、q4_0キー・バリューキャッシュ、16Kコンテキスト、生成128トークン
単位:トークン/秒
| 区分 | 生成スループット |
|---|---|
| 変更前 | 31.3 |
| 変更後 | 54.2 |
チャート:生成スループットの比較(上の表と同じ条件・単位)
変更前 | ████████████████            31.3
変更後 | ███████████████████████████ 54.2
原文の数値で計算すると、変更後のスループットは変更前の約1.73倍で、約73.2%増加した。同じ条件で毎秒生成するトークン数が増えた結果だ。開発者が自身の環境で確認する際も、ハードウェアだけでなくモデルの量子化、キャッシュ形式、コンテキスト長、生成量を合わせて比較する参考になる。
検査結果も併記された。FLASH_ATTN_EXT検査は計4584件中4582件が通過し、失敗した2件は既存の開発ブランチでも同じだったとリリースノートは説明している。スループットとともに示されたこの結果は、新経路の計算動作を検討する際の参考資料となる。
4. 反復変換を避ける設計が生成性能につながる
従来の経路が呼び出しごとにキャッシュ全体の変換に費やしていた作業を、新経路は保存済みのブロックを直接演算することで回避する。プロジェクトが示した生成スループットの向上は、この変換回避設計の効果を検討する根拠となる。
配布一覧では、Ubuntu x64向けSYCLパッケージが32ビット・16ビット浮動小数点数用に分かれており、Windows x64向けパッケージも含まれる。すでにこのバックエンドを使う開発者なら、該当する配布版と自身のキャッシュ構成を出発点に新経路を検討できる。
リリースノートは、新経路をオフにする設定も提供している。環境変数に次の値を指定するとこの経路を無効化でき、導入後の生成動作を調べる際にも選択肢を確保できる。
GGML_SYCL_FA_DPAS=0b11980の価値は、量子化キャッシュを使う生成処理で反復変換を減らし、実際のスループット向上につなげるSYCL演算経路を用意した点にある。