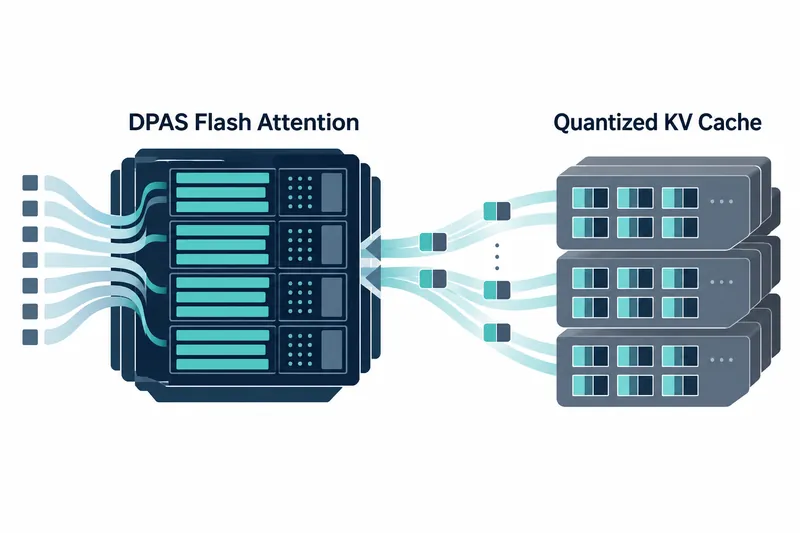
키·값 캐시는 생성 중 재사용하는 중간 정보를 저장한다. llama.cpp는 압축된 키·값 캐시를 통째로 풀어 쓰지 않고 응답 생성에 활용하는 GPU 연산 경로를 추가했다. 지원되는 GPU로 로컬 언어모델을 실행하는 개발자는 생성할 때마다 반복되던 캐시 변환 작업을 줄일 수 있다.
1. 압축을 푸는 대신 저장된 캐시를 바로 읽는다
2026년 10월 29일 공개된 b11980의 핵심은 이기종 프로세서용 병렬 계산 표준인 SYCL 백엔드에 추가된 메모리 사용을 줄이는 플래시 어텐션 커널이다.
기존에는 양자화한 캐시를 원소별로 풀어 쓰거나, 호출할 때마다 캐시 전체를 16비트 실수로 바꿔 계산했다. 새 경로는 압축된 짐을 모두 펼쳐 놓는 대신 필요한 상태 그대로 읽는 방식에 가깝다. 지원하는 키·값 캐시 형식은 q4_0과 q8_0이다.
핵심 연산에는 행렬 계산 기능인 DPAS를 사용하며, 쿼리와 키의 곱을 8비트·4비트 정수 조합 또는 8비트 정수끼리 계산한다. 어텐션에서 가중합에 쓰는 정보인 밸류와 확률의 곱은 소수를 표현하는 숫자 형식인 16비트 실수로 유지한다.
2. 모델 구성 확인은 생성 경로 도입의 출발점이다
릴리스 노트는 어텐션 단위 하나의 벡터 폭인 헤드 크기 64~512, 여러 쿼리 헤드가 키·값을 공유하는 그룹 쿼리 어텐션 최대 32와 초기 토큰에 주의를 고정하는 기법인 어텐션 싱크 지원을 설명하지만, 후속 변경 항목에는 헤드 크기 192 지원 제거도 적혀 있다. 새 경로는 토큰을 한 개씩 생성하는 단계와 쿼리 토큰이 1~31개인 작은 배치를 대상으로 하며, 프롬프트 처리는 기존 커널을 유지한다.
3. 같은 생성 조건에서 처리량이 높아졌다
프로젝트 릴리스 노트는 B580에서 Llama 3.1 8B 모델로 측정한 생성 성능을 제시했다.
모델 양자화는 Q4_K_M, 키·값 캐시 형식은 q4_0이며, 컨텍스트는 16K, 생성 토큰 수는 128로 설정했다. 이 조건에서 처리량은 프로젝트 발표 기준 초당 31.3토큰에서 54.2토큰으로 높아졌다.
표: 새 경로 적용 전후 생성 처리량
조건: B580, Llama 3.1 8B Q4_K_M, q4_0 키·값 캐시, 16K 컨텍스트, 생성 128토큰
단위: 토큰/초
| 구분 | 생성 처리량 |
|---|---|
| 변경 전 | 31.3 |
| 변경 후 | 54.2 |
차트: 생성 처리량 비교(위 표와 동일 조건·단위)
변경 전 | ████████████████            31.3
변경 후 | ███████████████████████████ 54.2
원문 수치로 계산하면 변경 후 처리량은 변경 전의 약 1.73배로, 약 73.2% 증가했다. 같은 조건에서 초당 생성하는 토큰 수가 늘어난 결과다. 개발자가 자신의 환경에서 확인할 때도 하드웨어뿐 아니라 모델 양자화, 캐시 형식, 컨텍스트 길이와 생성량을 함께 맞춰 보는 데 참고할 수 있다.
검사 결과도 함께 실렸다. FLASH_ATTN_EXT 검사는 총 4584건 가운데 4582건이 통과했으며, 실패한 2건은 기존 개발 브랜치에서도 같았다고 릴리스 노트는 설명했다. 처리량과 함께 제시된 이 결과는 새 경로의 계산 동작을 검토할 때 참고할 자료다.
4. 반복 변환을 피하는 설계가 생성 성능으로 이어진다
기존 경로가 호출마다 캐시 전체를 변환하는 데 쓰던 작업을 새 경로는 저장된 블록에 직접 연산하는 방식으로 피한다. 프로젝트가 제시한 생성 처리량 개선은 이 변환 회피 설계의 효과를 살펴볼 근거다.
배포 목록에는 Ubuntu x64용 SYCL 패키지가 32비트·16비트 실수용으로 나뉘어 있고, Windows x64용 패키지도 포함돼 있다. 이미 이 백엔드를 사용하는 개발자라면 해당 배포판과 자신의 캐시 구성을 출발점으로 새 경로를 살펴볼 수 있다.
릴리스 노트는 새 경로를 끄는 설정도 제공한다. 환경 변수에 다음 값을 지정하면 해당 경로를 비활성화할 수 있어, 도입 후 생성 동작을 살펴볼 때 선택권을 유지할 수 있다.
GGML_SYCL_FA_DPAS=0b11980의 가치는 양자화 캐시를 쓰는 생성 작업에서 반복 변환을 덜어내고, 이를 실제 처리량 개선으로 연결하는 SYCL 연산 경로를 마련한 데 있다.