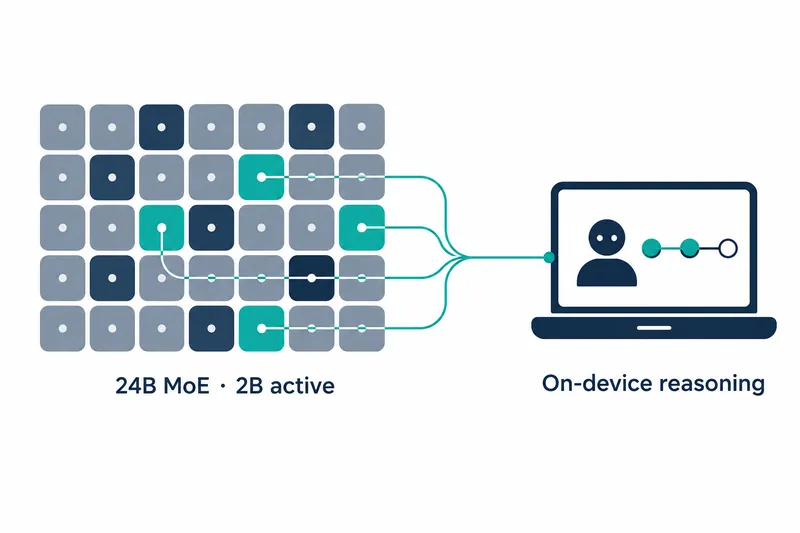
Liquid AI 发布了一款仅使用部分模型参与计算、并在回答前进行推理的模型。对于开发在设备内调用外部工具来完成任务的 AI 的开发者而言,减少计算负担的选择又多了一种。
1. 仅计算部分参数,读取更长上下文
LFM2.5-24B-A2B 的总参数量为 240亿,每个 token 激活的参数为 24.5亿。名称中的“2B”是简写,token 是模型处理文本的单位。混合专家架构 MoE 类似于只派出多个工作组中的一部分,每个块从 64个专家中选出 4个。
相比上一代 LFM2-24B-A2B,单次处理的上下文从约 3万2千 token 增至 13万1,072 token。词表也从约 6万5千扩展至 12万8千,旨在改善韩文等非拉丁文字的处理。
原文说明,与上一代不同,该模型始终在回答前进行推理。对话模板在开始回复时会直接插入推理起始标签。这是独立于长上下文支持的回复方式变化。
2. 设备端速度需结合测量条件看待
公司在自有设备测试环境中使用了 llama.cpp、Q4_K_M 量化和 4千 token 的输入上下文。量化是用更少的比特表示权重,以减少存储空间的方法。
公司表示,在上述条件下,苹果 M5 Max 每秒生成 184 token,AMD Ryzen AI Max+ 395 每秒生成 114 token。其速度最高为参测模型中第二名的 1.7倍,但不能将这一结果推广至其他设备或配置。
3. 本地运行与工具连接是两个步骤
本地运行可使用 GGUF 格式和 llama.cpp。以下原样保留转换版模型卡中的运行示例。
llama-cli -hf LiquidAI/LFM2.5-24B-A2B-GGUF \
    --temp 0.1 --top-k 50 --repeat-penalty 1.05
推荐的生成设置也包含在各文件的元数据中,并作为默认值应用。连接智能体时,需将模型作为本地服务器运行,并配置任务管理程序通过兼容 OpenAI 的 API 接入。
工具使用依次包括提供工具定义、生成调用、执行调用并返回结果,以及给出最终回答。模型生成调用语句与程序实际执行工具是两回事。默认调用语句是 Python 形式的列表,也可通过系统指令要求输出 JSON 格式。
4. 工具使用得分不能代替知识能力
模型卡中的对比对象之一是 Qwen3.6-35B-A3B。下面两项评测均通过 vLLM 进行,但生成条件不同,因此只能在各项评测内部比较两个模型。
在智能体任务评测 LiveClaw 中,温度为 1.0、最大输出为 8,192 token 时,该模型得分为 48.09,对比模型为 38.19。温度是控制输出选择随机性的数值。
而在知识评测 GPQA Diamond 中,温度为 0.6、最大输出为 32,768 token 时,该模型得分为 74.42,低于对比模型的 83.69。公司也不建议将其单独用于以知识为主的任务,并建议结合检索或网页搜索。
代码修改评测 SWE-Bench Verified 在 OpenCode 中进行,温度为 0.6,最大输出为 32,768 token。该模型得分为 51.00,对比模型为 66.20。工具调用的优势并不意味着在代码任务整体上占优。
5. 应区分计算节省与部署成本
仅激活部分参数的收益体现在每个 token 的计算上,并不意味着全部权重的存储负担也会消失。转换版页面上的 4位文件大小为 13.6GB 和 14.5GB。由于模型还会生成推理内容,除了回答长度,还需关注推理部分;目前未提供各任务的总生成量。
在 4位版本中,Q4_0 转换版是经过训练以恢复量化所损失精度的 QAD 检查点。不能将该文件大小直接视为运行所需内存,目前也未提供不同上下文长度下的总内存需求。
两份模型卡的许可证均标为 lfm1.0。许可证设有以年收入 1千万美元为标准的商业使用限制,但符合资格的非营利组织进行非商业或研究使用时,不适用该标准。企业部署时,无论是否可下载,都应核查这一条款。
与其将该模型视为通用知识问答的替代品,不如将其视为在设备内结合推理与工具执行时值得优先考察的候选。