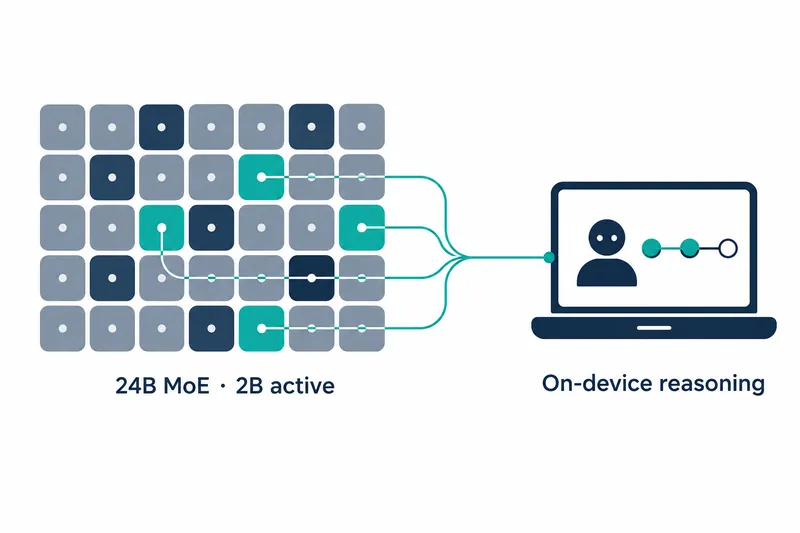
Liquid AIが、モデル全体の一部だけを計算に使い、回答前に推論するモデルを公開した。デバイス内で外部ツールを呼び出して作業するAIを作る開発者にとって、計算負担を減らす選択肢が増えた。
1. 一部だけを計算し、より長い文脈を読む
LFM2.5-24B-A2Bの全パラメータは240億で、トークンごとに活性化されるパラメータは24.5億だ。名前の「2B」は要約表記で、トークンはモデルが文章を処理する単位だ。混合エキスパート構造のMoEは複数の作業班のうち一部だけを投入する方式で、各ブロックのエキスパート64個から4個を選ぶ。
前モデルのLFM2-24B-A2Bより、一度に扱う文脈が約3万2千トークンから13万1,072トークンに増えた。語彙も約6万5千個から12万8千個に拡張し、ハングルなど非ラテン文字の処理改善を狙った。
原文では、前モデルとは異なり、回答前に常に推論するモデルだと説明している。会話フォーマットで応答を開始する際に、推論開始タグを直接入れる。これは長い文脈への対応とは別の、応答方式の変化だ。
2. デバイス内の速度は測定条件と併せて見る
同社独自のデバイス測定環境で、llama.cppとQ4_K_M量子化、入力文脈4千トークンを使用した。量子化は重みをより少ないビットで表現し、保存容量を減らす方式だ。
この条件で、Apple M5 Maxは毎秒184トークン、AMD Ryzen AI Max+ 395は毎秒114トークンを生成したと同社は述べた。比較したモデルの中で次点より最大1.7倍速いという結果であり、他の機器や設定の速度に一般化はできない。
3. ローカル実行とツール接続は別の段階だ
ローカル実行にはGGUF形式とllama.cppを使える。以下は変換版のモデルカードに掲載された実行例そのままだ。
llama-cli -hf LiquidAI/LFM2.5-24B-A2B-GGUF \
    --temp 0.1 --top-k 50 --repeat-penalty 1.05
推奨の生成設定は各ファイルのメタデータにも含まれ、デフォルト値として適用される。エージェントと接続する際はモデルをローカルサーバーとして起動し、作業を管理するプログラムがOpenAI互換APIで接続するよう設定する。
ツール利用は、ツール定義の提供、呼び出しの生成、呼び出しの実行と結果の返却、最終回答の順に進む。モデルが呼び出し文を作ることと、プログラムが実際にツールを実行することは別だ。標準の呼び出し文はPython形式のリストで、システム指示でJSON形式の出力を求めることもできる。
4. ツール活用のスコアは知識能力の代わりにはならない
モデルカードの比較対象の一つはQwen3.6-35B-A3Bだ。以下の二つの評価はいずれもvLLMで行われたが、生成条件が異なるため、各評価内でのみ両モデルを比較すべきだ。
エージェント作業の評価であるLiveClawでは、温度1.0、出力最大8,192トークンの条件で、このモデルは48.09点、比較モデルは38.19点だった。温度は出力選択のランダム性を調節する値だ。
一方、知識評価のGPQA Diamondでは、温度0.6、出力最大32,768トークンの条件で74.42点となり、比較モデルの83.69点を下回った。同社も知識中心の作業での単独利用を推奨せず、検索やウェブ検索を組み合わせるよう案内している。
コード修正評価のSWE-Bench Verifiedは、OpenCodeで温度0.6、出力最大32,768トークンとして評価した。スコアはこのモデルが51.00、比較モデルが66.20だった。ツール呼び出しの強みが、コード作業全般での優位を意味するわけではない。
5. 計算削減と配備コストを区別する必要がある
一部のパラメータだけを活性化する利点はトークン当たりの計算にあり、重み全体の保存負担までなくなるわけではない。変換版ページの4ビットファイルのサイズは13.6GBと14.5GBだ。推論も生成するモデルなので、回答の長さだけでなく推論部分も確認する必要があるが、作業別の総生成量は示されていない。
4ビットのうちQ4_0変換版は、量子化で失った精度を回復するよう学習したQADチェックポイントだ。このファイルサイズをそのまま実行に必要なメモリとみなすことはできず、文脈長ごとの総メモリ要件は示されていない。
両モデルカードのライセンス表記はlfm1.0だ。ライセンスには年商1千万ドルを基準とする商用利用制限があり、資格を満たす非営利組織の非商用・研究利用にはこの基準を適用しない。企業での配備では、ダウンロードできるかとは別にこの条項を確認する必要がある。
このモデルは、汎用的な知識回答の代替というより、デバイス内で推論とツール実行を組み合わせる際に、優先的に検討する候補に近い。